パソコンやスマートフォンの処理速度を支えるCPUには、命令を効率よく実行するための多彩な仕組みがあります。
その代表例がアウトオブオーダー実行です。
プログラムに書かれた命令順をそのまま守るだけでは、データ待ちやメモリ待ちによって演算装置が遊んでしまう場面があります。
そこでCPUは、先に実行できる命令を見つけて順番を入れ替え、内部の資源を有効に使います。
アウトオブオーダー実行は、正しい計算結果を保ちながらCPU内部の待ち時間を減らす技術と考えると理解しやすいでしょう。
本記事では、パイプライン処理との関係、命令の並び替え、依存関係、リオーダーバッファ、性能向上の理由まで、CPUの基本から順に解説します。
アウトオブオーダー実行の意味
それではまずアウトオブオーダー実行の意味について解説していきます。
命令順を固定しないCPU内部の処理
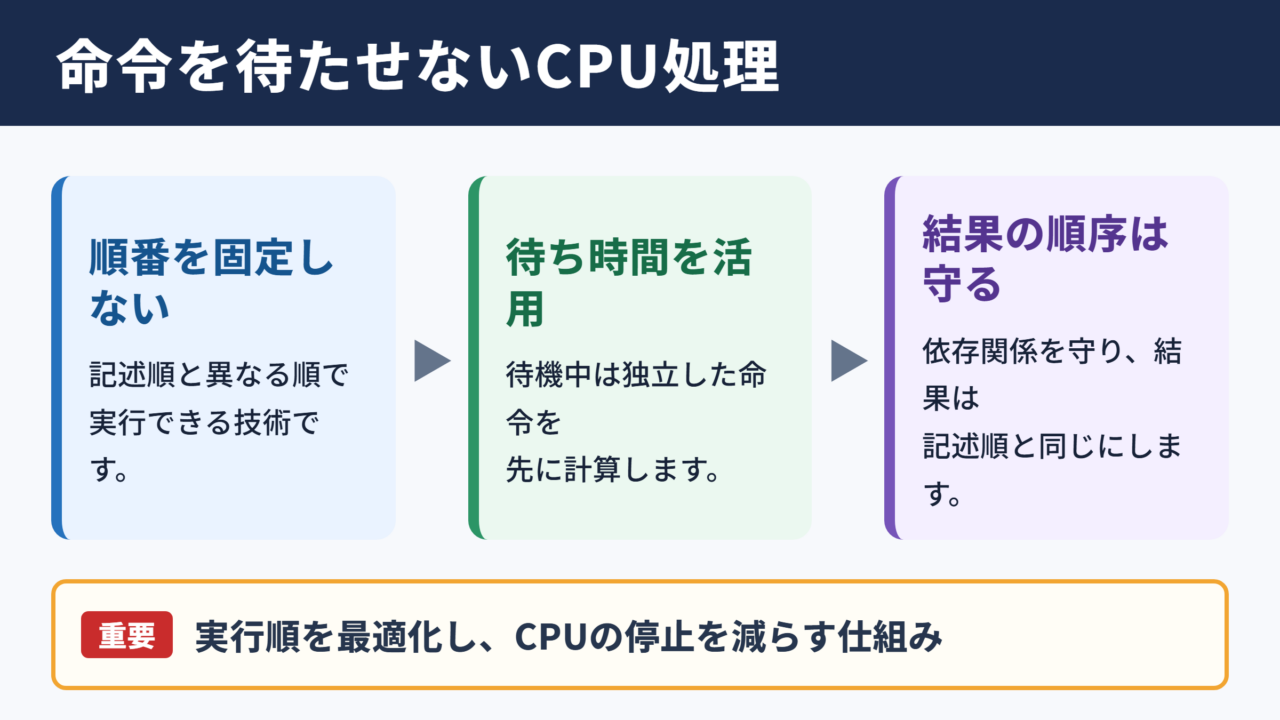
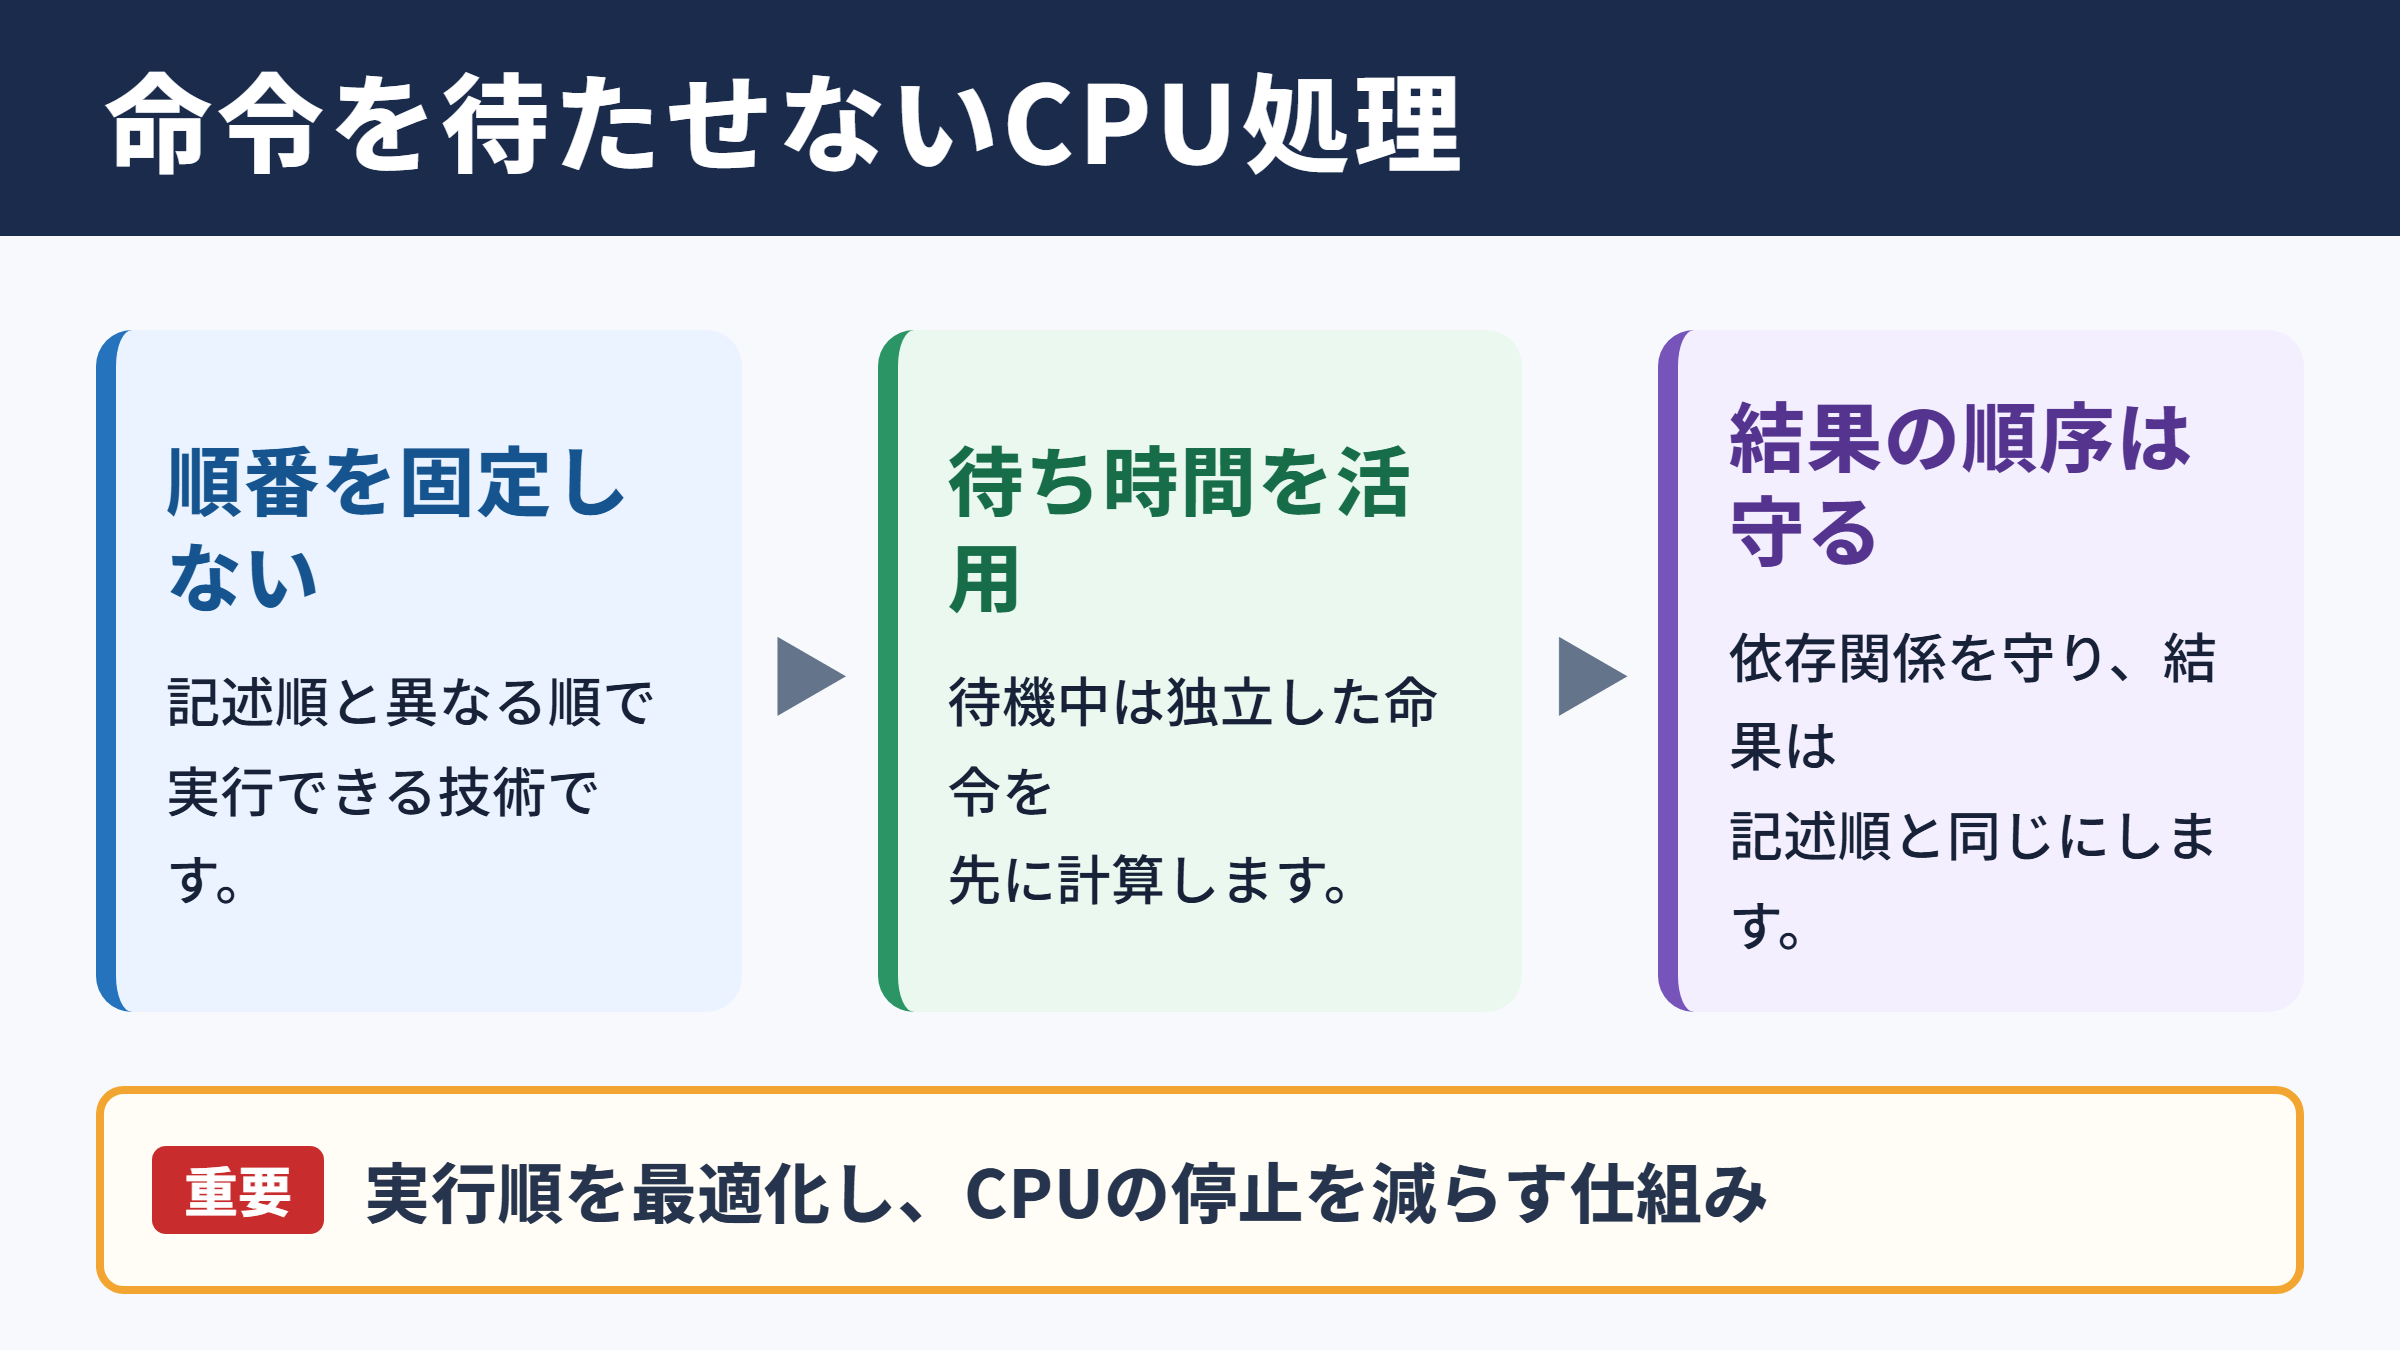
アウトオブオーダー実行とは、CPUがプログラムに書かれた順番とは異なる順番で、命令を実行する技術です。
英語ではOut of Order Executionと呼ばれ、略してOoO実行と表記されることもあります。
ただし、CPUが自由気ままに命令を処理しているわけではありません。
プログラムから見た最終的な結果は、命令が記述順に完了した場合と同じになるよう制御されています。
ここで重要なのは、実行する順番と、結果を確定させる順番が必ずしも同じではない点です。
たとえば、ある命令が主記憶からデータを読むまで待っている間に、そのデータを使わない後続命令を先に計算できます。
このように空いた演算回路を活用するため、CPUは命令の準備状況とデータの依存関係を継続的に確認します。
待機中の命令を飛ばして実行可能な命令を前倒しすることが、アウトオブオーダー実行の中心的な役割です。
アウトオブオーダー実行は命令の意味を変更する技術ではありません。
命令どうしの依存関係を守りつつ、CPU内部での作業順を最適化して、演算器やパイプラインの停止を減らす仕組みです。
インオーダー実行との違い
比較対象となるのがインオーダー実行です。
インオーダー実行では、原則として命令をプログラム順に発行し、前の命令が止まると後ろの命令も進めにくくなります。
構造が比較的単純で、消費電力や設計規模を抑えやすい点は利点でしょう。
一方で、キャッシュミスや除算のように時間のかかる処理があると、後続に独立した加算命令があっても待たせることがあります。
アウトオブオーダー実行では、先行命令の完了を待つ必要がない独立命令を選び、演算ユニットへ割り当てます。
その結果、1クロックあたりに処理できる命令数を増やしやすくなります。
| 比較項目 | インオーダー実行 | アウトオブオーダー実行 |
|---|---|---|
| 命令の実行順 | 基本的にプログラム順 | 依存関係の範囲で入れ替え可能 |
| 待ち時間への対応 | 先行命令の停止が影響しやすい | 独立命令を先に実行しやすい |
| 回路構成 | 比較的シンプル | スケジューラや管理機構が必要 |
| 性能の伸ばしやすさ | 命令列の影響を受けやすい | 命令レベル並列性を引き出しやすい |
| 電力と面積 | 抑えやすい傾向 | 増えやすい傾向 |
高性能なデスクトップ向けCPUやサーバー向けCPUでは、アウトオブオーダー実行が広く採用されています。
ただし、組み込み用途や電力効率を特に重視する用途では、インオーダー実行に近い設計が選ばれる場合もあります。
高速化につながる理由
CPUの高速化では、クロック周波数だけでなく、各クロックをどれだけ無駄なく使えるかが大切です。
プログラムには、すぐに答えが出る整数加算もあれば、メモリから値を取得するまで待つロード命令もあります。
ロード命令の結果を使う後続命令は待つ必要がありますが、無関係な命令まで停止させる理由はありません。
アウトオブオーダー実行は、この隙間に別の仕事を入れることで処理効率を高めます。
命令Aがメモリから値を読む処理で待機しているとします。
命令Bが命令Aの値を使わない整数加算なら、CPUは命令Bを先に実行できます。
命令Aの結果が届いた後に依存する命令を進めれば、全体の待機時間を短縮できます。
この考え方は、工場で部品待ちの工程を止めたままにせず、先に着手できる別工程を進める考え方に近いものです。
CPUはごく短い時間に膨大な命令を観察し、依存関係と実行資源の空きを判断します。
命令を単純に速くするのではなく、待ち時間を他の処理で埋めるため、現実のアプリケーションで性能差が現れやすくなります。
パイプライン処理との関係
続いてはパイプライン処理との関係を確認していきます。
命令処理を分割するパイプライン
CPUは通常、命令を一度に完了させるのではなく、複数の段階に分けて処理します。
代表的な段階には、命令の読み出し、命令の解読、レジスタの読み出し、演算、メモリアクセス、結果の書き戻しなどがあります。
これがパイプライン処理です。
ベルトコンベアの各工程に別々の製品を流すように、CPUも複数の命令を同時並行で異なる段階に置けます。
パイプラインの目的は、個々の命令の時間を必ず短くすることではなく、一定時間あたりの命令処理量を増やすことです。
この処理量はスループットとも呼ばれます。
しかし、命令間に依存関係がある場合や、分岐の行き先が確定しない場合、パイプラインには空きが発生します。
パイプラインハザードの種類
パイプラインを止める要因は、一般にハザードと呼ばれます。
データハザードは、ある命令の結果を次の命令が必要とする場合に起こります。
制御ハザードは、条件分岐の結果によって次に実行する命令の場所が変わる場合に問題となります。
構造ハザードは、複数の命令が同じ演算器やメモリポートを同時に使いたいときに生じます。
| ハザードの種類 | 発生する場面 | CPU側の主な対策 |
|---|---|---|
| データハザード | 前の計算結果がまだ出ていない | 転送処理、待機、命令の並び替え |
| 制御ハザード | 分岐先が未確定 | 分岐予測、投機実行 |
| 構造ハザード | 同じ資源を複数命令が要求 | 資源の複数化、発行制御 |
アウトオブオーダー実行は、特にデータハザードによる停止を和らげるために有効です。
依存している命令そのものは先に実行できませんが、その命令と関係のない処理を探して前進できます。
すべての停止をなくす技術ではなく、回避できる停止を減らす技術として捉えると誤解がありません。
スーパースカラ方式との組み合わせ
近年の高性能CPUでは、1クロックに複数命令を発行できるスーパースカラ方式が使われます。
整数演算器、浮動小数点演算器、ロードストアユニットなど、複数の実行ユニットを備える構成が一般的です。
複数の演算器があっても、実行する命令を適切に供給できなければ性能は伸びません。
そこでアウトオブオーダー実行が、待機中の命令群から実行可能なものを選び出します。
パイプライン、スーパースカラ、分岐予測、キャッシュ、アウトオブオーダー実行は、それぞれ独立した機能ではありません。
相互に補い合いながら、CPU全体の命令処理能力を引き上げています。
複数の演算器を備えるだけでは高速化は不十分です。
アウトオブオーダー実行によって実行可能な命令を素早く選び、空いている演算器へ渡せることが、スーパースカラCPUの性能を支えます。
命令の依存関係と並び替え
続いては命令の依存関係と並び替えを確認していきます。
真の依存関係であるRAW
命令を入れ替える際に最も重要なのが、データの依存関係です。
代表的なものがRAWです。
RAWはRead After Writeの略で、ある命令が書き込んだ値を、後の命令が読み取る関係を示します。
たとえばレジスタR1に加算結果を書き込み、その後でR1を使って乗算する場合、乗算は加算の完了を待つ必要があります。
この依存関係を無視すると、古い値で計算してしまい、プログラムの結果が壊れます。
そのためアウトオブオーダー実行でも、RAW依存を越えて命令を実行することはできません。
命令1はR1にR2とR3の加算結果を書き込みます。
命令2はR1にR4を加えます。
命令2は命令1の新しいR1を必要とするため、命令1の結果が利用可能になるまで待機します。
一方で、命令3がR8とR9の加算だけを行うなら、R1の値とは無関係です。
命令3は命令1や命令2の待機中でも実行候補になります。
依存する命令は順序を守り、独立した命令だけを前倒しするという原則が、正確な並び替えの土台です。
名前依存とレジスタリネーミング
命令には、本当に値の受け渡しがある依存関係のほか、同じレジスタ名を使うことで見かけ上発生する依存関係もあります。
代表例としてWARとWAWがあります。
WARはWrite After Readで、先の命令が値を読む前に後の命令が同じ場所へ書くと困る関係です。
WAWはWrite After Writeで、複数の命令が同じ場所へ書く場合に、最終的な書き込み順を守る必要がある関係です。
これらはレジスタリネーミングによって解消できる場合があります。
レジスタリネーミングでは、CPU内部にある多数の物理レジスタを使い、同じ論理レジスタ名に対して別々の保存先を割り当てます。
プログラム上はR1に見えても、内部では異なる物理レジスタに値を保持できるため、不要な待機を減らせます。
| 依存関係 | 意味 | リネーミングでの対応 |
|---|---|---|
| RAW | 書き込まれた新しい値を後続が読む | 解消できない真の依存関係 |
| WAR | 先行命令の読み取り前に後続が書く | 物理レジスタの分離で解消可能 |
| WAW | 複数命令が同じ名前へ書く | 物理レジスタの分離で解消可能 |
レジスタリネーミングは、アウトオブオーダー実行の自由度を高める重要な仕組みです。
表面的なレジスタ名の重複に引きずられず、実際に必要なデータの流れを中心に命令を管理できるようになります。
メモリ依存関係の扱い
レジスタだけでなく、メモリ操作にも依存関係があります。
たとえば、ある命令がメモリ番地Aへ値を書き込み、その後の命令が番地Aから読み出すなら、読み出しを先に進めることはできません。
一方で、番地Aへの書き込みと番地Bからの読み出しなら、両者は独立している可能性があります。
ただしCPUは、計算途中の段階では二つの命令が同じ番地を使うかどうかを即座に確定できないこともあります。
そこでロードストアユニットは、アドレス計算、ストアバッファ、依存予測などを使いながら、安全な順序を判断します。
誤った推測でロードを先行させた場合は、投機的な結果を破棄し、正しい順序で再実行します。
メモリの並び替えは性能に大きく効く一方で、正しさの確認も特に慎重な領域です。
CPU内部の実行手順
続いてはCPU内部の実行手順を確認していきます。
フェッチとデコードの段階
処理の入り口では、CPUが命令キャッシュから命令を取り出します。
これをフェッチと呼びます。
分岐命令がある場合、CPUは分岐予測器を用いて次に読むべき命令の場所を予測します。
予測が当たれば、命令の供給を途切れさせずに済みます。
続いてデコードの段階で、機械語の命令をCPU内部で扱いやすい形式へ変換します。
命令セットの種類によっては、一つの命令を複数の内部演算に分けることもあります。
ここで必要なレジスタ、演算の種類、メモリアクセスの有無などが識別されます。
発行待ちとスケジューリング
デコードされた命令は、すぐに実行ユニットへ送られるとは限りません。
必要な入力値がまだ届いていない場合や、対応する演算器が使用中の場合には、命令は予約ステーションやスケジューラで待機します。
この待機場所では、各命令について必要なオペランドが準備できたかどうかが追跡されます。
入力値がそろい、演算器に空きができると、実行可能な命令として発行されます。
この段階でプログラム順より後ろにある命令が先に選ばれることが、アウトオブオーダー実行の具体的な動きです。
命令Aはキャッシュミスによってデータ待ちになっています。
命令Bは整数加算で入力値もそろっており、整数演算器も空いています。
CPUは命令Bを先に発行し、命令Aはデータ到着まで待機させます。
スケジューラは、多数の命令候補から毎クロック適切な命令を選ぶ必要があります。
この判断回路は高速である一方、設計の複雑さや電力消費にも関わる部分です。
ウィンドウ内に多くの命令を保持できれば並列性を見つけやすくなりますが、回路規模が大きくなるというトレードオフもあります。
実行と結果の保持
発行された命令は、整数演算器、浮動小数点演算器、ベクトル演算器、ロードストアユニットなどで実行されます。
加算のように短時間で終わる命令もあれば、除算やキャッシュミスを伴うロードのように長くかかる命令もあります。
完了した結果は物理レジスタなどに保存され、待機していた後続命令へ通知されます。
この通知により、必要な入力がそろった命令は次の発行候補になります。
一つの結果が複数の命令に使われる場合でも、CPU内部の転送経路によって効率的に届けられます。
結果が出た瞬間に次の実行可能命令を目覚めさせる流れが、命令レベル並列性を連鎖的に引き出します。
リオーダーバッファと投機実行
続いてはリオーダーバッファと投機実行を確認していきます。
順序を戻すコミットの仕組み
アウトオブオーダー実行では、命令の実行完了順がプログラム順と異なることがあります。
しかし、プログラムから見えるレジスタ値やメモリへの書き込みは、原則として正しい命令順で確定しなければなりません。
この役割を担う代表的な仕組みがリオーダーバッファです。
リオーダーバッファは、実行中の命令とその結果、例外の有無、完了状態などを記録します。
命令は内部で順不同に実行されても、コミットと呼ばれる確定処理は原則としてプログラム順に進みます。
先頭の命令が完了し、例外もなければ、その結果を正式な状態として反映します。
この方法によって、CPU内部の高速な並び替えと、外部から見える整然とした命令順を両立できます。
実行順が入れ替わっても、確定順をプログラム順に保つことが重要です。
リオーダーバッファは、例外処理や分岐予測の失敗から正しい状態へ戻るための基盤にもなります。
分岐予測と投機的な処理
条件分岐では、比較結果が判明するまで次に実行する命令の場所が確定しません。
ここで何もせず待つと、深いパイプラインでは大きな損失になります。
そのためCPUは、過去の実行履歴などを利用して分岐先を予測し、その予測に基づいて後続命令を先に実行します。
これが投機実行です。
予測が当たれば、必要な処理がすでに進んでいるため、性能向上につながります。
予測が外れた場合は、その予測経路で行った未確定の処理を取り消し、正しい経路から処理をやり直します。
リオーダーバッファや物理レジスタによる状態管理があるため、誤った経路の結果を正式な状態にしないよう制御できます。
例外処理と正確な状態
CPUはゼロ除算、ページフォールト、不正な命令など、さまざまな例外を処理する必要があります。
命令が順不同で実行されていると、途中の命令で例外が起きたときに状態が混乱しそうに見えるかもしれません。
そこでCPUは、コミットを順序どおりに進めることで、例外が発生した時点の状態を一貫した形で扱います。
後続の命令が内部で実行済みだったとしても、まだコミットしていなければ取り消せます。
この性質は正確な例外と呼ばれ、高度なCPU設計で欠かせない考え方です。
投機的に計算した結果と、プログラム上で確定した結果を明確に分けることで、高速性と信頼性が保たれています。
性能向上の利点と注意点
続いては性能向上の利点と注意点を確認していきます。
実アプリケーションで得られる効果
アウトオブオーダー実行は、依存関係が比較的少ない命令列で特に効果を発揮します。
コンパイルされたプログラムには、計算、比較、アドレス計算、データの読み書きなど、多様な命令が混在しています。
CPUがそれらを柔軟に配置できれば、ロード待ちや演算待ちの時間を別の仕事で埋められます。
ゲーム、動画編集、コンパイル、データ分析、ブラウザ処理などでは、こうした命令レベル並列性を活かせる場面が多くあります。
ただし性能向上の程度は、アプリケーションの性質、キャッシュヒット率、分岐予測の精度、メモリ帯域などによって変わります。
CPUのクロック周波数やコア数だけでは測れない性能差が出る理由の一つが、内部実行機構の違いです。
| 性能に影響する要素 | アウトオブオーダー実行との関係 |
|---|---|
| 命令レベル並列性 | 独立命令が多いほど前倒しの候補が増える |
| キャッシュ性能 | ロード待ちが長いほど別命令を進める価値が高まる |
| 分岐予測精度 | 予測成功時に投機実行の効果を得やすい |
| 実行ユニット数 | 並列に発行できる命令数の上限へ影響する |
| 命令ウィンドウサイズ | 広いほど実行可能な独立命令を見つけやすい |
CPUが先読みできる命令の範囲と、同時に使える演算資源の組み合わせが、実際の処理効率を左右します。
消費電力と設計の複雑さ
アウトオブオーダー実行には明確な利点がありますが、万能ではありません。
命令の依存関係を監視し、物理レジスタを割り当て、待機中の命令から実行対象を選び、順番どおりに結果を確定するには多くの回路が必要です。
回路が増えるほど、チップ面積、設計工数、検証の難しさ、消費電力が増える傾向があります。
特にモバイル機器では、性能だけでなくバッテリー持続時間や発熱も重要な判断材料です。
そのためCPU設計では、常に最大限のアウトオブオーダー実行を目指すのではなく、用途に合った規模を選びます。
高性能コアと高効率コアを組み合わせる設計でも、コアごとにアウトオブオーダー実行の規模や深さが異なる場合があります。
アウトオブオーダー実行は高性能化に有効ですが、回路規模と電力を必要とします。
CPUの優れた設計とは、実行幅や命令ウィンドウを大きくすることだけではなく、用途に合わせて性能と効率の均衡を取ることです。
ソフトウェア開発との関わり
通常のアプリケーション開発では、プログラマーがCPU内部の命令順を直接管理する必要はありません。
ただし、性能を重視する場面では、データ依存を減らす書き方や、キャッシュに収まりやすいデータ構造が役立ちます。
同じ値を連続して使う計算は依存の連鎖を作りやすく、CPUが並列に実行できる範囲を狭めることがあります。
反対に独立した計算を複数用意できる処理では、アウトオブオーダー実行やSIMD命令の効果を得やすいでしょう。
コンパイラも命令スケジューリングや最適化を行いますが、実行時のキャッシュ状態や分岐の結果までは完全に予測できません。
ハードウェア側の動的な命令並び替えは、実行時に起きる変化へ対応する意味でも価値があります。
ソフトウェアの見通しのよいデータ処理と、CPUの動的最適化が組み合わさることで、より高い処理性能につながります。
まとめ
アウトオブオーダー実行とは、CPUが命令の依存関係を守りながら、実行可能な命令をプログラム順より先に処理する技術です。
先行するロード命令や長い演算の完了を待つ間に、独立した命令を実行することで、パイプラインの空きを減らします。
パイプライン処理、スーパースカラ方式、レジスタリネーミング、分岐予測、投機実行、リオーダーバッファは、この仕組みを支える重要な要素です。
特にリオーダーバッファによって、内部の実行順が入れ替わっても、プログラムから見える結果は正しい順番で確定します。
高速化の本質は、CPUが待っている時間を減らし、利用可能な演算資源を働かせ続けることにあります。
一方で、複雑な制御回路は消費電力やチップ面積の増加にもつながるため、CPU設計では性能と効率のバランスが欠かせません。
アウトオブオーダー実行を理解すると、CPUの処理速度が単なるクロック周波数だけで決まらない理由や、キャッシュ、分岐予測、命令依存が性能へ与える影響も見えてくるでしょう。