プログラミングやアルゴリズムの学習を進めると、計算量という言葉に加えて、Time ComplexityやBig O Notationといった英語表記に出会います。
日本語の意味は理解できても、英語での読み方や会話、技術文書での使い方に迷う方は少なくありません。
この記事では、計算量に関わる英語表現、読み方、例文、Big O記法の考え方を、初心者にもわかりやすく整理します。
計算量の英語表記と基本用語
それではまず計算量の英語表記と、実務や学習で押さえたい基本用語について解説していきます。
Time Complexityの意味と読み方
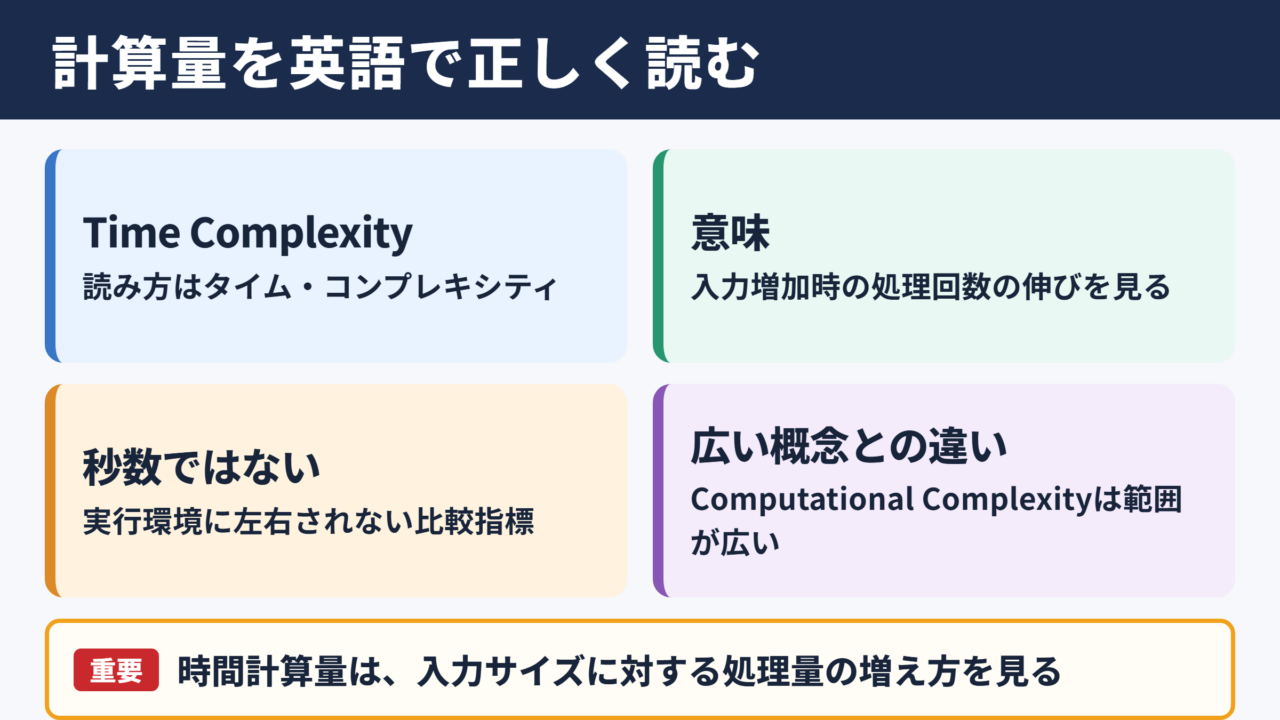
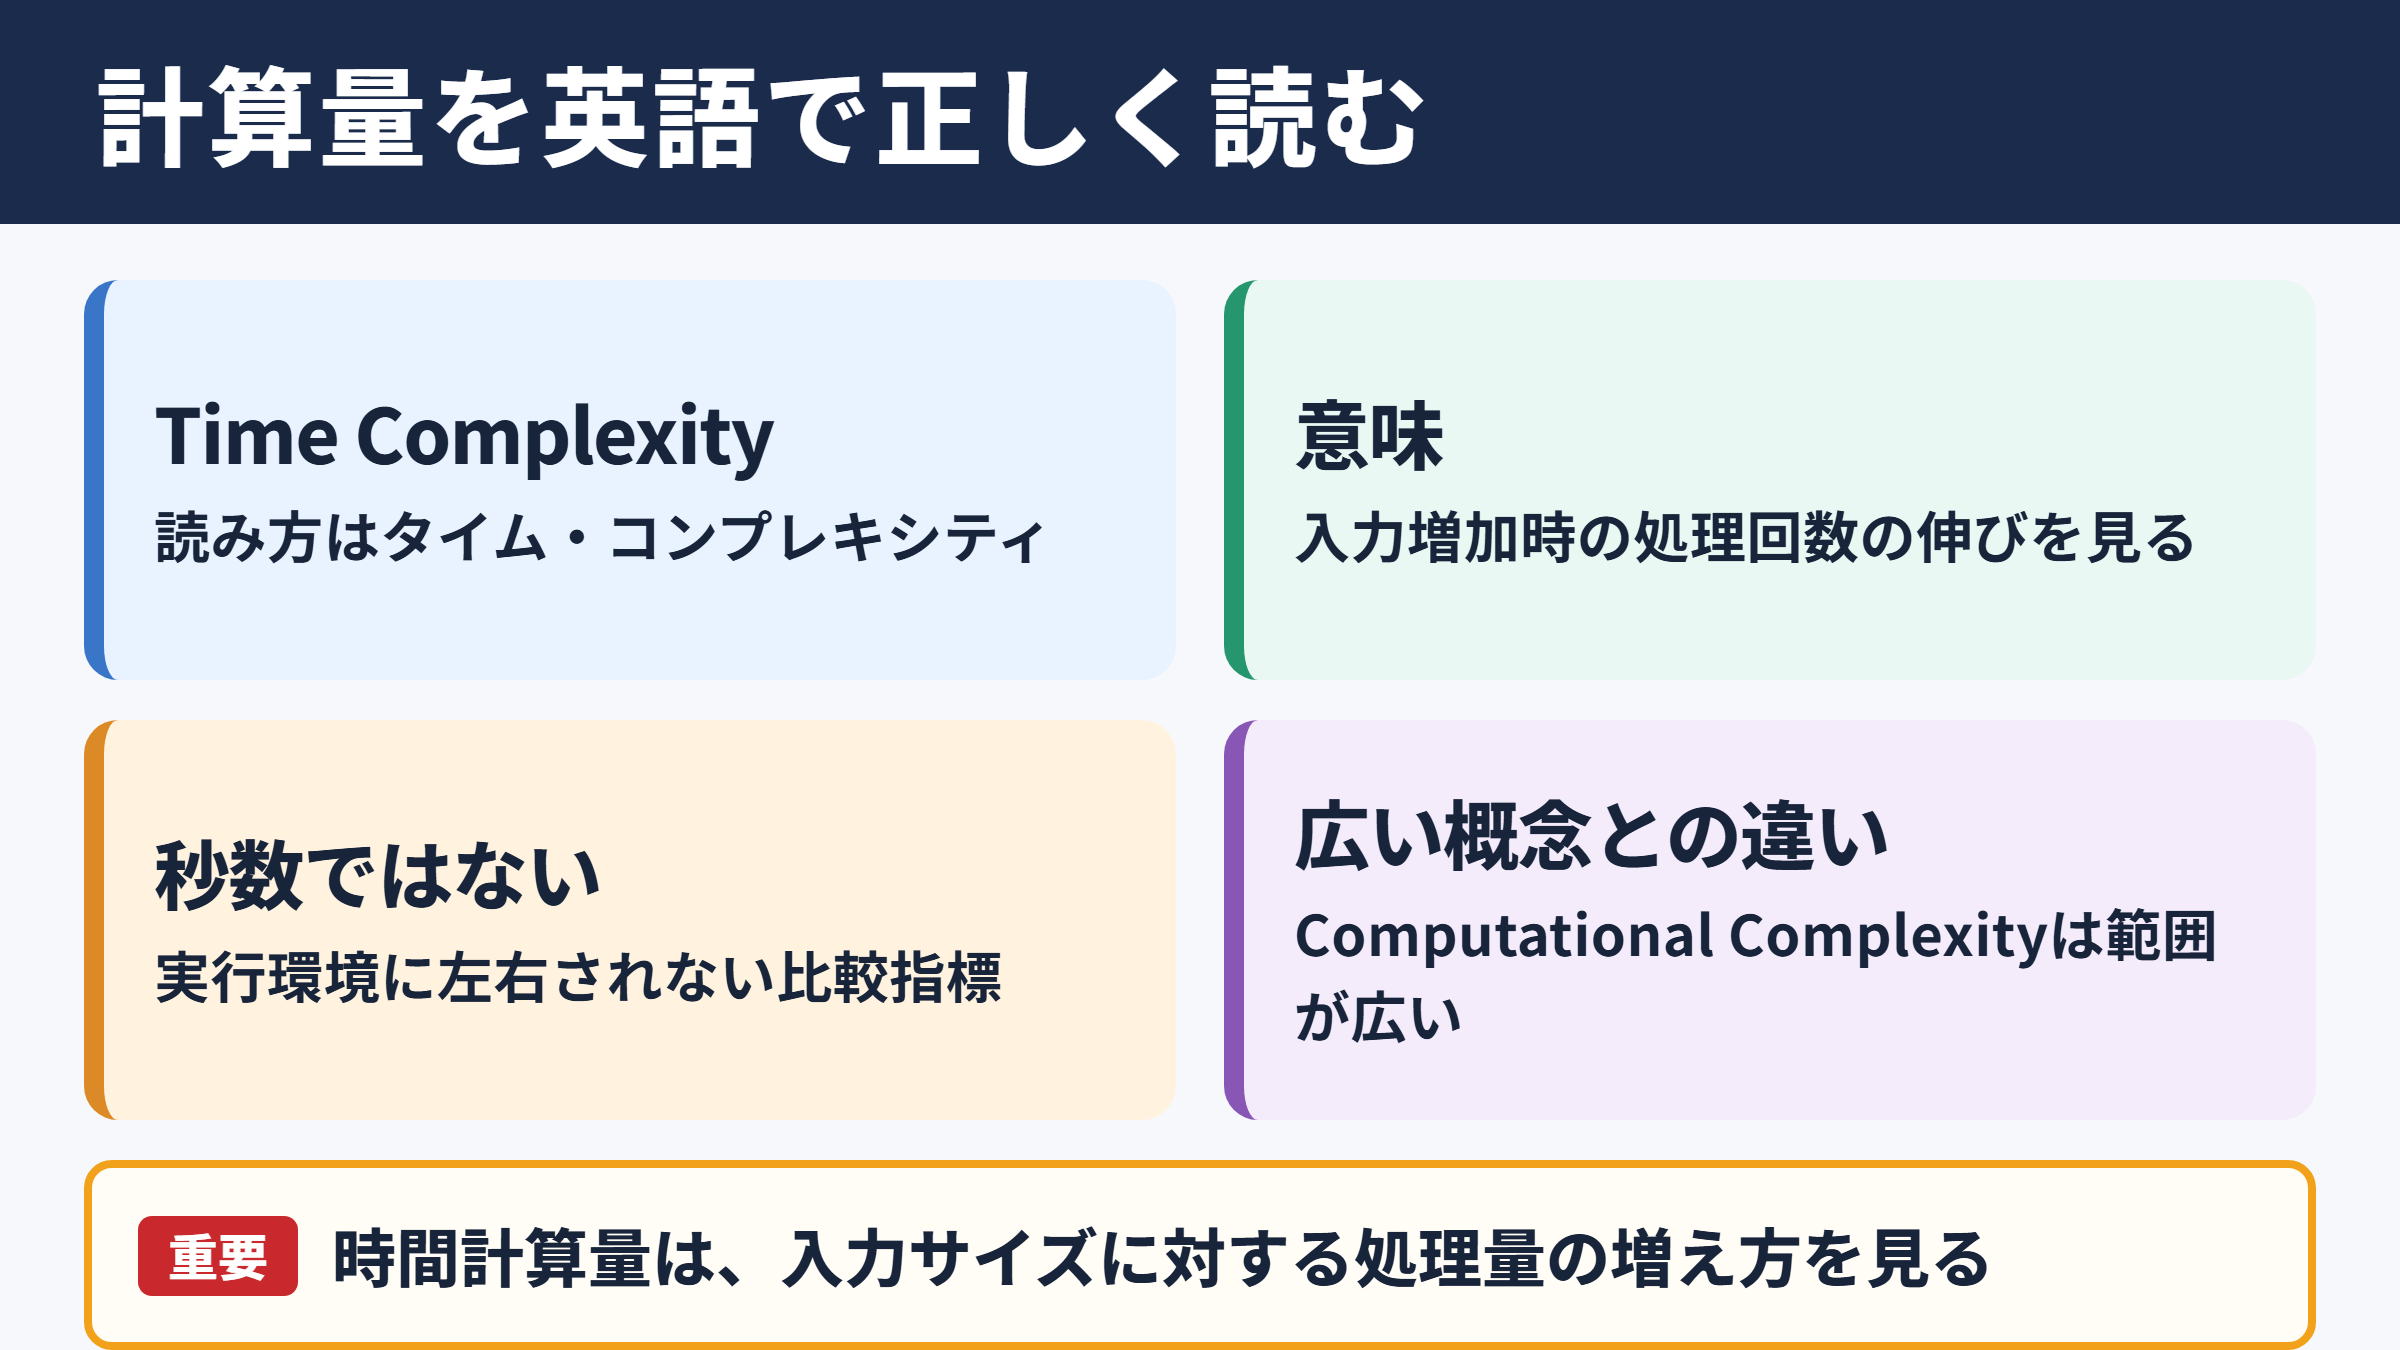
計算量は英語でTime Complexityと表記するのが一般的です。
読み方は、タイム コンプレキシティです。
Timeは時間、Complexityは複雑さを意味するため、直訳すると時間的な複雑さになります。
ただし、プログラミングの文脈でいうTime Complexityは、処理に必要な実時間そのものを測る表現ではありません。
入力データの量が増えたとき、処理回数がどのような割合で増えるかを示す考え方です。
パソコンの性能、使用言語、通信状態などに左右される秒数ではなく、アルゴリズムの効率を比較するための目安として使われます。
たとえば、同じ検索処理でも、データを先頭から順番に確認する方法と、並び順を利用して範囲を絞る方法では、入力件数が増えた際の負荷に大きな差が出ます。
この差を表現する場面で、Time Complexityが役立ちます。
Time Complexityは、プログラムが何秒で終わるかではなく、入力サイズの増加に対して処理量がどう増えるかを見る指標です。
Computational Complexityとの違い
計算量に近い英語として、Computational Complexityも使われます。
読み方は、コンピュテーショナル コンプレキシティです。
こちらは計算理論や情報科学の分野で用いられやすく、時間だけでなく、メモリ使用量や問題を解く難しさまで含めた広い概念を指すことがあります。
一方で、コードレビューやアルゴリズムの説明では、時間計算量を意味してTime Complexityと書かれるケースが多いでしょう。
英語の資料を読むときは、前後にSpace Complexityという語があるか、実行速度について話しているかを確認すると意味を判断しやすくなります。
Time Complexityは時間に関する計算量、Computational Complexityはより広い計算の複雑さ、と考えると整理しやすいです。
Space Complexityと処理負荷
時間計算量とセットで覚えたい用語が、Space Complexityです。
読み方は、スペース コンプレキシティです。
これは日本語で空間計算量や領域計算量と呼ばれ、処理のために必要となるメモリ量の増え方を表します。
高速に処理できるアルゴリズムでも、大量の配列やコピーを作成する場合、メモリ不足を招く可能性があります。
逆に、メモリをあまり使わない方法が、時間を多く必要とすることもあります。
このような関係は、Time Space Tradeoffと呼ばれます。
読み方は、タイム スペース トレードオフです。
設計では実行時間だけを見るのではなく、利用環境のメモリ容量、同時接続数、保存するデータ量も踏まえて判断する必要があります。
Big O Notationの意味と読み方
続いてはBig O Notationの意味と読み方を確認していきます。
Big O Notationの基本概念
Big O Notationは、日本語でビッグオー記法やオーダー記法と呼ばれます。
読み方は、ビッグ オー ノーテーションです。
アルゴリズムの計算量を、入力サイズnに対する増加の傾向として表す記法です。
たとえば、配列の要素を1回ずつ確認する処理は、要素数に応じて確認回数が増えるためO of nと表記します。
実際のコードでは比較、代入、関数呼び出しなどが発生しますが、Big Oでは細かな定数差よりも、データ量が大きくなったときの伸び方を重視します。
そのため、O of 2nやO of 100nは、いずれもO of nとして扱われます。
入力が非常に大きくなると、定数よりも増加の形そのものが影響しやすくなるためです。
配列の全要素を1回確認する場合、要素数をnとすると処理回数はおおむねn回です。
このときの時間計算量はO of nと表せます。
オーダー表記におけるOの意味
Big OのOは、Orderを表すと説明されることがあります。
Orderは順序、規模、程度などの意味を持つ英語です。
ただし、Big Oは単純に順番を示す記号ではありません。
計算量の上限を漸近的に表すための数学的な記法です。
漸近的とは、入力サイズが十分に大きくなったときの傾向に注目する考え方を指します。
日常的な開発では、厳密な数学定義よりも、処理が線形に増えるのか、二乗に近い増え方なのかを把握するために使われます。
英語で説明する際は、The algorithm runs in O of n time.という表現がよく用いられます。
これは、そのアルゴリズムはO of nの時間計算量で動作する、という意味です。
Worst CaseとAverage Caseの区別
Big O記法は、最悪計算量を説明するために使われることが多い表現です。
最悪の場合は英語でWorst Caseといい、読み方はワースト ケースです。
一方、平均的な条件での計算量はAverage Case、最も良い条件での計算量はBest Caseと呼ばれます。
たとえば線形探索では、探したい値が先頭にあればすぐに見つかります。
しかし、末尾にある場合や存在しない場合には、すべての要素を確認しなければなりません。
この最悪の状況ではO of nとなります。
仕様上の最大負荷を見積もる場面ではWorst Caseが重要ですが、実際の利用データも考慮しなければ、過度な最適化につながることがあります。
| 英語表現 | 読み方 | 日本語での意味 |
|---|---|---|
| Worst Case | ワースト ケース | 最悪の場合 |
| Average Case | アベレージ ケース | 平均の場合 |
| Best Case | ベスト ケース | 最良の場合 |
| Upper Bound | アッパー バウンド | 上限 |
| Lower Bound | ローワー バウンド | 下限 |
代表的な計算量表記
続いては代表的な計算量表記を確認していきます。
定数時間と対数時間
O of 1は、Constant Timeと呼ばれます。
読み方は、コンスタント タイムです。
入力データが増えても、基本的な処理回数がほとんど変わらない状態を表します。
配列の添字を使って特定の位置にアクセスする処理は、代表例の一つです。
一方、O of log nはLogarithmic Timeと呼ばれます。
読み方は、ロガリズミック タイムです。
二分探索のように、候補を半分ずつ絞り込む処理が該当します。
データ量が増えても処理回数の伸びが比較的ゆるやかなため、大規模な検索で効果を発揮します。
O of log nを実現するには、データがソート済みであることなどの前提条件が必要になる場合があります。
二分探索では、検索範囲を毎回半分に減らします。
要素数が増えても確認回数は急激には増えず、時間計算量はO of log nです。
線形時間と線形対数時間
O of nはLinear Timeと呼ばれ、読み方はリニア タイムです。
入力件数に比例して処理量が増える計算量であり、ループで全要素を1回ずつ走査するコードが代表的です。
データを1回読む必要がある処理では、O of nは必ずしも遅いとはいえません。
むしろ、大量データを扱う処理では、無理に複雑な方法へ変えるより、わかりやすいO of nの実装が適している場合もあります。
O of n log nはLinearithmic TimeやLog Linear Timeと呼ばれます。
読み方は、リニアリズミック タイム、またはログ リニア タイムです。
効率のよい比較ソートであるマージソートやヒープソートでは、一般にこの計算量が現れます。
ソート処理ではO of n log nが実用的な基準として語られることが多いでしょう。
二乗時間と指数時間
O of n squaredはQuadratic Timeと呼ばれ、読み方はクアドラティック タイムです。
二重ループで全組み合わせを比較するような処理で発生しやすい計算量です。
要素数が2倍になると、処理量はおよそ4倍になります。
小さなデータでは問題にならなくても、件数が増えると待ち時間が目立ち始めます。
O of 2 to the nはExponential Time、O of n factorialはFactorial Timeと呼ばれます。
これらは候補の組み合わせを総当たりで調べる問題に現れやすく、入力サイズが少し増えるだけで実行時間が急増します。
最適化問題や組み合わせ問題では、近似アルゴリズム、枝刈り、動的計画法などを検討する場面が出てくるでしょう。
| 表記 | 英語表現 | 代表的な処理 | 増加の特徴 |
|---|---|---|---|
| O of 1 | Constant Time | 添字アクセス | 入力数にほぼ影響されない |
| O of log n | Logarithmic Time | 二分探索 | ゆるやかに増える |
| O of n | Linear Time | 全件走査 | 件数に比例する |
| O of n log n | Linearithmic Time | 効率的な比較ソート | 線形より少し大きい |
| O of n squared | Quadratic Time | 二重ループ比較 | 件数増加の影響が大きい |
| O of 2 to the n | Exponential Time | 総当たり探索 | 急激に増える |
計算量を説明する英語例文
続いては計算量を説明する英語例文を確認していきます。
基本説明に使える例文
英語で計算量を説明するときは、The time complexity is O of n.という短い文が基本になります。
日本語では、時間計算量はO of nです、という意味です。
アルゴリズムを主語にする場合は、This algorithm has a time complexity of O of n squared.と表現できます。
このアルゴリズムの時間計算量はO of n squaredです、という内容になります。
より自然な技術説明としては、This function runs in linear time.も便利です。
この関数は線形時間で実行される、という意味です。
runs in O of n timeは、技術記事、設計書、面接などでも頻繁に見かける表現です。
The search operation runs in O of log n time.
検索処理はO of log nの時間で実行されます。
比較や改善を伝える例文
改善前後の処理を比較する場合は、The new implementation reduces the time complexity from O of n squared to O of n log n.と表現できます。
新しい実装は、時間計算量をO of n squaredからO of n log nへ削減する、という意味です。
処理量が増える理由を補足するなら、The nested loop causes quadratic growth as the input size increases.が使えます。
ネストしたループによって、入力サイズの増加に伴い二乗の伸びが生じる、という説明です。
改善案を述べる際には、We can use a hash table to achieve constant time lookup on average.という文も役立ちます。
平均的には定数時間の検索を実現するため、ハッシュテーブルを使える、という意味になります。
ただし、ハッシュテーブルの性能はハッシュ関数、衝突、再ハッシュなどの条件に影響される点も補足すると、説明の精度が高まります。
レビューや会議で使う表現
コードレビューでは、What is the time complexity of this loop?と質問できます。
このループの時間計算量は何ですか、という意味です。
メモリ面も確認したい場合は、How much extra space does this algorithm require?と尋ねるとよいでしょう。
このアルゴリズムには追加でどれくらいのメモリが必要ですか、という内容です。
性能上の懸念を伝えるなら、This approach may not scale well for large datasets.という表現が自然です。
この方法は大規模データセットでは十分に拡張できない可能性がある、というやわらかい指摘になります。
計算量の英語説明では、速いか遅いかだけで断定せず、データ量や利用条件を添えることが大切です。
計算量の考え方とコード読解
続いては計算量の考え方とコード読解について確認していきます。
ループ回数から考える方法
計算量を読み取る最初の手がかりは、繰り返し回数です。
配列を1回走査するfor文があれば、基本的にはO of nを疑います。
外側と内側の両方がn回繰り返される二重ループなら、処理回数はn multiplied by nとなり、O of n squaredです。
ただし、ループが二つ並んでいるだけで、必ずO of n squaredになるわけではありません。
前半でn回、後半でn回処理するなら、合計は2n回です。
Big Oでは定数を省略するため、これはO of nとして扱います。
コードの見た目だけで判断せず、各ループがどの範囲を何回処理するかを追う姿勢が重要です。
連続した二つのループは足し算で考え、入れ子になったループは掛け算で考えると、基本的な計算量を整理しやすくなります。
再帰処理における見方
再帰関数では、関数が何回呼び出されるかに注目します。
単純な再帰で呼び出しが1本ずつ続く場合、深さがnならO of nになることがあります。
一方で、一つの呼び出しから二つの再帰呼び出しが発生する場合、呼び出し回数が急増する可能性があります。
フィボナッチ数列を単純再帰で求める実装は、その代表例です。
メモ化を使えば、すでに求めた結果を再利用できます。
この工夫により、同じ部分問題を何度も計算する無駄を減らせます。
英語ではMemoizationと表記し、読み方はメモイゼーションです。
再帰処理では時間計算量だけでなく、呼び出しスタックによるSpace Complexityも確認しておくと安心です。
実測値と理論値の使い分け
Big Oはアルゴリズムの成長傾向を示しますが、実際の性能を完全に予測するものではありません。
同じO of nでも、文字列操作、ディスクアクセス、データベース接続、ネットワーク通信が含まれるかで体感速度は変わります。
小規模な入力ではO of n squaredの単純な実装が、O of n log nの複雑な実装より速いこともあります。
定数倍の差、CPUキャッシュ、ライブラリの最適化、データ分布などが影響するためです。
そこで、設計段階では計算量を確認し、性能が重要な箇所ではベンチマークも実施する方法が有効です。
英語ではbenchmarkと表記し、読み方はベンチマークです。
理論と測定結果の両方を確認することで、根拠のある改善につながります。
学習と実務で役立つ関連表現
続いては学習と実務で役立つ関連表現を確認していきます。
アルゴリズムとデータ構造の英語
計算量を学ぶときは、AlgorithmとData Structureの英語表現も合わせて覚えると理解が深まります。
Algorithmはアルゴリズム、Data Structureはデータ構造です。
配列はArray、連結リストはLinked List、スタックはStack、キューはQueue、木構造はTreeと表記します。
また、ハッシュテーブルはHash Table、優先度付きキューはPriority Queueと呼ばれます。
どのデータ構造を選ぶかによって、検索、追加、削除、並べ替えの計算量が変化します。
アルゴリズムだけでなく、データ構造の選択も性能設計の重要な要素です。
検索と並べ替えの英語表現
検索はSearchまたはLookupと表現します。
Searchは広く探す行為を指し、Lookupはキーなどを使って値を参照するニュアンスで使われることがあります。
線形探索はLinear Search、二分探索はBinary Searchです。
並べ替えはSort、ソートの手法はSorting Algorithmと呼ばれます。
バブルソートはBubble Sort、マージソートはMerge Sort、クイックソートはQuick Sortです。
英語の技術文書では、Sort the array in ascending order.のように書かれます。
これは配列を昇順にソートする、という意味です。
性能改善に関する英語表現
性能改善はPerformance Optimizationと表現します。
読み方は、パフォーマンス オプティマイゼーションです。
ボトルネックはBottleneck、拡張性はScalability、遅延はLatency、スループットはThroughputと呼ばれます。
計算量に問題がある箇所を説明するなら、This is the bottleneck in the current implementation.という文が使えます。
現行実装におけるここがボトルネックです、という意味です。
また、Optimize only after measuring the performance.という考え方も大切でしょう。
性能を測定してから最適化する、という意味であり、根拠のない複雑化を防ぐ助けになります。
計算量の知識は、速そうに見えるコードを選ぶためだけのものではありません。
将来のデータ増加を見通し、保守しやすい設計を選ぶための共通言語として役立ちます。
計算量の英語表記と読み方のまとめ
計算量は英語でTime Complexityと表記し、読み方はタイム コンプレキシティです。
メモリ使用量の増え方はSpace Complexity、計算量を簡潔に表す記法はBig O Notationと呼ばれます。
O of 1、O of log n、O of n、O of n log n、O of n squaredといった表記は、入力サイズが増えたときの処理量の伸び方を理解するための目安です。
Big Oは実行秒数の保証ではなく、アルゴリズムの成長傾向を比較する道具として捉えるとよいでしょう。
英語では、The time complexity is O of n.やThis algorithm runs in linear time.といった例文を覚えておくと、技術資料の読解や会話で活用できます。
コードを読む際は、ループの回数、再帰呼び出し、使用するデータ構造、追加メモリに注目してください。
理論上の計算量と実際のベンチマーク結果を組み合わせれば、より適切な実装判断につながります。