ビッグデータの意味をわかりやすく!ビジネスでの活用例・通常データとの違い・分析技術との関係も(大量データ・3V・データ主導経営など)
ビッグデータという言葉を耳にする機会は増えましたが、単にデータ量が多い状態を指すわけではありません。
顧客行動、購買履歴、Webサイトの閲覧記録、センサー情報、SNS投稿など、形式も発生速度も異なる情報を事業に役立てる考え方まで含む言葉です。
本記事では、ビッグデータの基本的な意味、通常のデータとの違い、3V、分析技術、ビジネスの活用例を順にわかりやすく紹介します。
ビッグデータの意味とビジネス活用の要点
それではまず、ビッグデータの意味と事業で押さえたい要点について解説していきます。
大量データだけではないビッグデータの定義
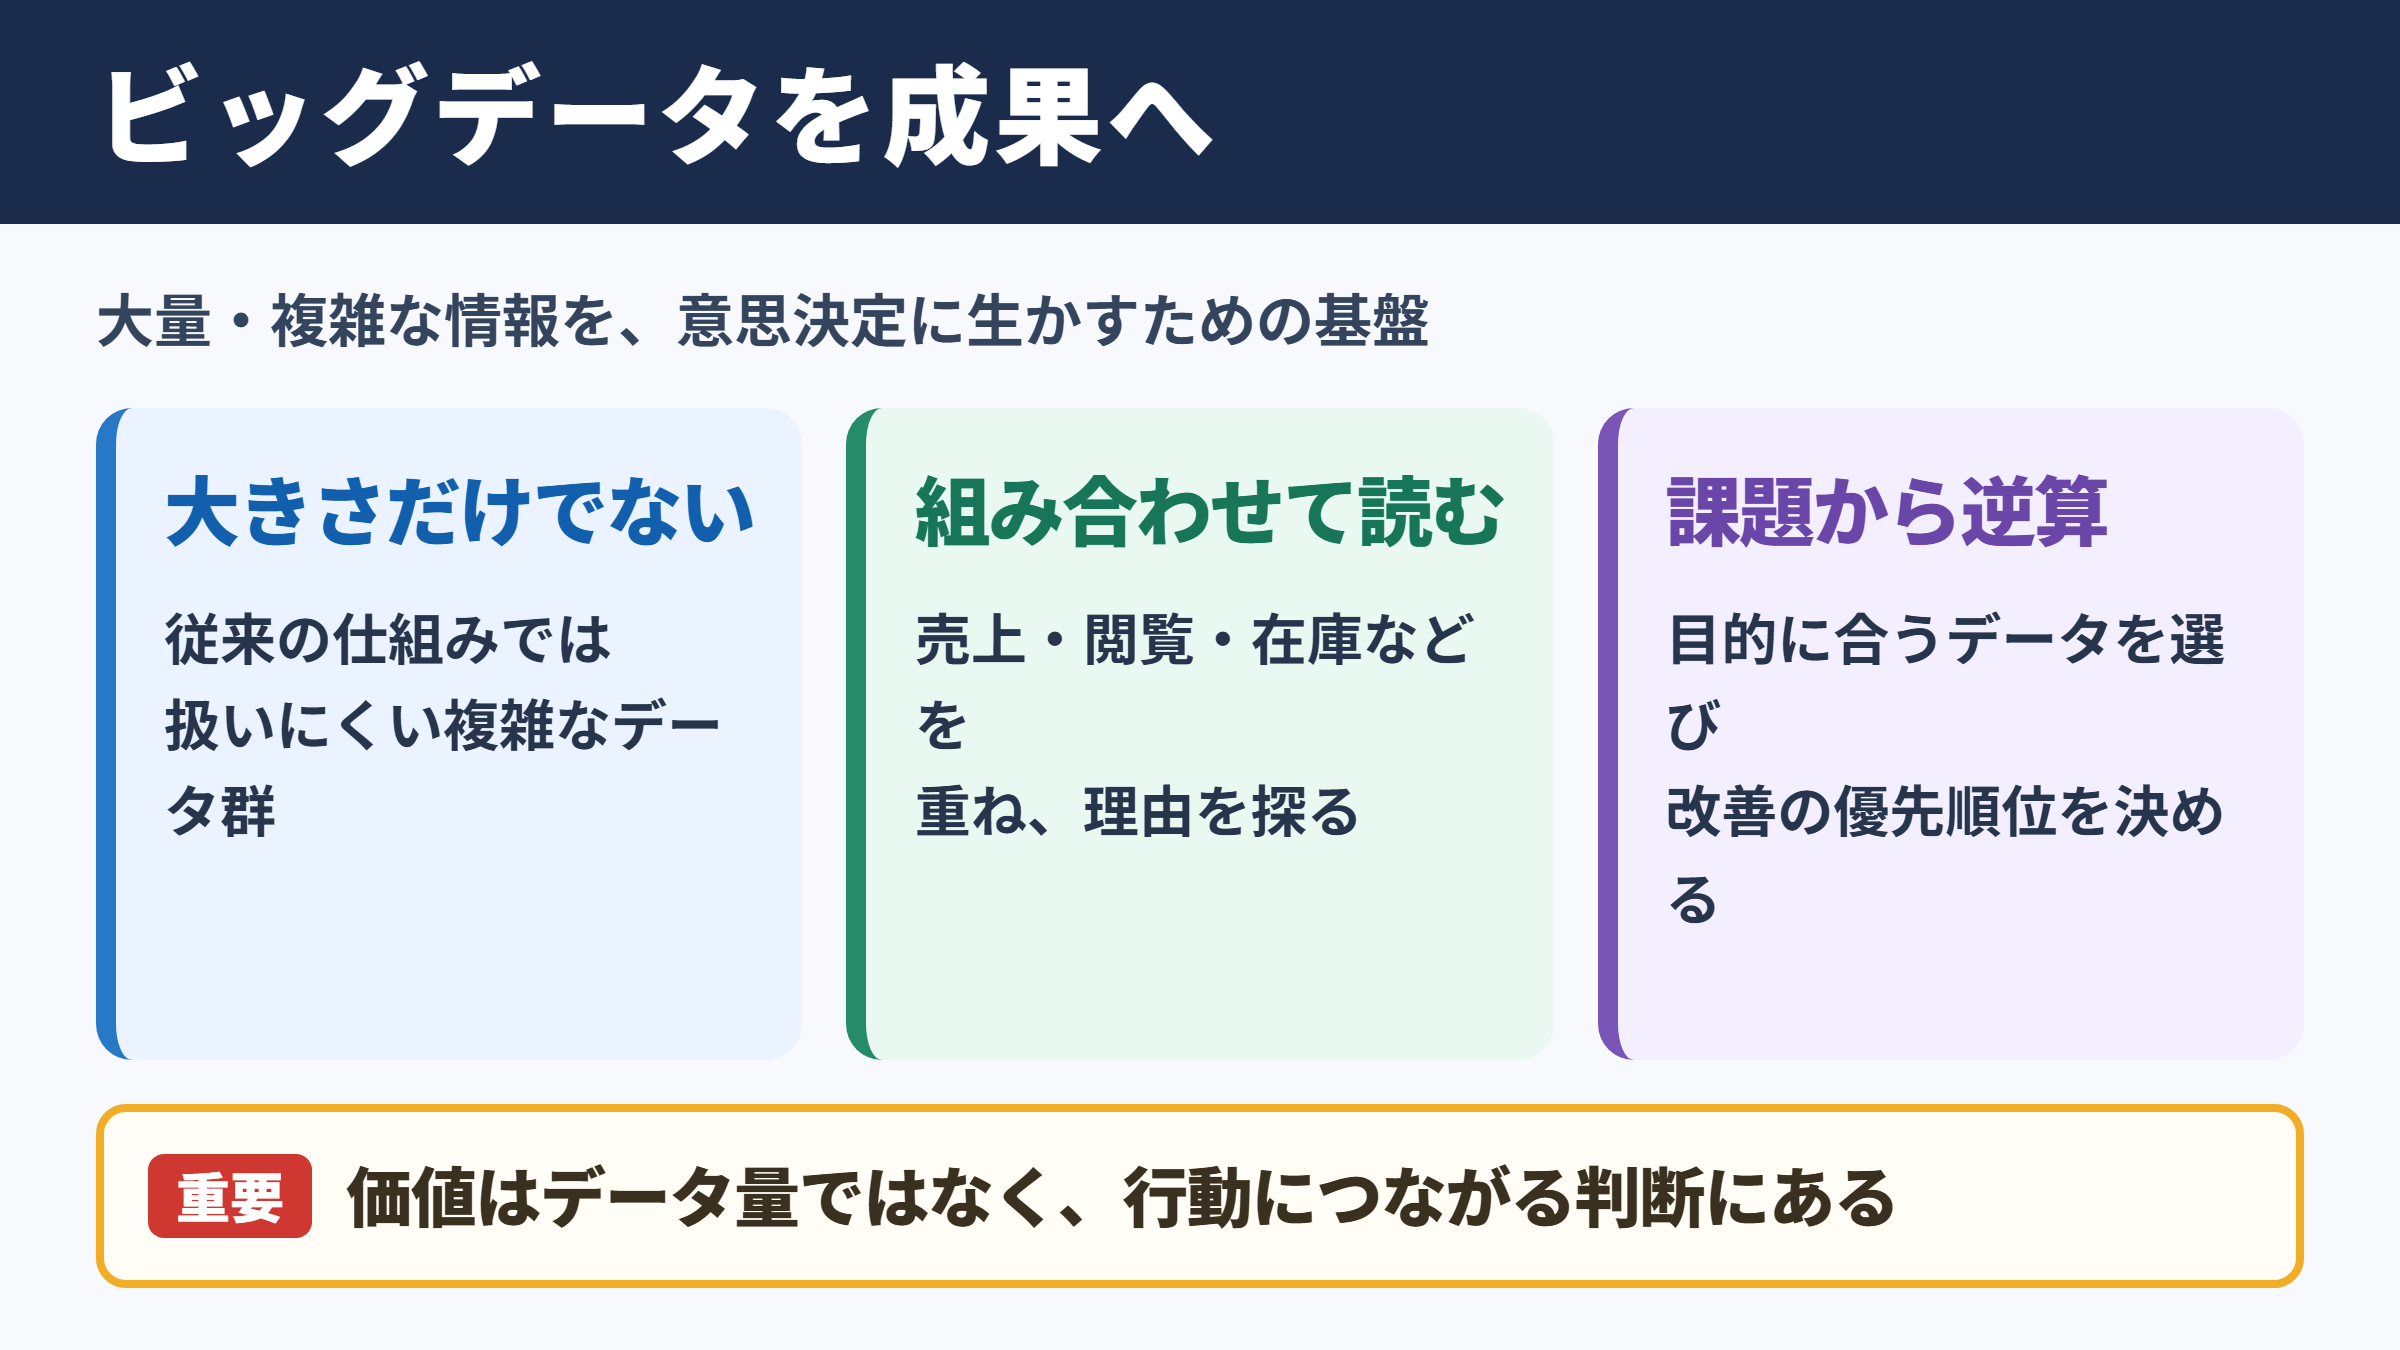
ビッグデータとは、従来の表計算ソフトや一般的なデータベースだけでは、収集、保存、処理、分析が難しいほど大規模で複雑なデータ群を指します。
たとえば、数百万件の商品購入履歴、動画の視聴ログ、工場設備から秒単位で届く稼働データ、位置情報付きの移動記録などが代表例です。
重要なのは容量の大きさだけではなく、多様な情報を組み合わせて意思決定に生かせることにあります。
売上データだけを見ている場合は、何が売れたかを把握できます。
一方で、閲覧履歴、検索語句、在庫、天候、店舗の混雑状況まで重ね合わせると、なぜ売れたのか、次に何を準備すべきかを考えやすくなるでしょう。
データ主導経営とのつながり
データ主導経営とは、経験や勘だけに依存せず、収集した情報と分析結果を根拠にして経営判断を行う考え方です。
ビッグデータは、この取り組みを支える重要な基盤になります。
ただし、数字が示す結果をそのまま採用すればよいわけではありません。
分析結果を読む人が、顧客、現場、商品、市場環境を理解したうえで解釈する必要があります。
ビッグデータの価値は、情報を多く持つことではなく、目的に合うデータを選び、行動につながる判断へ変える点にあります。
たとえば解約率が高まったという数値が出た場合、顧客層別、利用期間別、問い合わせ内容別に分けて確認します。
そのうえで、初回設定の難しさ、料金への不満、機能の使いにくさなど、改善の優先順位を決める流れが実務的です。
経営課題から逆算する活用の考え方
ビッグデータ活用を始める際は、先に収集できるデータを並べるのではなく、解決したい経営課題を明確にすることが大切です。
新規顧客を増やしたいのか、在庫の無駄を減らしたいのか、設備停止を防ぎたいのかによって、必要な情報も分析方法も変わります。
目的が曖昧なままデータだけを集めると、保管コストと確認作業だけが増えるおそれがあります。
課題を売れ残り削減と定めた場合の流れです。
販売実績、在庫量、値引き履歴、季節、天候、販促施策を集めます。
次に商品別や店舗別の需要傾向を分析し、発注量、配分、値引き時期の見直しにつなげます。
このように、課題、必要なデータ、分析、施策、効果測定を一続きに設計すると、活用が現場へ定着しやすくなります。
通常データとビッグデータの違い
続いては、通常データとビッグデータの違いを確認していきます。
データ量と保存方法の違い
通常データは、売上台帳、顧客名簿、勤怠記録のように、比較的決まった形式で管理される情報です。
Excelや業務システムのデータベースで扱える規模であれば、日常業務に必要な集計や検索を行いやすいでしょう。
ビッグデータでは、容量が大きいだけでなく、データの増加が継続します。
大量のログや画像、音声、センサー情報を蓄積するケースでは、クラウドストレージ、分散処理基盤、データレイクなどを活用する場面が増えます。
| 比較項目 | 通常データ | ビッグデータ |
|---|---|---|
| 主な規模 | 部門や業務単位で管理しやすい規模 | 全社規模や外部データを含む大量の規模 |
| 代表的な形式 | 表形式の売上、顧客、在庫情報 | ログ、画像、動画、音声、位置情報など |
| 更新頻度 | 日次、週次、月次が中心 | リアルタイムまたは短い間隔で発生 |
| 主な目的 | 記録、集計、業務管理 | 予測、最適化、異常検知、顧客理解 |
| 処理の考え方 | 定型的な検索と集計 | 分散処理や機械学習を含む分析 |
両者は対立するものではありません。
日常業務で蓄積する通常データが、ビッグデータ分析の重要な材料になることも多いです。
構造化データと非構造化データの違い
表の行と列に整理できる情報は、構造化データと呼ばれます。
顧客番号、購入日、商品名、金額などは項目が定まっているため、集計や比較に向いています。
これに対して、SNSの文章、問い合わせメール、レビュー、画像、動画、通話音声などは、非構造化データの代表例です。
非構造化データはそのままでは表計算しにくいものの、顧客の本音や利用場面を含みやすい情報でもあります。
たとえば商品レビューの文章を分析すれば、星の数だけでは見えにくい不満点や評価されている機能を探れるでしょう。
近年は自然言語処理、画像認識、音声認識の発展により、非構造化データを活用できる範囲が広がっています。
集計結果と予測結果の違い
通常のデータ活用では、先月の売上、地域別の顧客数、商品別の利益率のように、起きた出来事を集計する作業が中心になりがちです。
もちろん、正確な現状把握は経営の土台になります。
ビッグデータ分析では、過去の傾向と現在の動きを利用して、需要予測、離反予測、不正検知、故障予兆などに取り組めます。
需要予測の基本的な考え方です。
過去の販売量に、曜日、季節、価格、広告、天候、地域イベントなどの影響を加えて、将来の需要量を推定します。
予測値は確定した答えではないため、実績との差を確認して精度を継続的に改善します。
予測が外れることを恐れるより、予測と実績の差から学び、発注や人員配置の判断を少しずつ良くする姿勢が重要です。
ビッグデータを説明する3Vの考え方
続いては、ビッグデータを理解するための3Vを確認していきます。
Volumeで見るデータ量
3Vの一つ目はVolumeで、日本語ではデータ量を意味します。
Webサービスの利用履歴、決済記録、IoT機器の測定値などは、利用者や機器が増えるほど急速に増加します。
データ量が大きくなると、保存場所の確保だけでなく、必要な情報を素早く取り出す仕組みも必要になります。
容量の単位だけでビッグデータかどうかを決めるのではなく、既存の仕組みで扱えるかを考えることが実践的です。
ある企業では数十ギガバイトでも処理が難しい場合があります。
別の企業ではペタバイト級の情報を日常的に扱っている場合もあるため、絶対的な境界線はありません。
Velocityで見る発生速度
二つ目はVelocityで、データが生成、送信、更新される速さを表します。
ECサイトのクリック、金融取引、配送車両の位置情報、工場の温度センサーなどは、短い時間間隔で新しい情報が届きます。
発生速度が高いデータでは、翌日にまとめて分析するだけでは対応が遅れることがあります。
たとえば不正利用の疑いを検知する場面では、取引の直後に警告を出せる仕組みが求められるでしょう。
ただし、すべてをリアルタイム化する必要はありません。
業務への影響、判断までに許される時間、運用コストを比較して、更新頻度を決めることが大切です。
Varietyで見る多様性
三つ目はVarietyで、データの種類や形式の多様さを表します。
企業内には、販売管理システムの数値、問い合わせ履歴の文章、会議録の音声、監視カメラの映像などが存在します。
さらに、公開統計、地図情報、気象情報、SNSなどの外部データを組み合わせる場合もあります。
多様なデータを結び付ける際は、収集目的、利用範囲、個人情報の扱い、更新タイミングを事前に整理することが欠かせません。
形式が異なる情報を無理に一つの表へ詰め込む必要はありません。
データの意味を説明する項目定義や管理ルールを整え、必要なときに適切に参照できる状態を目指します。
| 3V | 意味 | 企業で起こる課題 | 対応の例 |
|---|---|---|---|
| Volume | 大量のデータ | 保存容量や処理時間の増加 | クラウド保存、分散処理、保持期間の設計 |
| Velocity | 高速な発生と更新 | 判断の遅れ、監視負荷の増加 | ストリーミング処理、通知、更新頻度の設計 |
| Variety | 形式の多様性 | 統合の難しさ、意味のばらつき | 項目定義、データ連携、品質管理 |
ビッグデータ分析技術とAIの関係
続いては、ビッグデータ分析技術とAIの関係を確認していきます。
統計分析と可視化の役割
ビッグデータを活用する第一歩は、情報を眺めやすい形に整え、傾向や異常を把握することです。
集計表、折れ線グラフ、散布図、地図、ダッシュボードなどを使えば、部門ごとの違いや時間による変化を共有しやすくなります。
統計分析では、平均値だけで判断せず、中央値、ばらつき、比率、相関関係なども確認します。
売上の平均が上がっていても、一部の高額取引だけが影響している可能性があるためです。
見やすい可視化は、分析の最終成果物ではなく、次に確かめるべき問いを見つける入口と考えるとよいでしょう。
機械学習による予測と分類
機械学習は、過去のデータから規則性を学び、新しいデータに対して予測や分類を行う技術です。
需要を予測する回帰、顧客を似た傾向ごとに分けるクラスタリング、迷惑メールを判別する分類などが代表的です。
AIという言葉は幅広く使われますが、ビッグデータがあれば自動的に高精度なAIが完成するわけではありません。
学習に使うデータの正確さ、偏り、目的変数の定義、評価方法が結果を大きく左右します。
解約予測の例です。
契約期間、利用頻度、問い合わせ回数、料金プラン、過去の解約状況を学習データとして利用します。
解約の可能性が高い顧客を抽出し、利用支援や提案を行った後に、施策による改善効果を検証します。
予測結果を顧客への不利益な扱いに直結させないよう、説明可能性や人による確認も意識したいところです。
データ基盤と分析人材の役割
分析を継続するには、データをためる場所、処理する仕組み、品質を管理するルールが必要です。
この土台はデータ基盤と呼ばれ、データウェアハウス、データレイク、ETLやELT、BIツールなどで構成されることがあります。
また、データサイエンティストだけに任せるのではなく、業務を知る担当者、IT担当者、経営者が協力する体制も重要です。
現場の問いを分析課題へ翻訳できる人がいると、数字だけでは終わらない改善へつながります。
小規模な組織では、まず既存の販売データを見える化し、意思決定に使う習慣を作るところから始めても十分です。
ビジネスにおけるビッグデータ活用例
続いては、ビジネスにおけるビッグデータ活用例を確認していきます。
小売業とECにおける需要予測
小売業やECでは、購買履歴、閲覧履歴、カート投入、在庫、価格、クーポン利用などのデータを活用できます。
需要を予測できれば、欠品による販売機会の損失や、過剰在庫による値引きロスを抑えやすくなります。
顧客ごとの閲覧傾向を基に、関連商品や再購入候補を提案するレコメンドも活用例の一つです。
ただし、過度な追跡と受け取られないよう、利用目的を示し、安心して使える設計に配慮する必要があります。
売上向上だけでなく、顧客が探しやすく選びやすい体験を作る視点が、長期的な価値につながります。
製造業における品質管理と予知保全
製造業では、設備の温度、振動、電流値、稼働時間、検査画像、不良履歴などを分析対象にできます。
通常と異なる振動や温度上昇を早めに見つけられれば、重大な故障の前に点検を行える可能性があります。
これを予知保全といい、突発停止の低減、生産計画の安定、保守部品の最適化に役立ちます。
予知保全では、異常と判定する基準を現場と共有することが重要です。
通知が多すぎると見逃しにつながり、少なすぎると故障を防げないため、運用しながら基準を調整します。
品質管理でも、製造条件と検査結果を結び付けることで、不良が起きやすい条件を探しやすくなります。
分析だけで完結させず、作業手順や設備設定の改善へ反映することが成果の分かれ目でしょう。
金融、物流、医療における活用
金融分野では、取引の時間、金額、場所、利用パターンから不正利用の可能性を検知する取り組みがあります。
物流では、配送車両の位置、交通状況、荷量、配送先の条件を踏まえ、配送ルートや到着予定を調整します。
医療や健康分野では、診療記録、検査値、画像、ウェアラブル機器の情報などを扱う可能性があります。
ただし、こうした分野は個人の生活や安全に影響しやすいため、データの利便性とプライバシー保護を両立する姿勢が特に求められます。
| 業種 | 活用するデータの例 | 主な目的 |
|---|---|---|
| 小売とEC | 購買履歴、閲覧履歴、在庫、気象情報 | 需要予測、商品提案、在庫最適化 |
| 製造 | センサー値、検査画像、設備履歴 | 異常検知、品質改善、予知保全 |
| 金融 | 取引履歴、利用時間、端末情報 | 不正検知、リスク管理 |
| 物流 | 位置情報、交通情報、荷量、配送実績 | 配車、ルート、到着時刻の最適化 |
| 医療と健康 | 検査値、診療記録、活動量 | 支援の高度化、研究、予防への活用 |
ビッグデータ活用に必要な注意点
続いては、ビッグデータ活用に必要な注意点を確認していきます。
データ品質と前処理の重要性
入力漏れ、表記ゆれ、重複、古い情報、誤った値が多い状態では、どれほど高度な分析技術を使っても信頼できる結果を得にくくなります。
たとえば顧客名が複数の表記で登録されていると、同じ人を別の顧客として数えてしまうことがあります。
分析前には、データの欠損、重複、異常値、項目定義を確認し、必要に応じて整形する前処理を行います。
分析作業の多くは、モデル作成よりもデータを使える状態に整える工程に費やされます。
地味な作業に見えても、再現性のある判断を支える大切な工程です。
個人情報とセキュリティの配慮
顧客情報や従業員情報を扱う場合は、利用目的に必要な範囲で収集し、アクセス権限を適切に管理する必要があります。
氏名や連絡先だけでなく、位置情報、購買履歴、端末情報なども、組み合わせによって個人を推測できる場合があります。
社内で自由に閲覧できる状態を避け、役割に応じて権限を分け、利用履歴を残す仕組みが望まれます。
外部サービスや委託先を利用する際は、保管場所、契約内容、削除方法、事故発生時の連絡体制も確認しましょう。
データ活用の信頼は、一度の便利な施策よりも、透明性のある説明と安全な運用の積み重ねで築かれます。
小さく始めて効果を測る進め方
最初から全社のデータを統合し、大規模なAI導入を目指すと、時間も費用も膨らみやすくなります。
まずは一つの部門、一つの課題、一つの指標に絞り、小規模な検証を行う方法が現実的です。
小さく始める手順の例です。
最初に、改善したい指標を決めます。
次に、利用できるデータを確認し、簡単な集計や可視化で仮説を作ります。
施策を実行した後は、実施前後や対象群との差を測り、継続、修正、停止を判断します。
成果が出た取り組みを横展開すると、現場の理解を得やすくなります。
ビッグデータは特別な部署だけのものではなく、日々の業務改善を積み重ねるための材料として捉えるとよいでしょう。
ビッグデータの意味と活用のまとめ
ビッグデータとは、大量で高速に発生し、形式も多様なデータを収集、処理、分析して、事業の判断や改善に役立てる考え方です。
通常データとの違いは量だけではなく、ログ、画像、音声、位置情報などを含む多様性と、迅速な処理が必要になる点にもあります。
3VであるVolume、Velocity、Varietyを理解すると、なぜ従来の管理方法だけでは対応しにくいのかを整理できます。
需要予測、レコメンド、不正検知、品質管理、予知保全など、活用できる領域は幅広いでしょう。
一方で、データ品質、個人情報保護、セキュリティ、運用体制を軽視すると、期待した成果につながりません。
課題を明確にし、必要なデータを選び、小さな検証から改善を続けることが、データ主導経営への着実な一歩になります。