機械学習モデルの性能を評価するとき、正解率だけでは判断しにくい場面があります。
たとえば、迷惑メール判定や不正取引の検知では、陽性と予測したデータが本当に陽性だった割合を確認することが重要です。
そこで用いられる指標が適合率です。
この記事では、適合率の意味、計算式、混同行列との関係、再現率との違いを、具体例を交えてわかりやすく解説します。
適合率の意味と結論
それではまず、適合率の基本的な意味について解説していきます。
陽性と予測した結果の正しさ
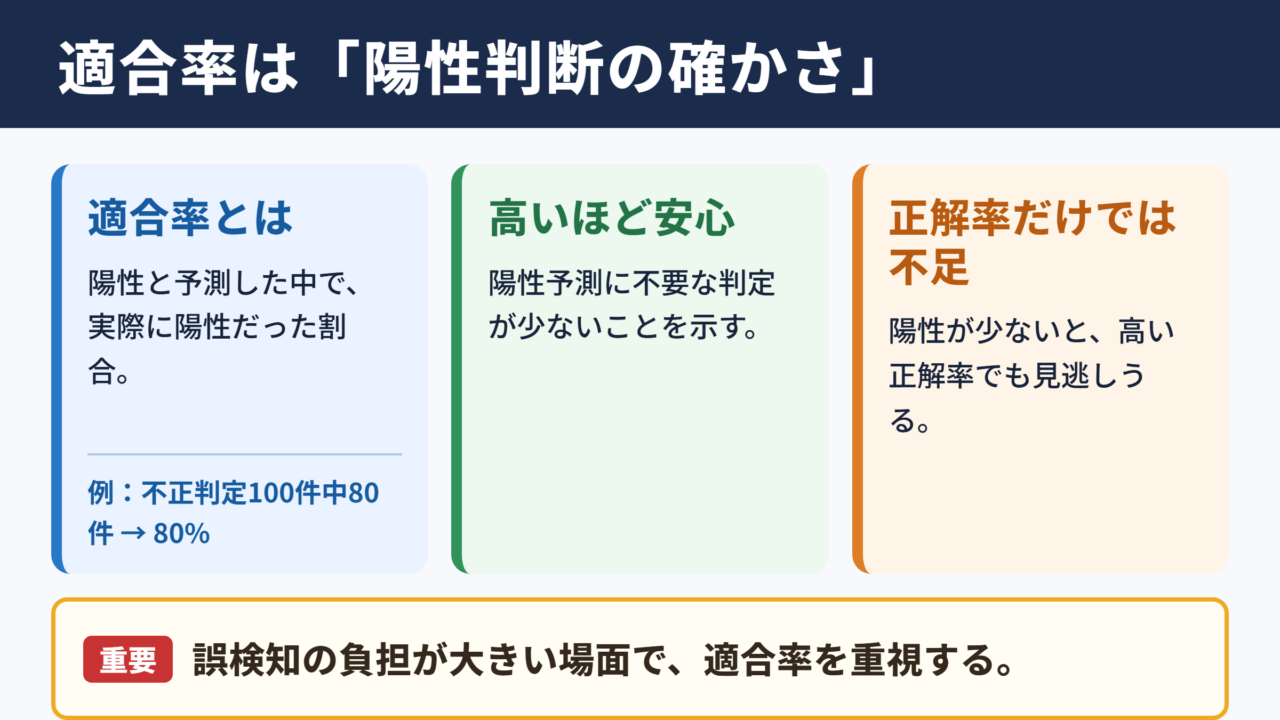
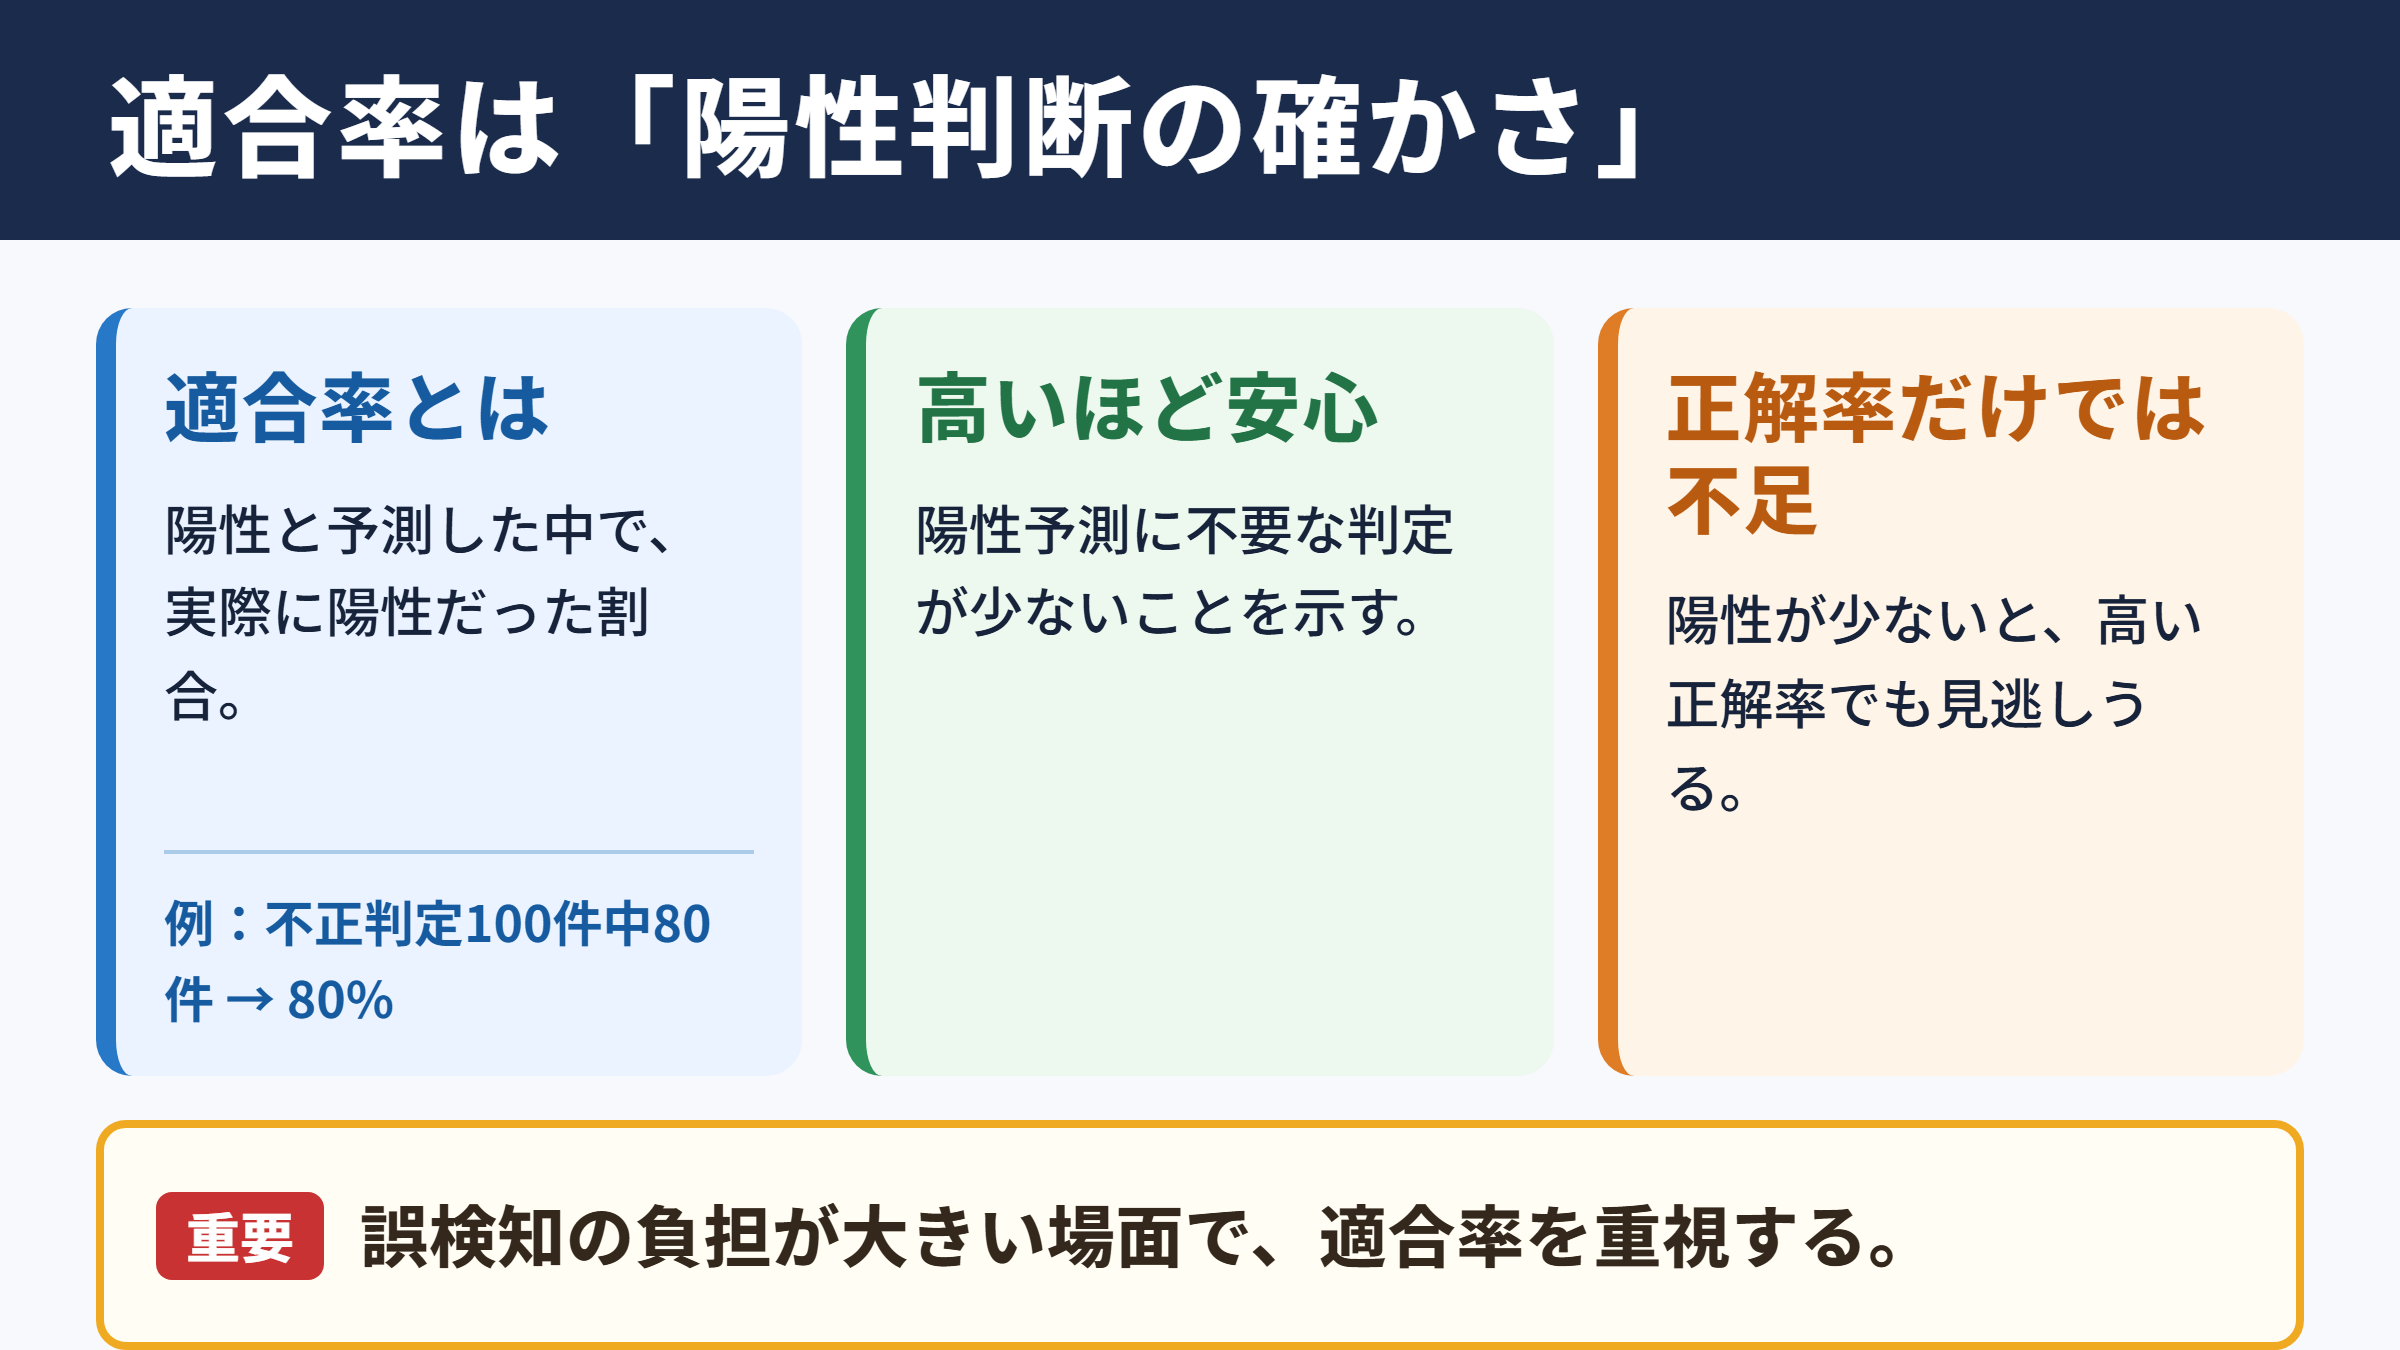
適合率は、モデルが陽性と予測したデータのうち、実際にも陽性だったデータの割合を表す評価指標です。
英語ではPrecisionと呼ばれ、検索システム、画像認識、医療診断、スパムメール判定など、多くの機械学習分野で活用されています。
たとえば、あるシステムが100件を不正取引と判定し、そのうち80件が実際に不正取引だった場合、適合率は80パーセントです。
つまり、陽性とした判断がどれほど的確だったかを測る数値と考えると理解しやすいでしょう。
適合率が高いほど、陽性と予測した対象に不要な判定が少ないことを意味します。
誤って陽性と判定することを避けたい業務では、特に重視される指標です。
適合率が重要になる場面
適合率が重要なのは、誤検知による負担や損失が大きいケースです。
たとえば、メールを迷惑メールとして自動振り分けする機能では、重要な取引先からのメールを誤って隔離すると業務に影響が及ぶ可能性があります。
このため、迷惑メールと判定したメールが本当に迷惑メールである確度を高める必要があります。
採用候補者の絞り込み、犯罪検知、広告配信の対象選定でも、不要な候補を多く含めない視点が求められます。
正解率だけでは不足する理由
正解率は、すべての予測のうち正しかった割合を示すわかりやすい指標です。
しかし、陽性データが極端に少ない不均衡データでは、正解率が高くても実用的とは限りません。
たとえば1万件中100件だけが不正取引である場合、すべて正常と予測しても正解率は99パーセントになります。
不正取引を一件も発見できていないため、この評価だけでは不十分です。
適合率は、陽性予測の品質を個別に確かめるための重要な補助線になります。
混同行列と四つの分類
続いては、適合率を理解する基礎となる混同行列を確認していきます。
混同行列の構成
混同行列は、実際の正解とモデルの予測を組み合わせて整理した表です。
二値分類では、真陽性、偽陽性、真陰性、偽陰性の四つに分けて結果を確認します。
| 分類 | 実際の状態 | モデルの予測 | 意味 |
|---|---|---|---|
| 真陽性 | 陽性 | 陽性 | 陽性を正しく陽性と判定した結果 |
| 偽陽性 | 陰性 | 陽性 | 陰性を誤って陽性と判定した結果 |
| 真陰性 | 陰性 | 陰性 | 陰性を正しく陰性と判定した結果 |
| 偽陰性 | 陽性 | 陰性 | 陽性を見逃して陰性と判定した結果 |
適合率の計算で使うのは、真陽性と偽陽性です。
陽性と予測された件数の内訳を見るため、予測結果に着目する指標といえます。
真陽性と偽陽性の関係
真陽性は、モデルが期待どおりに陽性を見つけられた件数です。
一方の偽陽性は、本来は陰性であるにもかかわらず、陽性として扱ってしまった件数を示します。
偽陽性が増えるほど、陽性予測の信頼性は低下します。
そのため、適合率を改善したい場合には、偽陽性をどう減らすかが大きな課題になります。
判定結果を表で確認する方法
実際の業務では、混同行列を作成して数値を一覧化すると、モデルの偏りを把握しやすくなります。
| 実際に陽性 | 実際に陰性 | |
|---|---|---|
| 陽性と予測 | 真陽性 45件 | 偽陽性 15件 |
| 陰性と予測 | 偽陰性 5件 | 真陰性 935件 |
この例では、陽性と予測した件数は60件です。
そのうち45件が真陽性なので、適合率は45を60で割った75パーセントとなります。
大量の正常データがある場合も、陽性予測の質をこのように独立して確認できます。
適合率の計算式と求め方
続いては、適合率の計算式と実際の求め方を確認していきます。
基本となる計算式
適合率は、真陽性を真陽性と偽陽性の合計で割って求めます。
適合率 = 真陽性 ÷ 真陽性と偽陽性の合計
Precision = TP ÷ TP + FP
TPは真陽性を表し、FPは偽陽性を表す略語です。
分母はモデルが陽性と予測した全件数、分子はその中で正解だった件数になります。
予測した陽性のうち、どれだけ当たっていたかという見方が計算式にもそのまま表れています。
数値を用いた計算例
ある画像認識モデルが、100枚の画像から犬が写っている画像を40枚検出したとします。
調査すると、40枚のうち30枚には実際に犬が写っており、残り10枚は犬ではありませんでした。
真陽性は30件です。
偽陽性は10件です。
適合率 = 30 ÷ 30 + 10 = 0.75
適合率は75パーセントです。
このモデルが犬と判定した画像の4枚に3枚は正しかったことになります。
残る4枚に1枚は、猫やぬいぐるみなどを犬と誤認した可能性があります。
ゼロ除算への注意点
モデルが陽性を一件も予測しなかった場合、真陽性と偽陽性の合計がゼロになります。
このとき、通常の計算式では適合率を求められません。
利用するライブラリやツールによっては、警告を出したうえでゼロとして処理する設定や、計算不能として扱う設定があります。
数値だけを確認するのではなく、陽性予測の件数そのものも確認する姿勢が大切です。
適合率が高くても、陽性予測が一件だけではモデルの性能を十分に評価できません。
件数、再現率、業務上の影響を合わせて判断することが欠かせません。
再現率と正解率との違い
続いては、適合率と混同されやすい再現率、正解率との違いを確認していきます。
再現率が示す範囲
再現率は、実際に陽性であるデータのうち、モデルが陽性として発見できた割合です。
英語ではRecallと呼ばれ、見逃しの少なさを確認するために使われます。
再現率 = 真陽性 ÷ 真陽性と偽陰性の合計
Recall = TP ÷ TP + FN
適合率が陽性予測の正確さを見るのに対し、再現率は本来見つけるべき陽性をどれほど拾えたかを見る点が違いです。
対象となる分母が異なるため、同じモデルでも二つの数値は大きく変わることがあります。
適合率と再現率の比較
| 指標 | 主な問い | 重視する失敗 | 代表的な活用例 |
|---|---|---|---|
| 適合率 | 陽性とした予測は正しいか | 偽陽性 | スパム判定、広告配信、誤警報の抑制 |
| 再現率 | 本当の陽性を見つけられたか | 偽陰性 | 病気のスクリーニング、不正検知、異常検出 |
| 正解率 | 全体としてどれだけ正解したか | 全種類の誤り | データ分布が比較的均衡した分類 |
たとえば病気の一次検査では、陽性者の見逃しを減らすため再現率を優先する場面があります。
一方で、精密検査の負担を抑えたい場合は、適合率も重要になります。
どちらを優先すべきかは、誤検知と見逃しのどちらがより大きな問題かによって決まります。
正解率との使い分け
正解率は、真陽性と真陰性の合計を全データ数で割った値です。
全体像の把握には役立ちますが、陽性と陰性の件数に大きな差がある場合は誤解を招くことがあります。
たとえば、1000件中10件だけが陽性なら、すべて陰性と予測しても99パーセントの正解率です。
このモデルは陽性をまったく検出できないため、現場で求められる役割を果たせません。
不均衡データを扱うときは、適合率、再現率、F値、混同行列を組み合わせることが一般的です。
閾値調整と性能評価の実務
続いては、適合率を改善するための閾値調整と実務上の見方を確認していきます。
閾値が与える影響
多くの分類モデルは、陽性である確率やスコアを出力します。
その値が一定の閾値を超えたときに陽性と判定する仕組みです。
閾値を高くすると、確信度の高い対象だけを陽性にするため、適合率が上がりやすくなります。
ただし、陽性と判定される件数が減り、再現率が下がる場合があります。
閾値を上げれば適合率が必ず実用的になるとは限りません。
陽性を見つける件数と誤検知を減らす効果のバランスを、業務目的に応じて検討します。
F値によるバランス評価
適合率と再現率を一つの数値で確認したいときには、F値が用いられます。
代表的なF1スコアは、適合率と再現率の調和平均です。
どちらか一方だけが極端に低い場合、F1スコアも高くなりにくい特徴があります。
適合率だけを高めて陽性予測を極端に絞り込むような評価を、防ぎやすくなるでしょう。
適合率、再現率、F1スコアは競合する数値ではなく、目的に応じて補い合う評価軸です。
検証データで確認する項目
モデルを評価するときは、学習に使っていない検証データやテストデータで適合率を確認します。
学習データだけで高い数値が出ても、新しいデータに同じ精度で対応できるとは限りません。
また、全体の適合率だけでなく、商品カテゴリ、地域、年齢層、期間などに分けた結果を見ることも有効です。
一部の条件で偽陽性が増えていないかを確認すれば、偏りやデータ品質の問題を早期に発見できます。
評価結果は定期的に見直し、実際の運用後に得られる正解データも反映していく流れが望ましいでしょう。
適合率の活用例と注意点
続いては、適合率が使われる具体例と、数値を読むときの注意点を確認していきます。
検索エンジンとレコメンド
検索エンジンでは、検索結果の上位に表示されたページが利用者の意図に合っているかが重要です。
関連性の低いページが上位に多く並ぶと、利用者は必要な情報にたどり着きにくくなります。
この場面では、提示した結果の中に関連ページがどれだけ含まれるかを確認するため、適合率の考え方が役立ちます。
商品レコメンドでも、興味がない商品を頻繁に勧めるより、対象を絞って関連性の高い提案を行うほうが満足度につながることがあります。
迷惑メールと不正利用の検知
迷惑メールフィルタでは、偽陽性が重要なメールの見落としにつながります。
そのため、迷惑メールとして自動処理する判定には、高い適合率が求められることがあります。
クレジットカードの不正利用検知でも、正常な取引を不正と判定すると、利用者の決済が止まるおそれがあります。
一方で、不正を見逃せば被害が拡大する可能性もあります。
このような領域では、適合率だけでなく、再現率、判定後の確認手順、顧客への影響まで含めた設計が必要です。
数値の比較で気を付ける点
適合率を比較するときは、同じデータセット、同じ陽性の定義、同じ閾値条件であることを確認します。
評価対象や判定ルールが違えば、数値だけを並べても公平な比較にはなりません。
また、陽性予測の件数が少ない場合は、偶然によって適合率が大きく変動する可能性があります。
単一期間の結果だけで結論を出さず、複数期間での推移や信頼区間も確認すると安心です。
高い適合率は目的達成の手段であり、数値そのものを最大化することが最終目標ではありません。
適合率のまとめ
適合率は、モデルが陽性と予測したデータのうち、実際にも陽性だった割合を示す指標です。
計算式は、真陽性を真陽性と偽陽性の合計で割る形になります。
偽陽性を抑え、陽性と判定した結果の信頼性を高めたい場合に、特に役立つ考え方です。
再現率は見逃しの少なさ、正解率は全体の正しさを見るため、適合率とは役割が異なります。
混同行列で真陽性、偽陽性、真陰性、偽陰性を確認し、目的に合わせて複数の評価指標を組み合わせましょう。
適合率を正しく読み解くことは、機械学習モデルを安全かつ実用的に運用する第一歩となります。