機械学習や情報検索、生成AIの評価を学び始めると、適合率と再現率の違いで迷う場面が出てきます。
どちらも正解をどれだけ見つけられたかに関係する指標ですが、見る方向が異なるため、式だけを暗記すると混同しやすいでしょう。
この記事ではPrecisionとRecallの意味、覚え方、語呂合わせ、混同行列との対応、実務での使い分けまでを順番に整理します。
正しいと判定した結果の確かさを見るのが適合率であり、実際に正しいものを取りこぼさず見つける度合いを見るのが再現率です。
適合率と再現率の結論
それではまず適合率と再現率の結論について解説していきます。
適合率が表す判定結果の確かさ
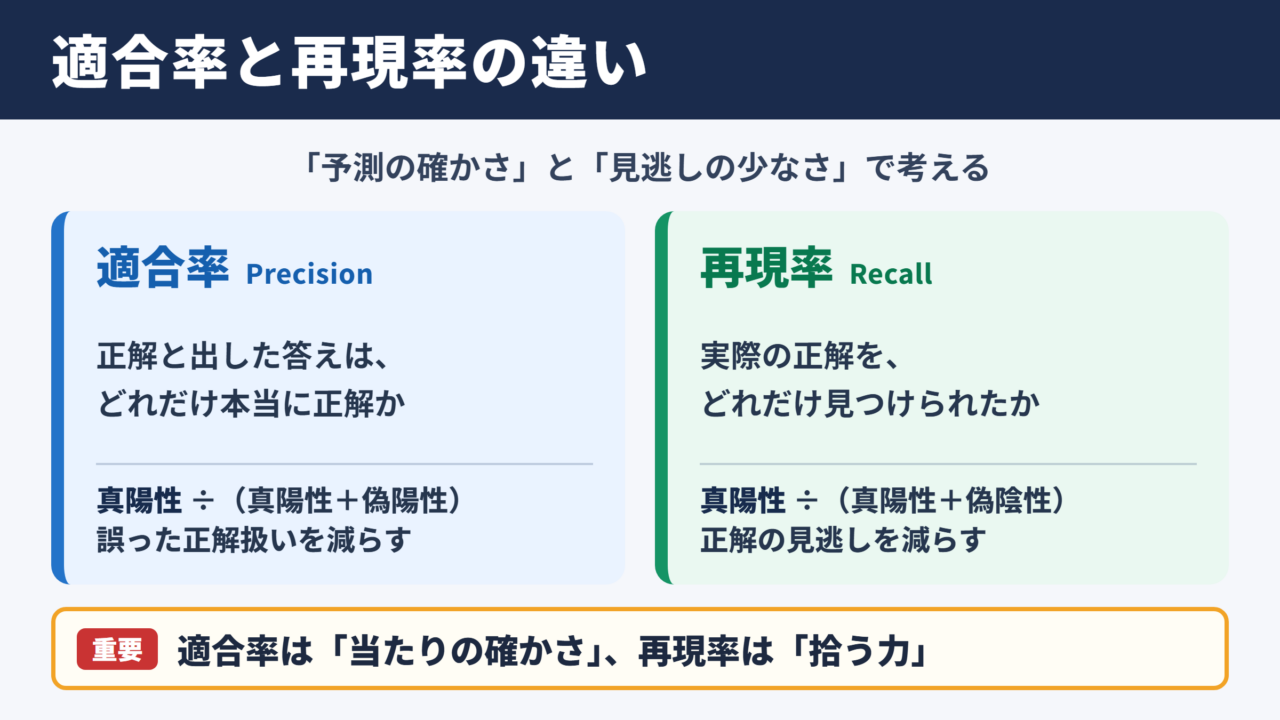
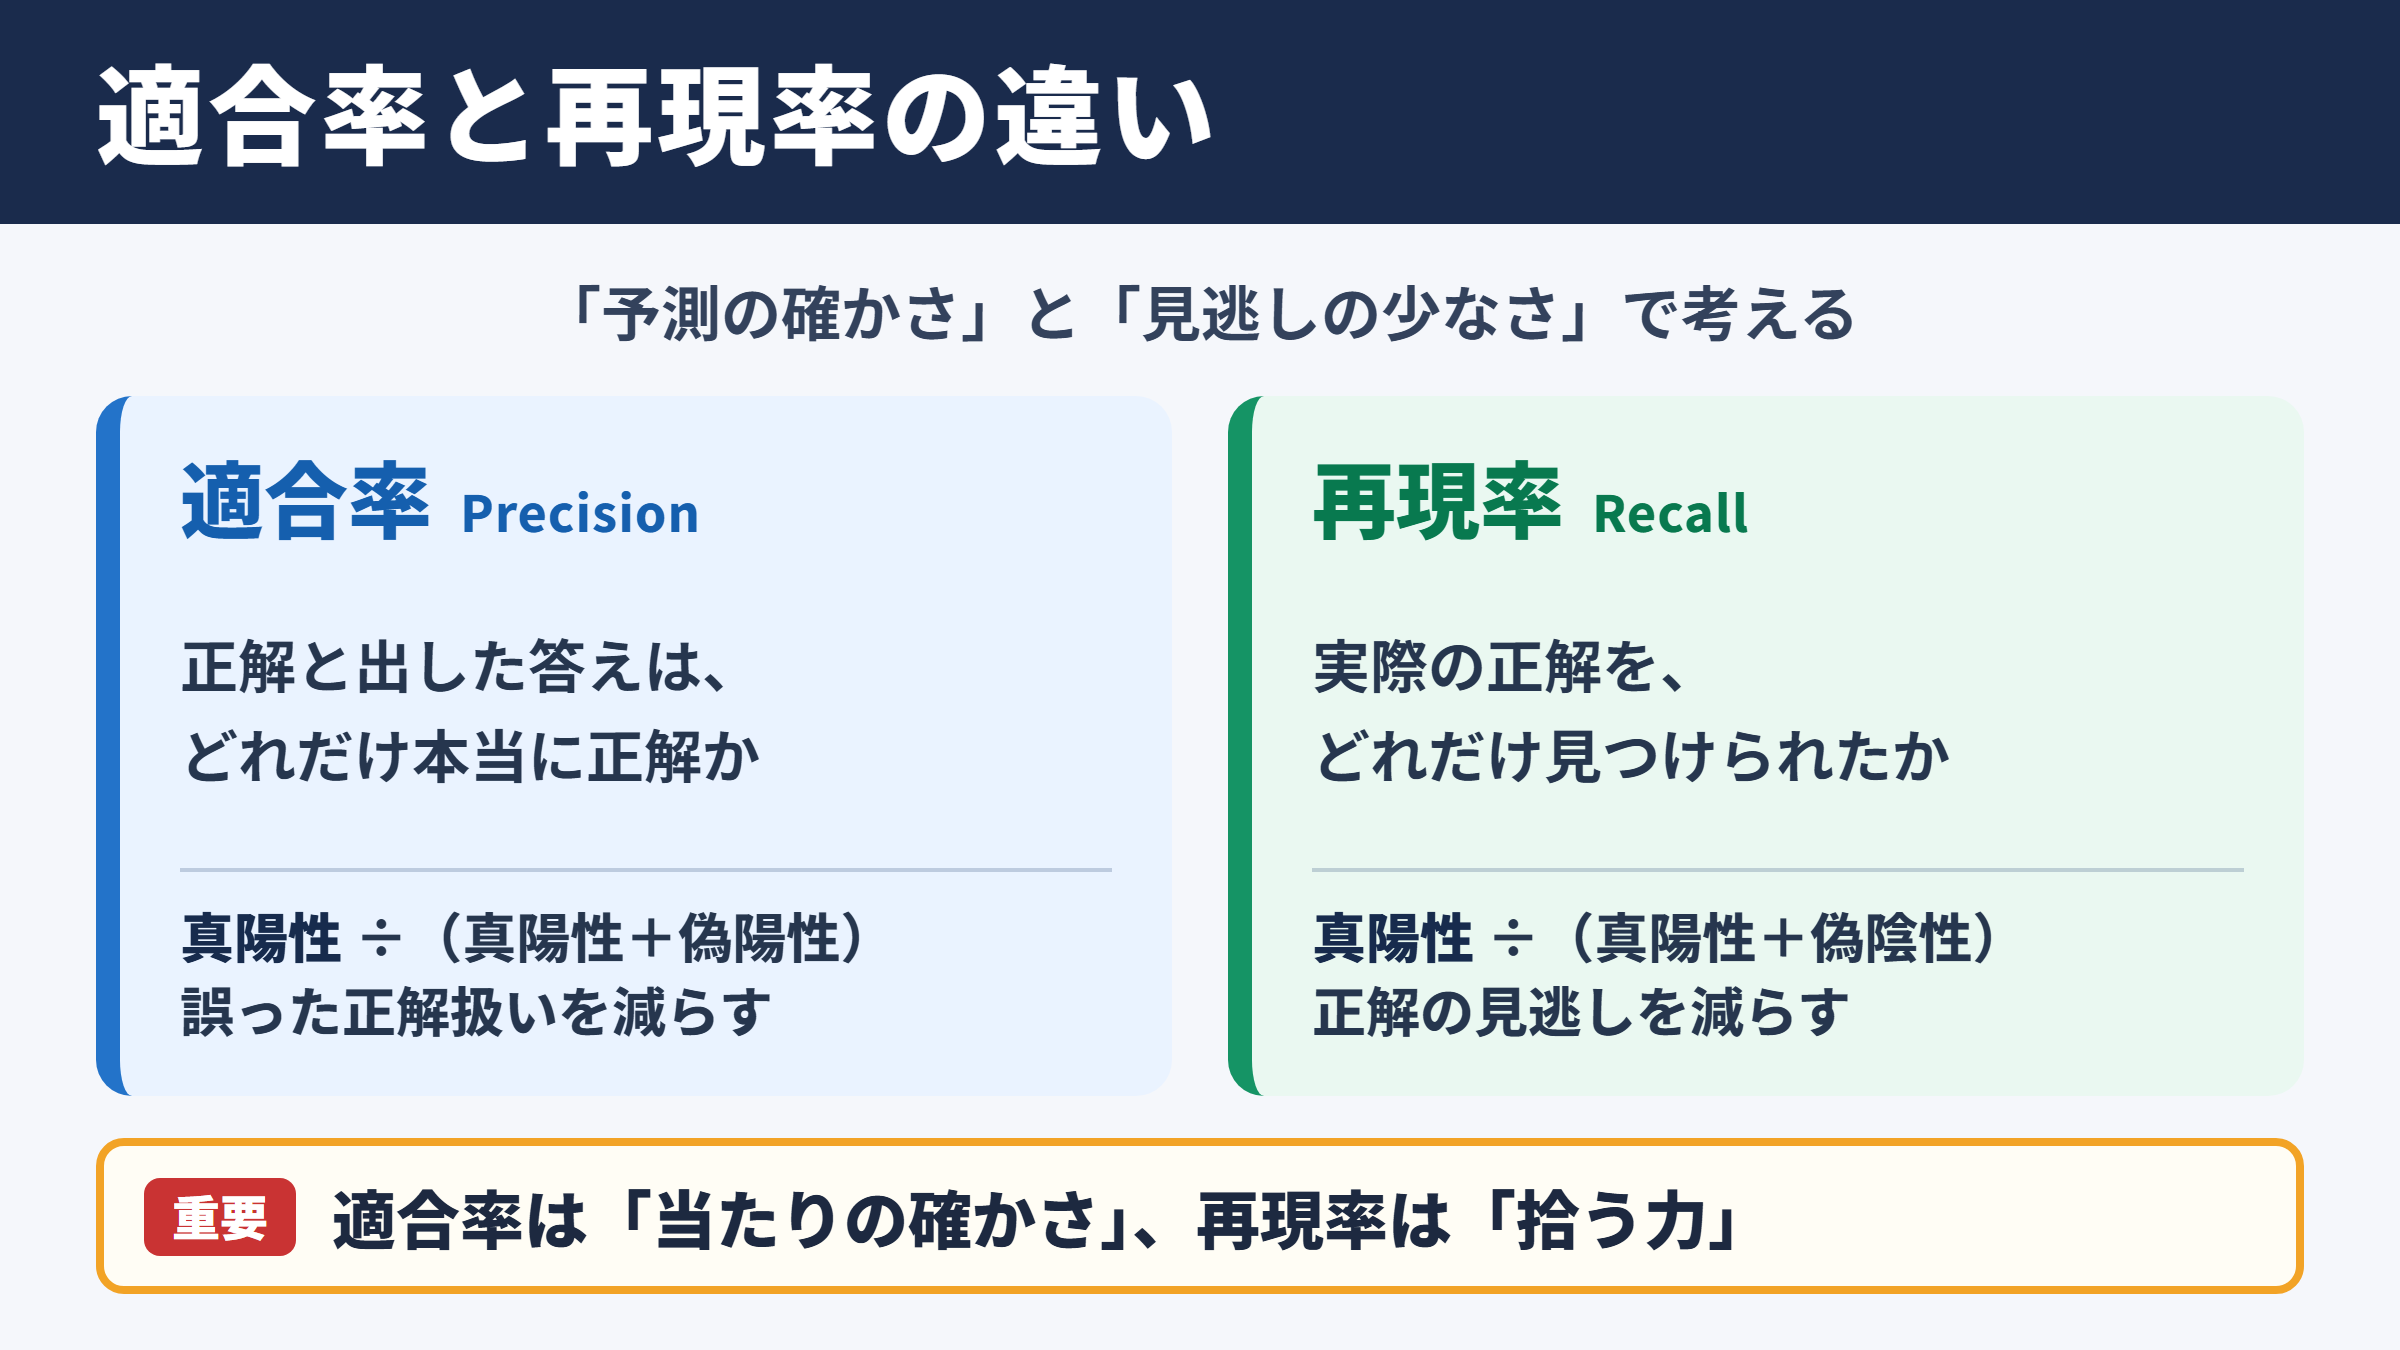
適合率は、システムが正解だと判断したもののうち、実際に正解だった割合を示す指標です。
英語ではPrecisionと呼ばれ、予測した陽性の結果がどれほど正確だったかを確認します。
たとえば迷惑メール判定で、迷惑メールだと振り分けた100件のうち90件が本当に迷惑メールなら、適合率は90パーセントです。
一方で、残り10件が必要なメールなら、ユーザーにとって不便が生じる可能性があります。
適合率は誤って正解扱いしたケースを少なくしたいときに重視する数値と考えると理解しやすくなります。
適合率の式
適合率 = 真陽性 ÷ 真陽性と偽陽性の合計
真陽性は正解を正解と判定した件数です。
偽陽性は不正解を正解と判定した件数です。
再現率が表す見逃しの少なさ
再現率は、実際に正解であるもののうち、システムが正解として見つけられた割合を表します。
Recallとも呼ばれ、存在する正解をどれだけ回収できたかを見るための指標です。
病気の検査を例にすると、実際に病気の人が100人いて、そのうち95人を陽性と判定できた場合、再現率は95パーセントになります。
この場合に重要なのは、病気であるにもかかわらず陰性とされた5人の存在です。
再現率は見逃しを抑えたい場面で特に重要になる評価軸です。
再現率の式
再現率 = 真陽性 ÷ 真陽性と偽陰性の合計
偽陰性は正解なのに不正解と判定した件数です。
実際の正解を分母に置く点が、適合率との大きな違いになります。
二つの指標を一言で分ける考え方
適合率は、出した答えがどれだけ当たっているかを見る数値です。
再現率は、本来見つけるべき答えをどれだけ拾えたかを見る数値といえます。
適合率の視点は予測結果から始まり、再現率の視点は現実に存在する正解から始まります。
ここを押さえると、似た式でも分母の意味を取り違えにくくなるでしょう。
適合率は当たりと答えたものの純度です。
再現率は本当の当たりをどれだけ取りこぼさず回収したかです。
PrecisionとRecallの覚え方
続いてはPrecisionとRecallの覚え方を確認していきます。
Precisionを精密さとして結び付ける方法
Precisionには精密さ、正確さ、狙いの細かさという意味があります。
日本語の適合率だけで覚えにくい場合は、Precisionを精密に狙いを定めるイメージで覚えると便利です。
狙った的に当たった矢だけを見て、その矢の中に外れが少ない状態が高いPrecisionです。
検索エンジンで特定の商品を探したとき、表示された商品が求める条件に合うものばかりなら、検索結果の適合率は高いと考えられます。
Precisionは予測した陽性に注目するという短いフレーズを、式と一緒に覚えておくとよいでしょう。
Recallを呼び戻す感覚で結び付ける方法
Recallには思い出す、呼び戻す、回収するという意味があります。
評価指標のRecallでは、正解として存在するデータをどこまで呼び戻せたか、あるいは回収できたかを考えます。
図書館の蔵書検索で、条件に合う本が20冊あるのに12冊しか表示されなければ、検索結果が正確に見えても再現率は十分ではありません。
正解の候補を広く集めたい採用支援や不正検知では、Recallという言葉の回収イメージが役立ちます。
Recallは実際にある陽性を取り戻す指標と覚えると、分母を自然に思い出せます。
語呂合わせで分母を区別する方法
語呂合わせは、意味の理解を補強する道具として使うと効果的です。
適合率は「予測に適合した正解の率」、再現率は「現実の正解を再現できた率」と言い換える方法があります。
より短く覚えるなら、適合率は「当てた中の当たり」、再現率は「当たり全部のうち発見」と整理できます。
| 指標 | 覚え方 | 分母 | 重視する失敗 |
|---|---|---|---|
| 適合率 | 当てた中の当たり | 陽性と予測した件数 | 偽陽性 |
| 再現率 | 当たり全部のうち発見 | 実際に陽性の件数 | 偽陰性 |
分母だけを先に覚える方法も有効です。
予測が分母なら適合率、現実が分母なら再現率という対応を繰り返し確認してください。
混同行列と四つの判定結果
続いては混同行列と四つの判定結果を確認していきます。
真陽性と偽陽性の違い
混同行列は、予測と実際の結果を縦横に配置して、判定の内訳を確認する表です。
真陽性は、実際に陽性であり、予測も陽性だったケースを指します。
偽陽性は、実際には陰性なのに、予測では陽性とされたケースです。
迷惑メールではない通常のメールを迷惑メールに入れてしまう事例が、偽陽性に当たります。
適合率を高めるには、この偽陽性を抑える必要があります。
真陰性と偽陰性の違い
真陰性は、実際に陰性であり、予測も陰性だったケースです。
偽陰性は、実際には陽性なのに、予測では陰性とされたケースを意味します。
医療検査で病気の人を健康と判定する例や、不正取引を見逃す例が代表的です。
再現率を高めたいときは、偽陰性を減らす工夫が求められます。
適合率では偽陽性、再現率では偽陰性を見ると決めておくと、混同行列が読みやすくなります。
混同行列から式を組み立てる手順
混同行列を見たら、最初に真陽性の位置を確認します。
次に適合率では、予測が陽性になった列または行をたどり、真陽性と偽陽性を合計します。
再現率では、実際が陽性になった列または行をたどり、真陽性と偽陰性を合計してください。
| 実際と予測 | 予測が陽性 | 予測が陰性 |
|---|---|---|
| 実際が陽性 | 真陽性 | 偽陰性 |
| 実際が陰性 | 偽陽性 | 真陰性 |
適合率では真陽性と偽陽性を使います。
再現率では真陽性と偽陰性を使います。
どちらも真陽性から始め、追加する誤りの種類だけが異なります。
混同しやすいポイント
続いては混同しやすいポイントを確認していきます。
正解率との違い
正解率は、全体の予測のうち正しく判定できた割合です。
真陽性と真陰性を足し、全データ数で割って求めます。
一見すると分かりやすい指標ですが、陽性データが非常に少ない不均衡データでは判断を誤ることがあります。
たとえば1000件中10件しか不正がない場合、すべて正常と予測しても正解率は99パーセントになります。
しかし不正を1件も見つけていないため、再現率は0パーセントです。
正解率が高くても、適合率と再現率が優れているとは限りません。
適合率と再現率のトレードオフ
多くの分類モデルでは、判定のしきい値を変えると適合率と再現率が反対方向に動きやすくなります。
陽性と判定する基準を厳しくすれば、外れを減らせるため適合率は上がりやすい一方、正解まで除外して再現率が下がる場合があります。
反対に基準を緩めると、正解を多く拾えるため再現率は上がりやすいものの、外れも混じりやすくなります。
適合率と再現率のどちらを優先するかは、数値だけで決めるものではありません。
誤検知と見逃しのどちらが大きな損失になるかを、利用場面に沿って考えることが大切です。
F値との関係
F値は、適合率と再現率を一つの数値でバランスよく評価したいときに使われます。
特にF1スコアは、二つの指標の調和平均です。
片方だけが高く、もう片方が低いケースでは、F1スコアも高くなりにくい特徴があります。
ただしF1スコアだけを見れば十分というわけではありません。
医療やセキュリティのように見逃しを強く避けたい場面では、再現率を独立して確認する必要があります。
F値は総合評価、適合率と再現率は失敗の種類を読むための評価として使い分けましょう。
実務における使い分け
続いては実務における使い分けを確認していきます。
適合率を優先しやすい場面
適合率を重視しやすいのは、誤検知による負担が大きい場面です。
たとえば顧客に送る商品レコメンドで関係のない商品ばかりを表示すると、利用者の信頼を損ねるおそれがあります。
メールの自動分類でも、重要なメールを迷惑メールとして隔離する誤りは避けたいところです。
人の確認作業が発生する審査システムでも、誤検知が多いと担当者の工数が増えてしまいます。
陽性と通知した後の行動コストが高いなら、適合率を優先する発想が有効です。
再現率を優先しやすい場面
再現率を優先しやすいのは、見逃しの影響が大きい場面です。
医療画像から重大な兆候を探す補助システム、不正アクセスの監視、災害情報の検出などが例として挙げられます。
このような領域では、多少の誤検知があっても、重要な対象を取りこぼさないことが優先されるでしょう。
その後に専門家の目視確認や追加検査を組み合わせれば、再現率を高めたうえで誤判定を絞り込めます。
評価指標を選ぶための判断軸
指標を選ぶ際は、陽性と判定した後に誰が何をするのかを考えると判断しやすくなります。
陽性通知がただちに大きな負担や損失につながるなら、適合率を注視します。
陰性とした対象を後から発見できず、大きな不利益が起きるなら、再現率を優先してください。
| 利用場面 | 優先しやすい指標 | 理由 |
|---|---|---|
| 迷惑メールの自動隔離 | 適合率 | 必要なメールの隔離を減らしたい |
| 病気のスクリーニング | 再現率 | 患者の見逃しを抑えたい |
| 不正検知の一次監視 | 再現率 | 疑わしい取引を広く拾いたい |
| 広告の配信対象選定 | 適合率 | 関心の薄い人への配信を抑えたい |
| 検索システムの改善 | 両方 | 関連結果と網羅性の両立が必要 |
数値の高低だけでモデルを評価するのではなく、誤検知と見逃しの業務上の影響を確認しましょう。
そのうえで適合率、再現率、F値、正解率を組み合わせると、評価の偏りを減らせます。
適合率と再現率のまとめ
適合率と再現率は、どちらも分類モデルや検索結果を評価する重要な指標です。
適合率は、陽性と予測したものの中でどれだけ正解だったかを表します。
再現率は、実際に陽性であるものをどれだけ見つけられたかを示します。
適合率は当てた中の当たり、再現率は当たり全部のうち発見と覚えると、意味と分母を一緒に整理できます。
さらにPrecisionは精密に当てる感覚、Recallは正解を回収する感覚と結び付けると、英語表記でも迷いにくくなるでしょう。
混同行列では、適合率が真陽性と偽陽性、再現率が真陽性と偽陰性を使う点が要点です。
モデルの評価では、正解率だけでは見えない誤検知や見逃しが存在します。
目的に応じて二つの指標を読み分け、必要に応じてF値も確認することが、適切なAI評価につながります。