パターンマッチング法とは?種類や手法を解説!(完全一致法:KMP法:ボイヤームーア法:文字列探索など)
パターンマッチング法は、文章やプログラムの中から、指定した文字列や規則に合うデータを探し出すための重要な考え方です。
検索エンジン、テキストエディタ、迷惑メール対策、DNA配列解析など、身近なシステムにも幅広く活用されています。
文字列探索の仕組みを理解すると、アルゴリズムごとの得意分野や処理速度の違いを判断しやすくなるでしょう。
パターンマッチング法の意味と役割
それではまずパターンマッチング法の意味と役割について解説していきます。
文字列探索における基本概念
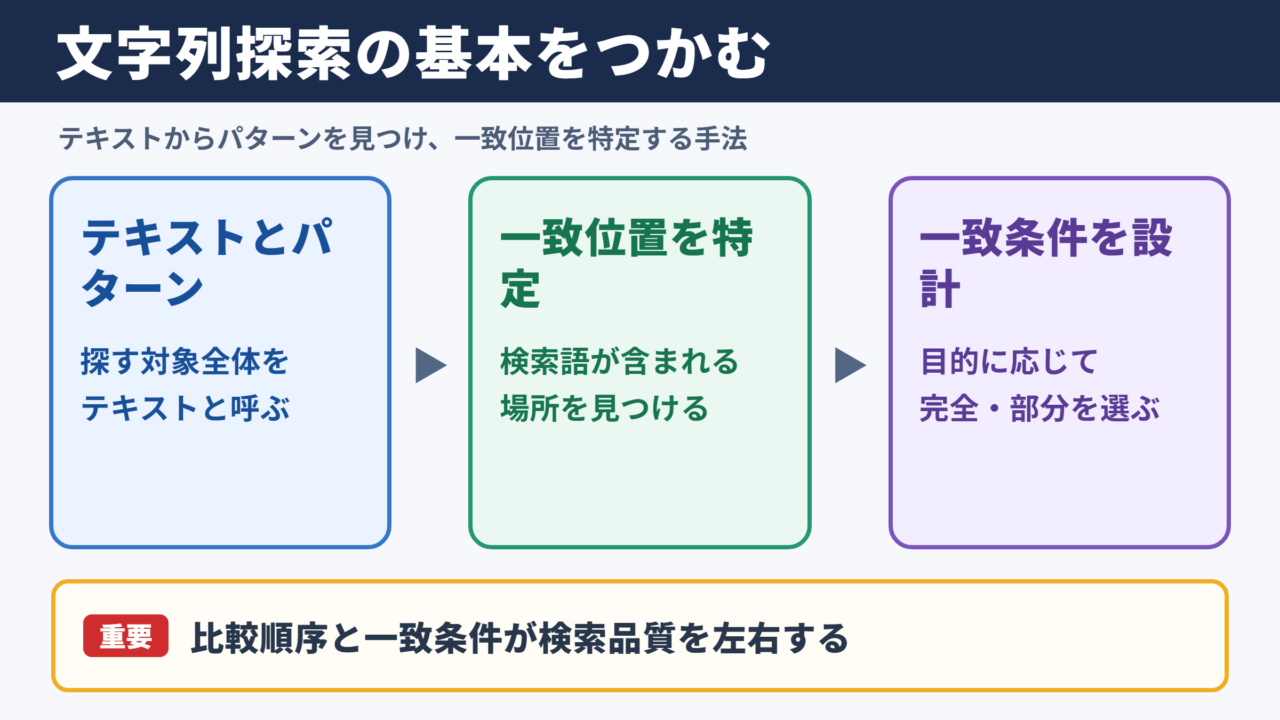
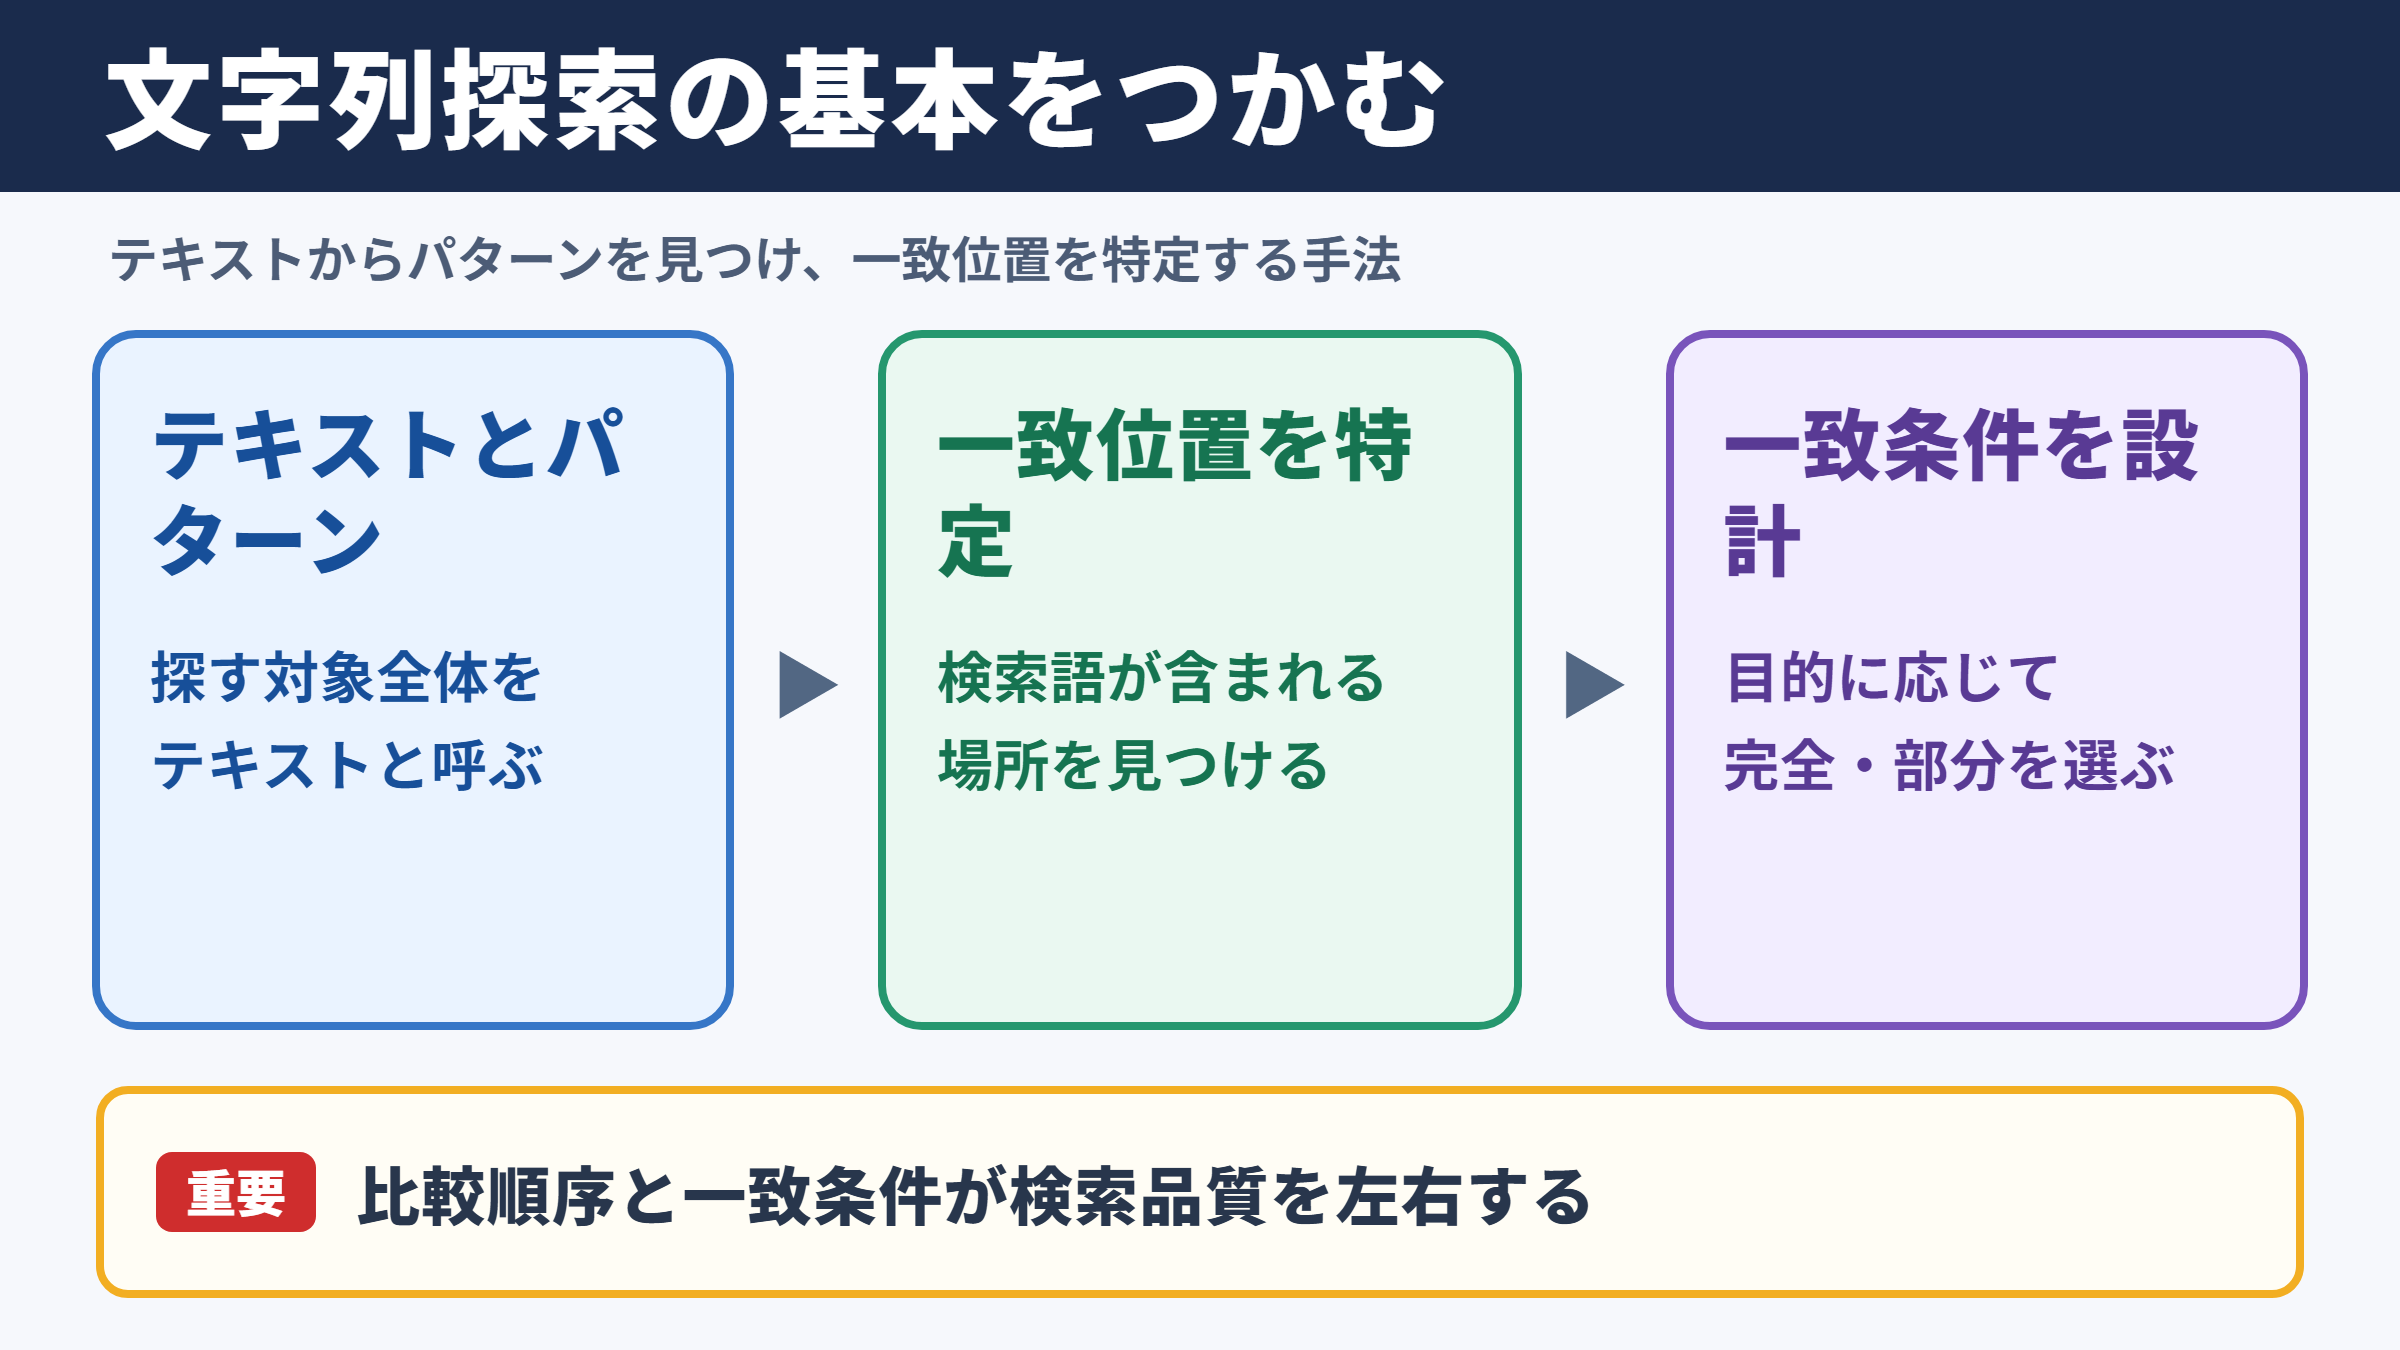
パターンマッチング法とは、長い文字列の中から、探したい文字列を見つけるための手法です。
探索される対象の文章やデータ全体はテキスト、検索したい語句はパターンと呼ばれます。
たとえば「algorithm」という文章の中に「rithm」が含まれているかを確認する処理は、代表的な文字列探索です。
検索対象と検索語を比較し、一致する位置を特定する処理がパターンマッチングの中心となります。
単純な検索であっても、対象データが数件ではなく数百万件になると、比較回数の差が処理時間へ大きく影響します。
そのため、単に見つけるだけでなく、どの順序で文字を比較するかがアルゴリズム設計では重要です。
テキストが「abcabcabd」、パターンが「abcabd」の場合を考えます。
先頭から順番に比較すると途中まで一致する箇所が複数ありますが、最終的には7文字目から始まる部分で一致します。
どの位置まで比較済みかを活用できるかどうかで、探索効率は変わります。
完全一致と部分一致の違い
文字列の比較には、完全一致と部分一致という考え方があります。
完全一致は、文字の並び、文字数、大文字と小文字などの条件がすべて同じ場合に一致とする判定です。
一方の部分一致は、対象テキストの一部に検索パターンが含まれていれば一致とみなします。
Webサイト内検索で商品名の一部を入力して候補が出る仕組みは、部分一致検索のわかりやすい例でしょう。
ただし、日本語検索では全角と半角、ひらがなとカタカナ、表記ゆれも考慮する必要があります。
実務では一致の厳しさを目的に合わせて設計することが、検索品質を左右します。
活用されるシステムと業務
パターンマッチング法は、プログラミングだけで使われる専門技術ではありません。
文書管理システムでは特定の契約条項を探し、ログ監視ではエラーコードや異常な通信記録を検出します。
メールシステムでは危険な語句や不自然な記号の連続を確認し、フィルタリングに役立てる場面もあります。
バイオインフォマティクスの分野では、DNAやタンパク質の配列から特定の並びを探す処理が必要です。
画像認識においても、テンプレートと似た形を見つけるという広い意味でのパターンマッチングが利用されます。
対象が文字列か画像かにかかわらず、大量のデータから意味のある規則を探す技術という点は共通しています。
パターンマッチング法は、検索機能の便利さだけでなく、システムの応答速度や監視精度にも関わります。
データ量が増えるほど、目的に合う探索手法を選ぶ重要性も高まります。
完全一致法の仕組みと特徴
続いては完全一致法の仕組みと特徴を確認していきます。
総当たり比較による探索手順
完全一致法の基本形として知られるのが、先頭から一文字ずつ比較する単純照合です。
検索パターンをテキストの先頭に置き、文字が一致するかを順番に確かめます。
途中で不一致になった場合は、パターンを一文字分ずらして、再び先頭から比較する流れです。
考え方が直感的で実装しやすいため、短い文字列や学習目的ではよく利用されます。
一方で、同じ文字を何度も比較する可能性があり、長い文章では無駄な処理が増えやすい点に注意が必要です。
計算量と処理時間の関係
テキストの長さをn、パターンの長さをmとした場合、単純照合では最悪でn×m回程度の比較が発生します。
これは計算量で表すとO nm と考えられます。
パターンの先頭部分が何度も一致し、最後の文字で不一致になるようなデータでは、比較回数が多くなります。
テキストが「aaaaaaaaaaaa」、パターンが「aaaaab」の場合を考えます。
多くの位置で最初の数文字が一致するため、不一致とわかるまで何度も比較が続きます。
このような重複比較を減らす発想が、KMP法やボイヤームーア法につながります。
単純照合は理解しやすい一方、大規模データには不利になりやすい手法です。
ただし、対象が短い場合や一度しか検索しない場合には、複雑な前処理を行うより効率的なケースもあります。
完全一致法が適する場面
完全一致法は、検索対象が小規模で、プログラムの見通しを優先したい場合に向いています。
設定ファイルから固定のキーワードを探す処理や、入力値が特定の文字列と同じかを確認する処理などが該当します。
パターンが短く、テキスト量も限られるなら、単純な実装で十分な応答速度を得られるでしょう。
また、検索の条件が頻繁に変化する場合も、複雑な前処理が不要な完全一致法は扱いやすい選択肢です。
アルゴリズムを選ぶ際は、理論上の速さだけでなく、開発コスト、保守性、実際のデータ構造も考慮します。
KMP法の前処理と探索効率
続いてはKMP法の前処理と探索効率を確認していきます。
不一致時の比較位置
KMP法は、Knuth、Morris、Prattの三名が考案した文字列探索アルゴリズムです。
特徴は、不一致が起きた際に、すでに一致した文字列の情報を利用して比較位置を移動できる点にあります。
単純照合では、パターンを一文字だけずらし、同じ部分を再度比較することがあります。
KMP法では、一致済みの文字列に含まれる繰り返し構造を利用し、不要な比較を避けます。
テキスト側の位置を後ろへ戻さずに進められるため、長い文字列を扱うときに安定した性能を期待できます。
失敗関数と接頭辞の情報
KMP法では、検索前にパターンの構造を調べ、失敗関数と呼ばれる表を作成します。
失敗関数は、ある位置まで一致したあとに不一致となった場合、パターンのどこから比較を再開できるかを示す情報です。
その際に注目するのが、接頭辞と接尾辞です。
接頭辞は文字列の先頭から始まる部分、接尾辞は末尾で終わる部分を意味します。
両方に共通する文字列があれば、その重なりを利用して比較を省略できます。
パターンが「ababaca」の場合、「aba」は先頭側の接頭辞であり、途中にも同じ並びが現れます。
不一致が発生しても、すべてを最初から比べ直す必要はありません。
共通部分の長さに応じて比較位置を移し、探索を継続します。
前処理にはパターン長に応じた時間が必要ですが、検索そのものでは効率よく比較できます。
長いテキストでの利用価値
KMP法の計算量は、前処理と探索を合わせておおむねO n+m に収まります。
最悪の場合でも比較回数が大きく悪化しにくいことが、KMP法の大きな利点です。
繰り返しが多いテキストや、同じ文字が連続するデータでは、単純照合との差が表れやすくなります。
最悪ケースでも安定した探索時間を求める場面では、KMP法は有力な候補となるでしょう。
ただし、実装には失敗関数の理解が必要であり、短いデータでは前処理の負担が目立つ場合もあります。
パターンの特徴とデータ量を確認して、採用を判断することが大切です。
KMP法は、過去に一致した情報を捨てずに使うことで、文字列探索の重複作業を減らします。
安定性を重視する検索処理で特に役立つアルゴリズムです。
ボイヤームーア法の比較戦略
続いてはボイヤームーア法の比較戦略を確認していきます。
末尾から始める文字比較
ボイヤームーア法は、検索パターンの末尾側から文字を比較することが特徴です。
左から順に確認する多くの方法とは異なり、右端の文字から一致を調べます。
不一致が見つかったとき、テキスト内の文字やパターン内の位置を手がかりにして、大きく移動できる場合があります。
そのため、英数字を含む通常の文章では、比較回数を大幅に減らせることがあります。
一度に複数文字分を飛ばせる可能性が、ボイヤームーア法の魅力です。
悪文字規則と良接尾辞規則
ボイヤームーア法では、悪文字規則と良接尾辞規則という代表的な考え方が使われます。
悪文字規則は、不一致だったテキスト側の文字がパターン内のどこに現れるかを確認し、ずらす距離を決める方法です。
パターンに存在しない文字なら、大きく移動できる可能性があります。
良接尾辞規則は、すでに一致したパターン末尾の部分を活用し、次に比較すべき位置を判断する考え方です。
これらの規則を組み合わせることで、無駄な照合を減らします。
| 手法 | 比較の方向 | 主な特徴 | 適する状況 |
|---|---|---|---|
| 単純照合 | 先頭から | 実装が簡単 | 短いテキストや学習用途 |
| KMP法 | 先頭から | 一致情報を再利用 | 最悪ケースの安定性が必要な処理 |
| ボイヤームーア法 | 末尾から | 大きく移動できる場合がある | 長い自然言語テキストの検索 |
実装時に知っておきたい注意点
ボイヤームーア法は高速なことが多い反面、前処理の設計がやや複雑です。
文字コードの扱い、日本語文字列、Unicodeの正規化なども、実装品質へ影響します。
日本語では一文字が複数バイトで表現されることがあるため、バイト単位と文字単位を混同しない配慮が必要です。
また、パターンが非常に短い場合や、文字の種類が少ないデータでは、大きな移動の利点を得にくいこともあります。
高速なアルゴリズムでも、入力データの性質によって実測値は変わるため、性能テストが欠かせません。
文字列探索手法の選び方
続いては文字列探索手法の選び方を確認していきます。
データ量と検索頻度
文字列探索の方法を選ぶ際は、テキストの長さと検索回数を最初に確認します。
短いデータを一度だけ検索するなら、単純照合でも十分に実用的な場合があります。
大量のログを定期的に確認する処理や、長文データを何度も検索する仕組みでは、効率的なアルゴリズムが有効です。
検索パターンが固定されていて、対象テキストだけが変わる場合には、前処理を再利用できる手法も検討できます。
反対に検索語が頻繁に変わるなら、前処理のコストも含めて比較するとよいでしょう。
一致条件と表記ゆれ
実際の検索機能では、単なる完全一致だけでは利用者の期待に応えられないことがあります。
大文字と小文字を区別しない検索、全角と半角を統一する検索、ひらがなとカタカナを近い表記として扱う検索などが必要になるためです。
正規表現を組み合わせると、電話番号、郵便番号、メールアドレスのような規則的なパターンも探せます。
ただし、正規表現は柔軟な一方で、複雑な条件では処理負荷や保守の難しさが増えることもあります。
検索精度はアルゴリズムだけでなく、一致条件の設計で決まる部分が大きいと考えましょう。
ライブラリと性能検証
多くのプログラミング言語には、文字列検索のための標準関数やライブラリが用意されています。
独自にアルゴリズムを実装する前に、利用中の言語が提供する検索機能を確認することも重要です。
標準機能では内部で最適化された探索手法が使われている場合があり、保守性にも優れます。
独自実装が必要な場合は、想定データに近いテストケースで、処理時間とメモリ使用量を測定します。
理論上の計算量だけで決めず、実際の文字種、パターン長、検索頻度を踏まえて評価する姿勢が求められます。
探索手法の選定では、最速とされる方法を固定的に選ぶのではなく、データと運用条件に合う方法を選びます。
実測による性能検証は、安定したシステム設計につながります。
パターンマッチング法のまとめ
パターンマッチング法は、テキストやデータの中から特定の文字列、規則、特徴を見つけるための基本技術です。
単純照合は仕組みがわかりやすく、小規模な検索に適しています。
KMP法は一致済みの情報を利用し、最悪ケースでも比較回数を抑えやすい点が特徴です。
ボイヤームーア法は末尾側から比較を始め、不一致時に大きく移動できるため、長い文章の検索で効果を発揮することがあります。
データ量、パターンの長さ、検索頻度、一致条件を整理すれば、適切な文字列探索手法を選びやすくなります。
仕組みと特性を理解し、実際の利用環境で検証することが、検索機能の性能と使いやすさを高める近道でしょう。