計算量とは?意味や求め方をわかりやすく解説!(アルゴリズム:時間計算量:空間計算量など)
プログラムの処理速度や必要なメモリ容量を考える際に、欠かせない考え方が計算量です。
同じ結果を出すプログラムでも、データ量が増えたときの効率には大きな差が出ます。
計算量を理解すると、処理が遅くなる原因を見つけやすくなり、より適したアルゴリズムを選べるようになります。
この記事では、時間計算量と空間計算量の意味、オーダー記法の見方、具体的な求め方までを、初学者にもわかりやすく整理します。
計算量の意味と考え方
それではまず、計算量の基本的な意味と、学ぶべき理由について解説していきます。
計算量が表す処理の増え方
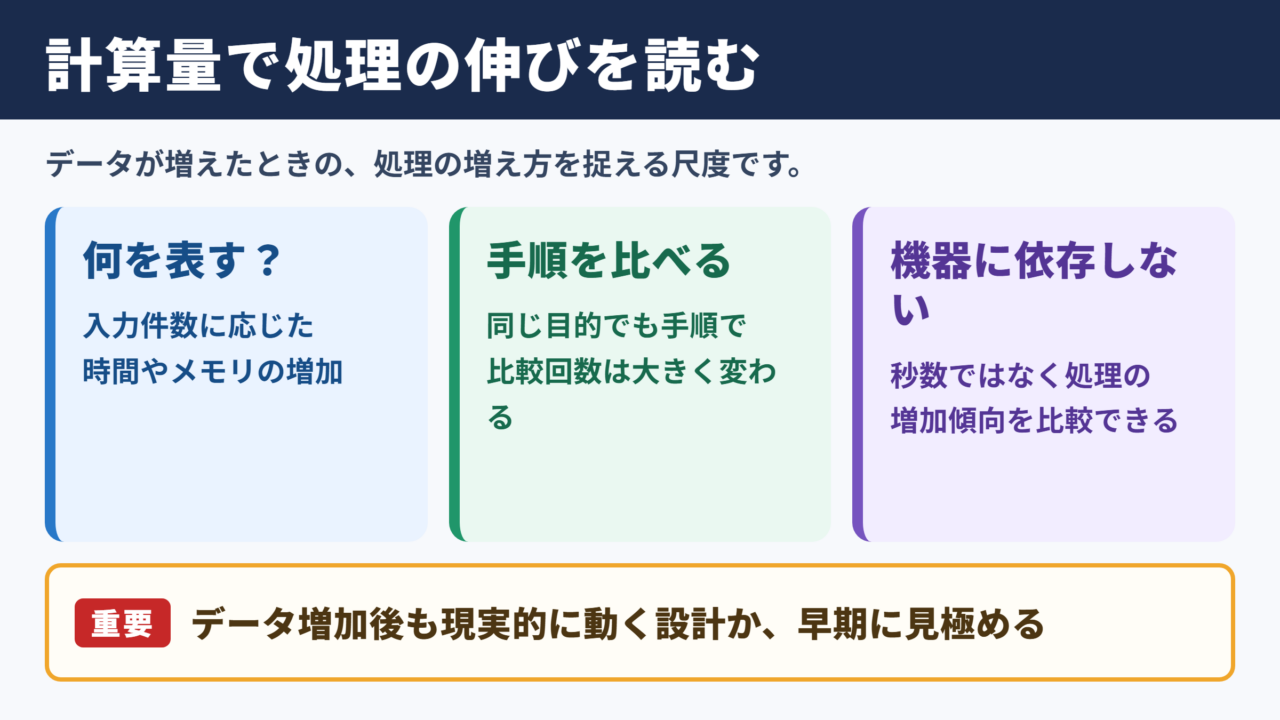
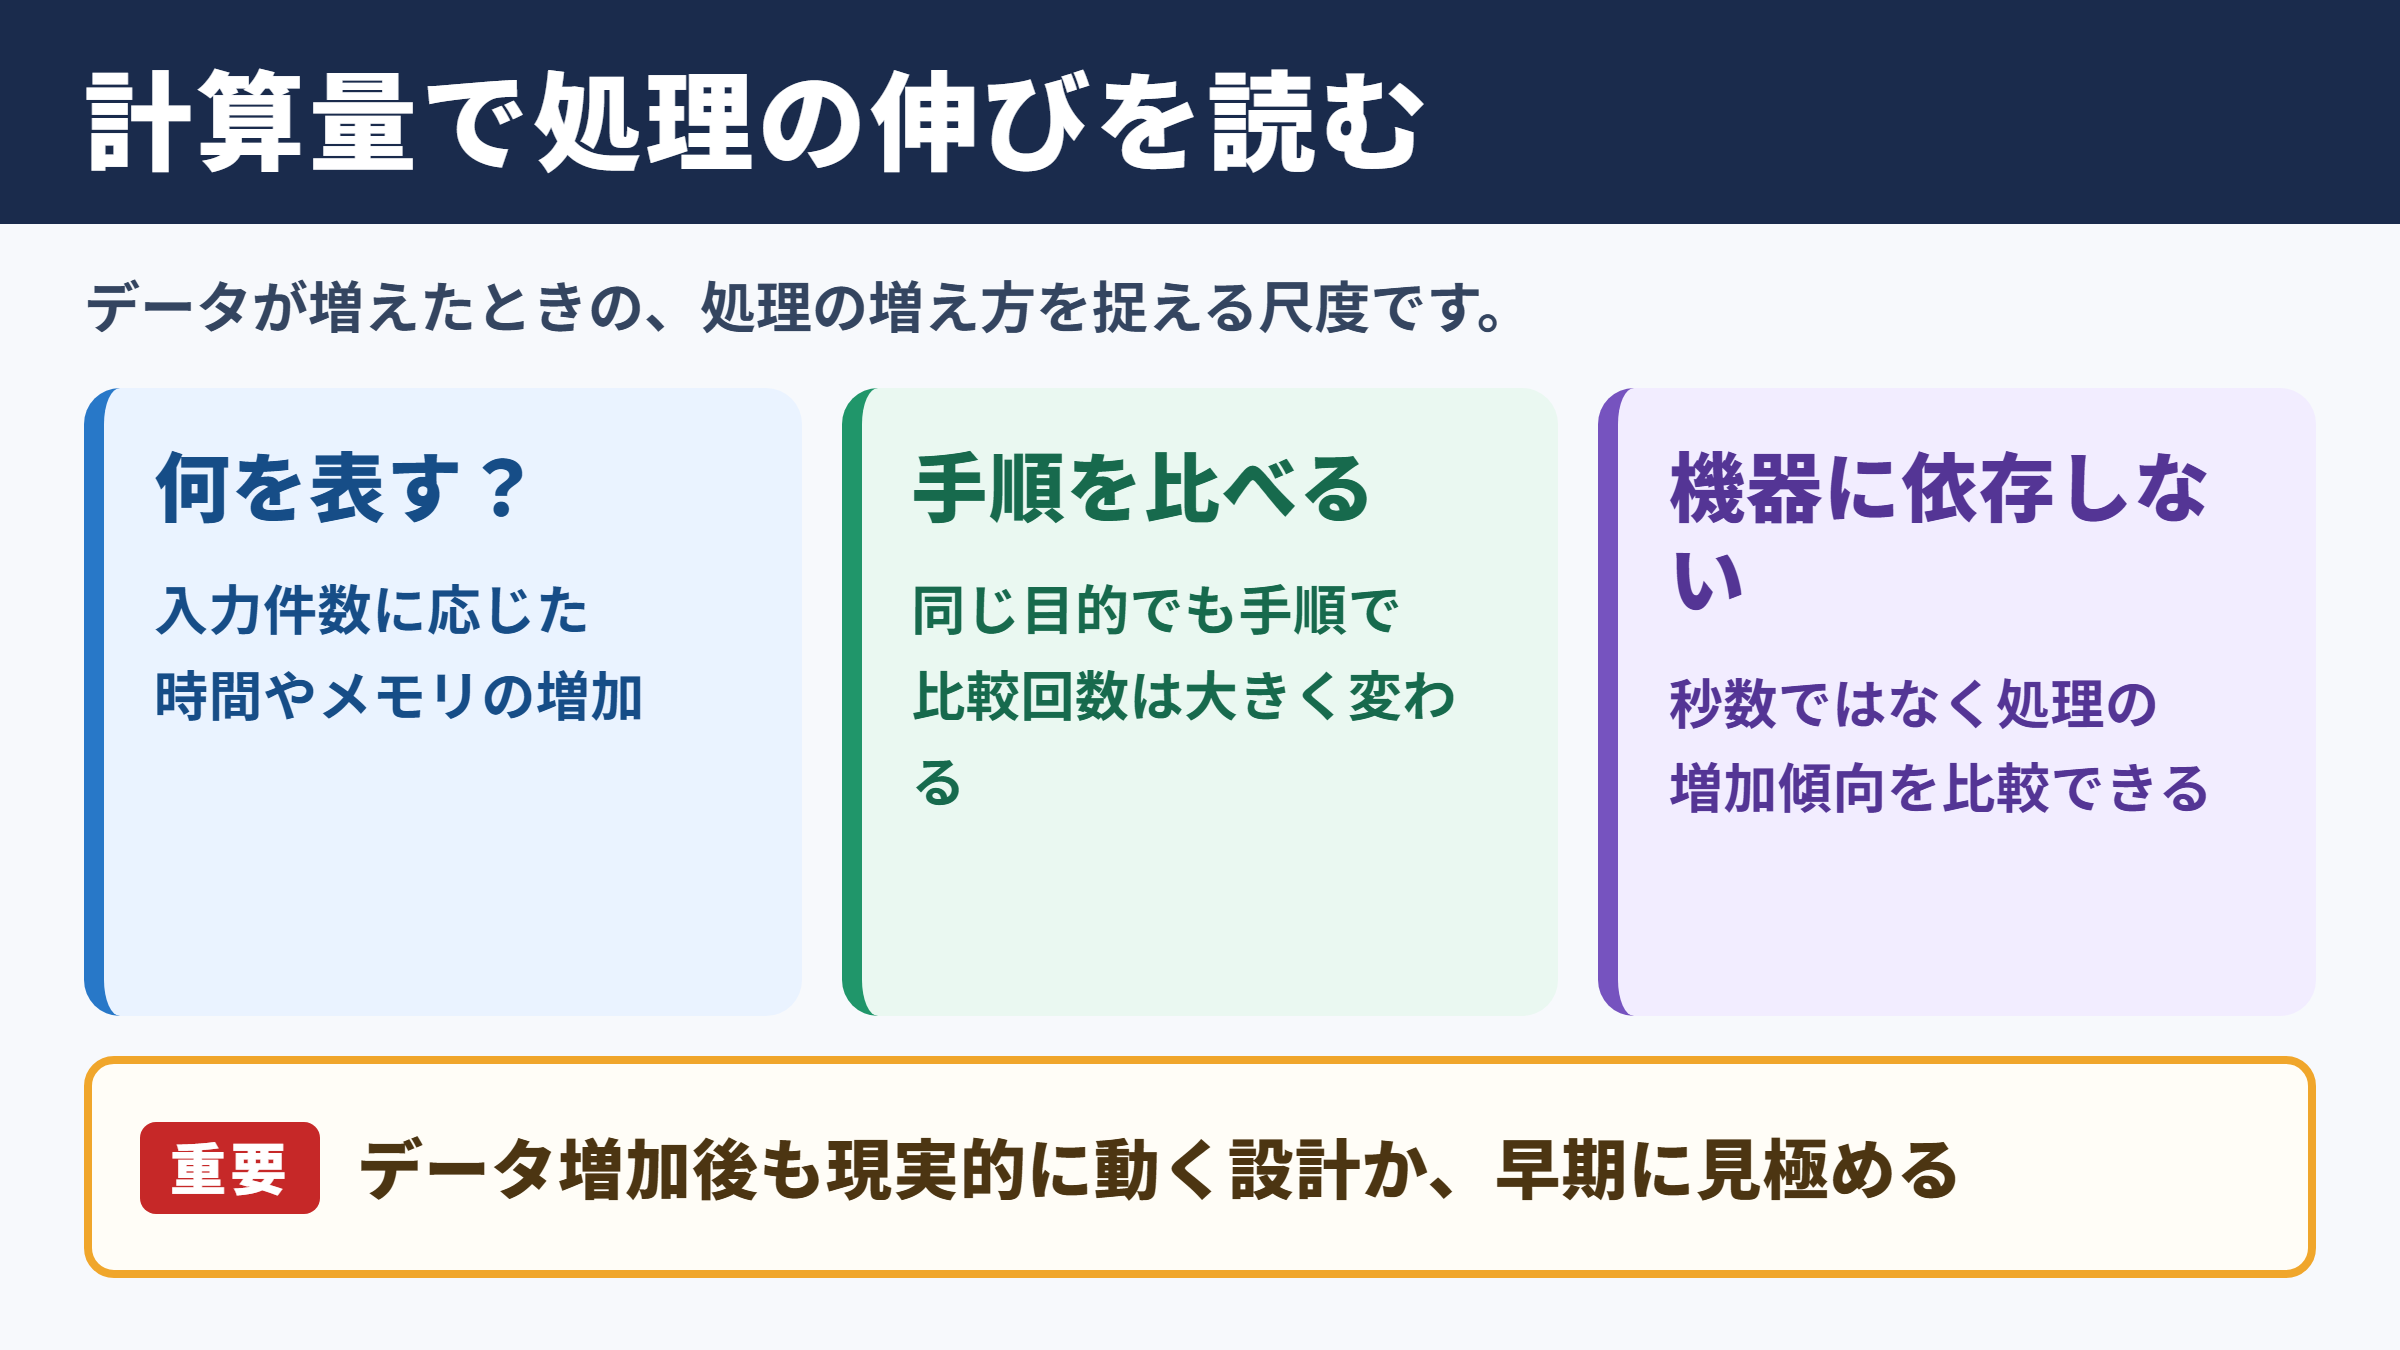
計算量とは、入力されるデータの件数が増えたときに、プログラムの実行時間や使用メモリがどの程度増えるかを表す目安です。
単に処理時間を秒数で測るのではなく、データ数をnとした場合に、処理回数がどのような規模で変化するかを確認します。
例えば、10件のデータで問題なく動く処理でも、10万件になった途端に待ち時間が長くなることがあります。
この違いを事前に予測するための共通言語が、計算量とオーダー記法です。
パソコンの性能や利用する言語が異なっても、処理の増加傾向は比較できます。
アルゴリズムとの関係
アルゴリズムは、目的の結果を得るための手順です。
検索、並べ替え、重複確認、最短経路の探索などでは、同じ目的に対して複数の手順を選べる場合があります。
そのとき、データ量が多くなっても効率を保ちやすい手順を判断する材料が計算量です。
たとえば、一覧から目的の値を先頭から順に探す方法と、整列済みの一覧を半分ずつ絞り込む方法では、必要な比較回数が大きく変わります。
計算量はプログラムの正しさではなく、効率の良さを評価する尺度と考えると理解しやすいでしょう。
実行時間だけでは測れない理由
実際に処理時間を計測することも重要ですが、その数値だけでアルゴリズムの優劣を決めることはできません。
CPUの性能、メモリ容量、通信環境、プログラミング言語、実行中の別アプリケーションなど、多くの条件が測定値に影響するためです。
一方で計算量は、特定の機器に依存せず、入力規模に対する処理の伸び方を捉えます。
計算量を見る目的は、今の処理が何秒かを知ることだけではありません。
データが10倍、100倍になった場合にも現実的に動作する設計かどうかを、早い段階で見極めることにあります。
時間計算量の種類と比較
続いては、代表的な時間計算量の種類と、それぞれの違いを確認していきます。
定数時間と対数時間
時間計算量がO(1)の処理は、入力データの量が増えても、基本的な処理回数がほとんど変わりません。
配列の決まった位置にある要素を取得する処理や、変数への代入が代表例です。
O(log n)は対数時間と呼ばれ、データを半分ずつに絞り込む二分探索などで現れます。
データ数が増えても処理回数の増加は緩やかであり、大量データの検索で特に有利な計算量です。
二分探索では、1024件の候補を探す場合でも、比較回数はおおむね10回程度に抑えられます。
対象データが整列されていることが前提ですが、線形探索と比べて効率の差が出やすい場面です。
線形時間と線形対数時間
O(n)は線形時間です。
データを先頭から最後まで1回ずつ確認する処理では、データ数にほぼ比例して処理回数が増えます。
配列の合計値を求める、条件に合う要素を抽出する、単純な検索を行うといった処理が該当します。
O(n log n)は、効率のよいソートアルゴリズムでよく見られる計算量です。
マージソートやヒープソートなどが代表的で、並べ替えが必要な多くの実務処理で現実的な選択肢になります。
二乗時間と指数時間
O(n²)は二乗時間です。
二重ループで全ての組み合わせを比較する処理などで発生し、データ量が増えるほど負荷が急激に大きくなります。
さらにO(2ⁿ)やO(n!)のような指数時間、階乗時間は、候補の全探索で見られる計算量です。
小規模な入力なら利用できても、件数が増えると実行時間が現実的でなくなる可能性があります。
| オーダー | 呼び方 | 代表的な処理 | データ増加時の特徴 |
|---|---|---|---|
| O(1) | 定数時間 | 配列の添字アクセス | ほぼ変化しない |
| O(log n) | 対数時間 | 二分探索 | 非常に緩やかに増える |
| O(n) | 線形時間 | 全件走査 | 件数に比例して増える |
| O(n log n) | 線形対数時間 | 高速な並べ替え | 実務で扱いやすい |
| O(n²) | 二乗時間 | 全組み合わせ比較 | 件数が多いと重くなりやすい |
| O(2ⁿ) | 指数時間 | 部分集合の全探索 | 急激に増加する |
空間計算量の意味と確認方法
続いては、プログラムが必要とするメモリに関係する空間計算量を確認していきます。
空間計算量が示すメモリ使用量
空間計算量とは、アルゴリズムの実行中に必要となるメモリ使用量の増え方を表す指標です。
配列、リスト、ハッシュテーブル、再帰呼び出しの情報など、処理のために確保する領域が対象になります。
入力データそのものが占める領域を除いて考える場合もあれば、含めて評価する場合もあります。
仕様書や技術記事では前提が異なることがあるため、何を空間計算量に含めているかを確認することが大切です。
追加メモリが少ない処理
配列の要素を順番に読み取り、合計だけを変数に保持する処理は、追加で必要なメモリがほぼ一定です。
このような処理は、入力数が増えても補助変数の数が変わらないため、空間計算量はO(1)と考えられます。
メモリに制約がある組み込み機器や、大量データを連続処理するシステムでは重要な特徴です。
ただし、メモリを節約しすぎると処理時間が増えることもあり、時間計算量とのバランスを検討する必要があります。
配列と再帰で増えるメモリ
入力と同じ件数の配列を新たに作成する場合、追加メモリはデータ数に比例するためO(n)になります。
ソート結果を別の配列に保存する処理や、検索結果を全件保持する処理が例として挙げられます。
再帰処理では、関数呼び出しごとにスタック領域が使われます。
再帰の深さがnに比例するなら、スタックによる空間計算量もO(n)になる可能性があります。
高速な処理が常に最適とは限りません。
時間を短縮するために大きなキャッシュや配列を使う設計では、メモリ不足やガベージコレクションによる遅延も考慮する必要があります。
オーダー記法と計算量の求め方
続いては、Big O記法の基本ルールと、ソースコードから計算量を求める手順を確認していきます。
Big O記法の基本
Big O記法は、処理回数の増加傾向をO( )で表す方法です。
厳密な実行回数ではなく、入力規模が十分に大きくなったときに支配的となる項だけを残します。
たとえば、3n+20回の処理であれば、nが大きくなるほど影響が大きいのはnの部分です。
3n+20はO(n)と表します。
定数係数の3と定数項の20は、増加の種類を比較する目的では省略するのが基本です。
このルールにより、異なる実装同士でも大まかな効率を比較しやすくなります。
ループ回数から考える手順
計算量を求めるときは、まずデータ数nに対して、主要な処理が何回実行されるかを数えます。
単一のループがn回繰り返されるなら、基本的にはO(n)です。
ループの中に別のn回ループがあり、各要素について全要素を確認する場合は、n×nとなるためO(n²)になります。
一方、複数の処理が順番に実行されるだけなら、計算量は足し算で考えます。
最終的には大きい項だけを残すため、O(n)とO(n²)が続く処理全体はO(n²)です。
入れ子のループは掛け算、順番の処理は足し算という考え方を押さえると、基本的な判定がしやすくなります。
条件分岐と最悪計算量
if文やswitch文がある場合は、どの分岐で最も多くの処理が行われるかを確認します。
一般にBig O記法では、最悪の場合に必要となる処理回数を基準にすることが多い傾向です。
たとえば線形探索では、探している値が最後にある場合や存在しない場合、全件を確認する必要があります。
そのため最悪計算量はO(n)です。
ただし、平均的な応答速度が重要なサービスでは、平均計算量や確率的な偏りも確認するとよいでしょう。
代表的なアルゴリズムの計算量
続いては、検索や並べ替えなどで使われる代表的なアルゴリズムの計算量を確認していきます。
線形探索と二分探索
線形探索は、先頭から順に対象を確認するシンプルな検索方法です。
整列されていないデータにも使える反面、最悪の場合は全件を調べるため時間計算量はO(n)になります。
二分探索は、中央の値と比較しながら探索範囲を半分に絞ります。
時間計算量はO(log n)ですが、対象があらかじめソートされている必要があります。
頻繁に検索するデータなら、並べ替えやインデックス作成のコストも含めて判断することが重要です。
バブルソートと高速なソート
バブルソートは、隣り合う要素を比較して入れ替える処理を繰り返す並べ替えです。
考え方はわかりやすいものの、一般的な最悪計算量はO(n²)であり、大量データには向きにくい方法です。
マージソートはデータを分割し、整列しながら統合するため、時間計算量はO(n log n)になります。
クイックソートも平均的にはO(n log n)ですが、基準値の選び方によっては最悪O(n²)になる場合があります。
| アルゴリズム | 主な用途 | 時間計算量の目安 | 注意点 |
|---|---|---|---|
| 線形探索 | 未整列データの検索 | O(n) | 件数が多いと探索が長い |
| 二分探索 | 整列済みデータの検索 | O(log n) | 事前の整列が必要 |
| バブルソート | 学習用の並べ替え | O(n²) | 大規模データには不向き |
| マージソート | 安定した並べ替え | O(n log n) | 追加メモリを使う |
| ハッシュ探索 | キーによる検索 | 平均O(1) | 衝突やメモリ使用量に注意 |
ハッシュテーブルとデータ構造
データ構造の選択も計算量に大きく影響します。
配列では添字による取得がO(1)でも、途中への挿入や削除では要素の移動が必要になり、O(n)となる場合があります。
ハッシュテーブルは、キーを使った検索や追加を平均O(1)で行えることが魅力です。
ただし、ハッシュ衝突が多い状況や、順序を保つ必要がある場面では別の構造が適することもあります。
重複の有無を調べる処理では、全要素を二重ループで比較するとO(n²)になりがちです。
確認済みの値をハッシュセットに保存すれば、平均的には全体をO(n)程度で処理できる場合があります。
アルゴリズムだけでなく、配列、連結リスト、木、ハッシュ表といったデータ構造も合わせて選ぶことが、性能改善の近道です。
計算量を設計と改善に生かす視点
続いては、計算量を実際の開発や性能改善に生かすための視点を確認していきます。
ボトルネックの見つけ方
処理が遅いと感じたときは、すべてのコードを細かく最適化する前に、時間を多く使っている箇所を特定します。
ログ、プロファイラ、実行時間の計測などを利用し、繰り返し呼び出される処理や、巨大な配列を走査する処理を確認します。
特に、ループの内部でデータベース検索や外部通信を行う設計は、計算量だけでは表しきれない遅延を生みやすい箇所です。
回数の多い処理と、1回あたりが重い処理の両方を見ると、改善の優先順位を決めやすくなります。
データ規模に応じた判断
数十件程度のデータしか扱わない処理であれば、O(n²)であっても十分に速く、読みやすい実装を優先したほうがよい場合があります。
反対に、利用者の増加や履歴データの蓄積によって、数十万件以上を扱う見込みがあるなら、早い段階でO(n log n)やO(n)の設計を検討したいところです。
将来の規模を予想できない場合は、データ量の上限、応答時間の目標、メモリ制限を要件として明文化すると判断しやすくなります。
計算量の改善は、複雑なテクニックを使うことだけを意味しません。
不要な全件走査を減らす、検索用のキーを設ける、集計結果を再利用するといった設計上の工夫も有効です。
可読性と保守性の両立
計算量を小さくするために、理解しにくい実装へ変えると、将来の修正で不具合が入り込むことがあります。
性能が求められる箇所では、選んだアルゴリズムの理由や想定データ量をコメントや設計書に残すとよいでしょう。
また、最適化の前後でテストを行い、処理結果が変わっていないことを確認する姿勢も欠かせません。
読みやすさ、正確さ、速度、メモリ使用量を総合的に見て、用途に合う実装を選ぶことが大切です。
まとめ
計算量は、データ量が増えたときに、処理時間やメモリ使用量がどのように変化するかを示す考え方です。
時間計算量ではO(1)、O(log n)、O(n)、O(n log n)、O(n²)などを用い、処理の増え方を比較します。
空間計算量も確認すれば、速度だけでなく、必要なメモリを含めた設計判断ができるでしょう。
まずは単一ループがO(n)、二重ループがO(n²)になりやすい点を押さえ、Big O記法の見方に慣れることがおすすめです。
検索、ソート、重複判定などで使用するアルゴリズムとデータ構造を見直すことで、将来的なデータ増加にも耐えやすいプログラムを作りやすくなります。