デッドロックの意味をわかりやすく!ビジネスでの発生原因・回避方法・データベースとの関係も(処理の行き詰まり・相互待機・システム障害など)
デッドロックは、システム開発やデータベースの運用だけでなく、社内の業務フローでも起こり得る「お互いが相手の作業を待ち続け、処理が進まなくなる状態」を指します。
用語だけを見ると専門的ですが、複数の担当者や複数の処理が限られた資源を取り合う場面を思い浮かべると、仕組みを理解しやすくなります。
この記事では、デッドロックの基本的な意味、ビジネス上での発生原因、データベースとの関係、実務で役立つ回避方法までをわかりやすく解説します。
デッドロックの意味と処理停止の仕組み
それではまずデッドロックの意味と、処理が止まる仕組みについて解説していきます。
デッドロックが示す相互待機の状態
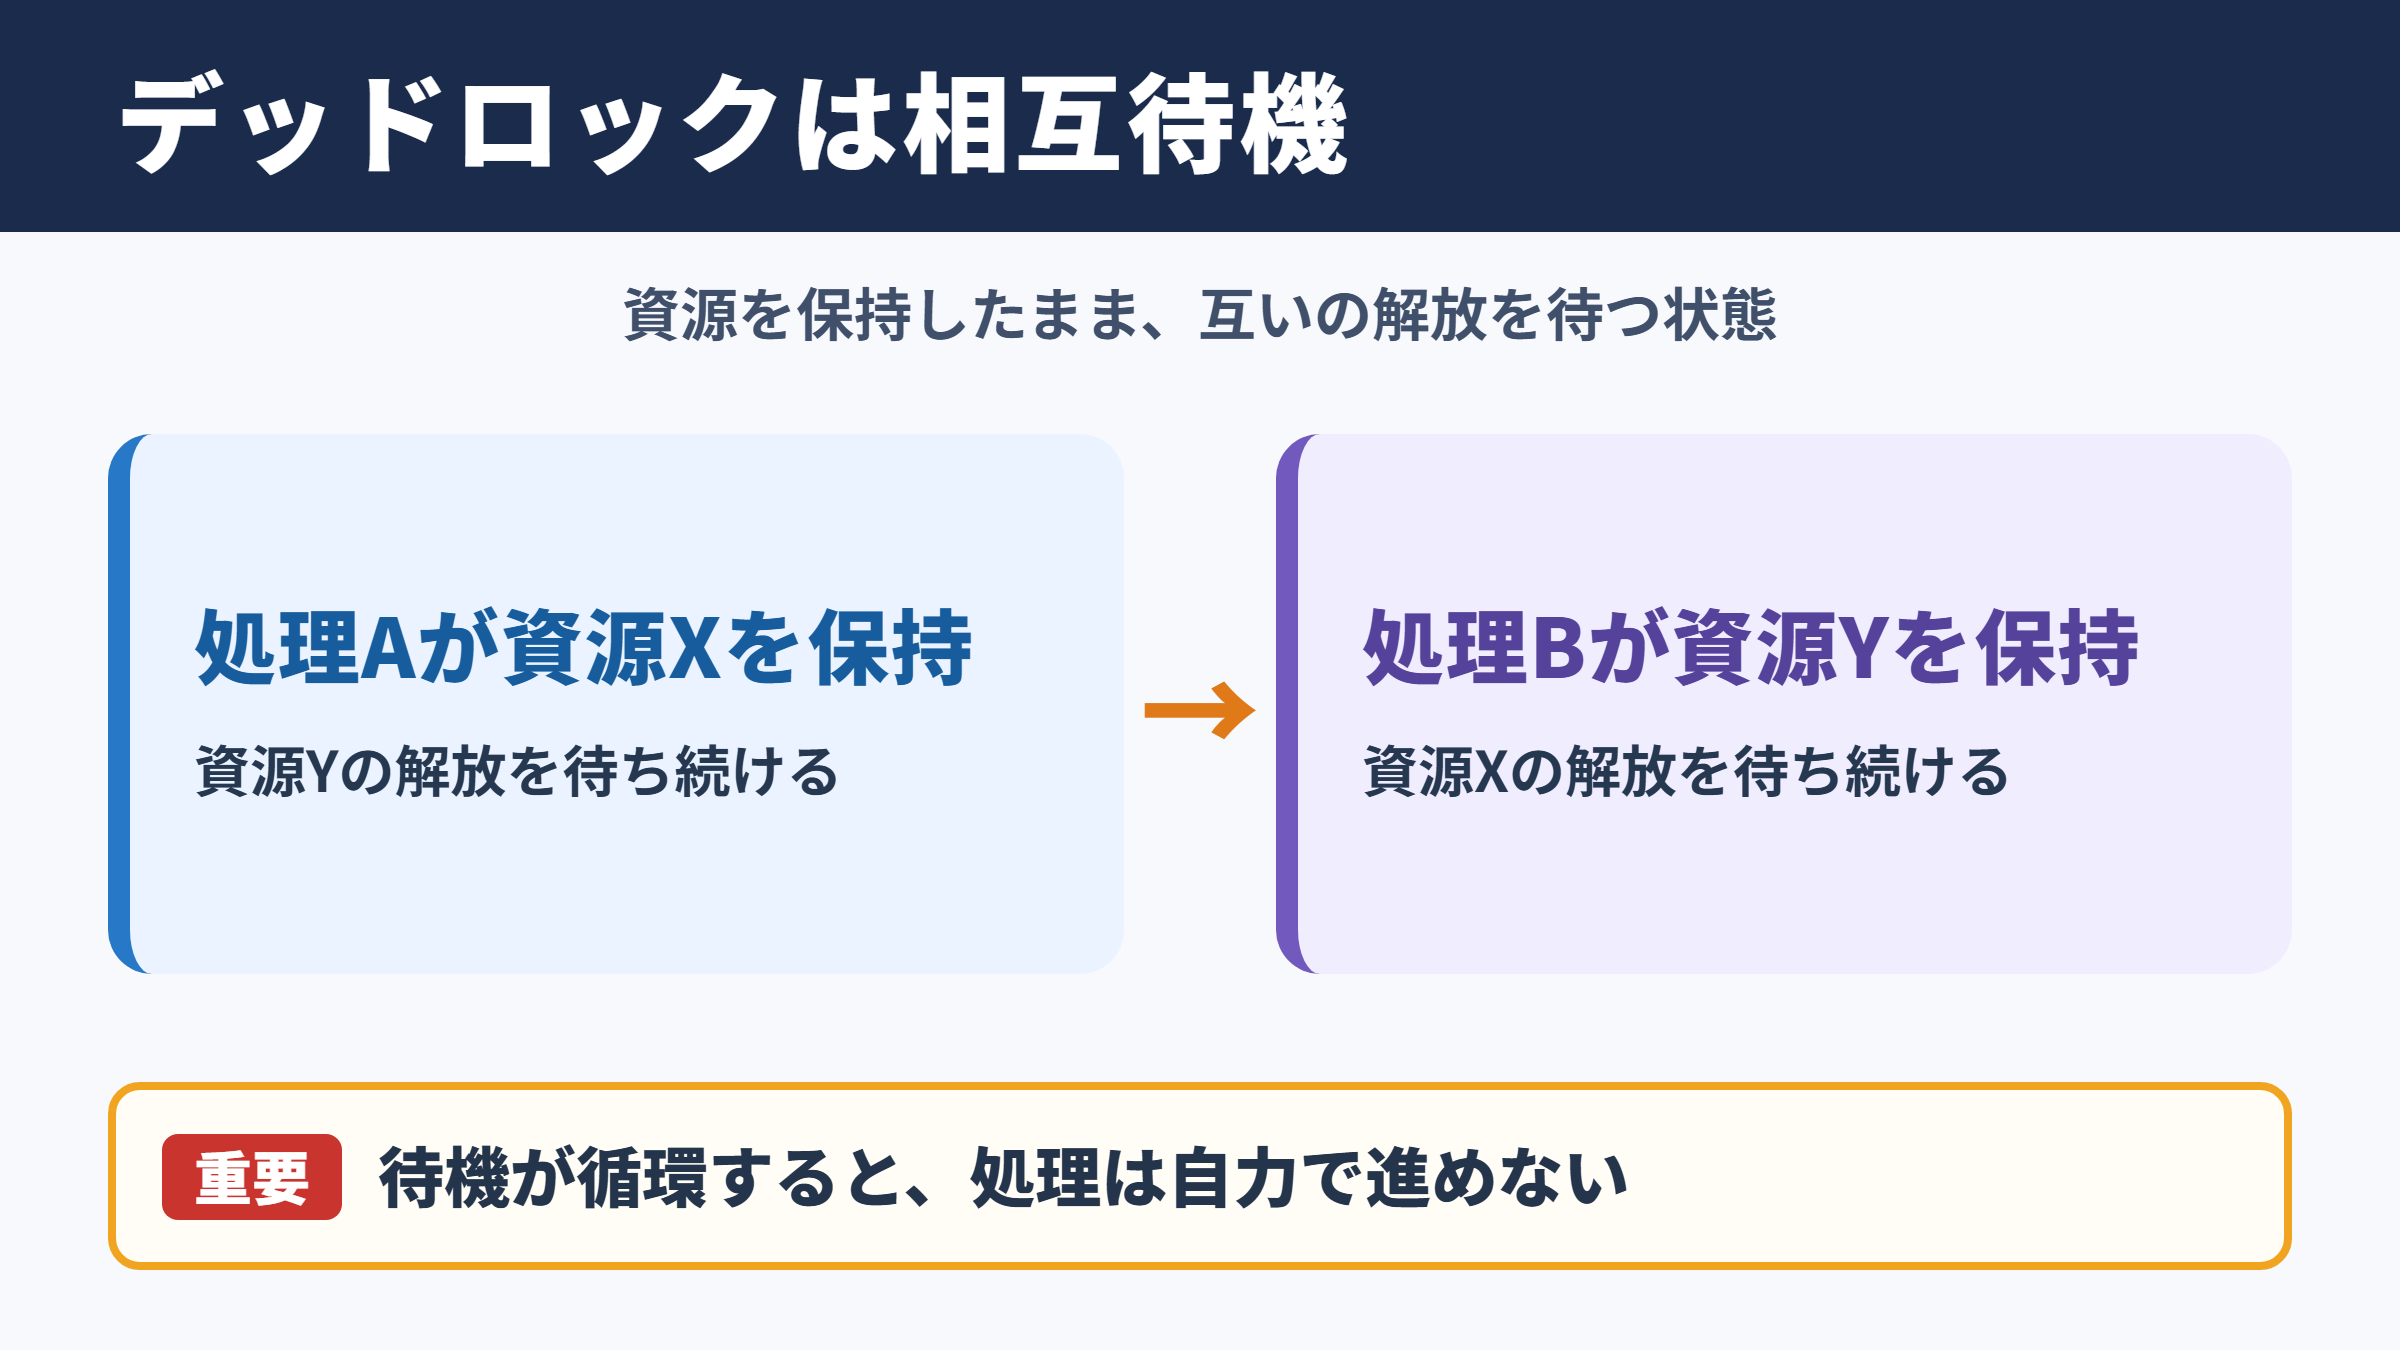
デッドロックとは、複数の処理や担当者がそれぞれ何かを保持したまま、相手が持つ資源の解放を待ち続ける状態です。
英語のdeadlockには、行き詰まり、膠着状態、打開できない対立といった意味があります。
システムの世界では、処理Aが資源Xを確保しながら資源Yを待ち、処理Bが資源Yを確保しながら資源Xを待つような状況が代表例です。
両者とも自分の持つ資源を手放さないため、後から必要になった資源を取得できません。
この状態が続くと、処理は前へ進めず、利用者から見ると画面が固まった、登録が終わらない、データ更新に失敗したといった問題として現れます。
デッドロックの本質は、単に遅いことではなく、待機の関係が循環して自力で解消しにくいことです。
一時的な混雑では待ち時間の後に処理が完了する場合がありますが、デッドロックでは待つ相手も同じように待っているため、通常の待機とは性質が異なります。
ロックと資源の関係
デッドロックを理解する鍵になるのが、ロックという仕組みです。
ロックは、複数の人やプログラムが同じデータを同時に変更して、内容が壊れたり矛盾したりすることを防ぐための制御です。
たとえば、在庫数を更新する処理中に別の処理が同じ商品を更新すると、結果が不正確になるおそれがあります。
そこで先に処理を始めた側が対象データにロックをかけ、処理が終わるまで他の処理を待たせます。
この安全装置自体は重要ですが、複数のデータや機能にまたがってロックを取得すると、取得する順番の違いが問題につながります。
処理Aが顧客データをロックした後で注文データを待つ場面を考えます。
同時に処理Bが注文データをロックした後で顧客データを待つと、両方の処理が止まります。
このように、保持している資源と待っている資源が輪のようにつながる関係がデッドロックです。
ロック対象はデータベースの行だけではありません。
ファイル、ネットワーク接続、プリンター、共有フォルダ、承認権限、担当者の確認待ちなども、広い意味では資源として扱えます。
遅延や障害との違い
システムが遅い場合、必ずしもデッドロックが発生しているとは限りません。
アクセス集中、サーバーの性能不足、複雑な検索処理、通信遅延などでも応答時間は長くなります。
一方でデッドロックは、複数の処理の依存関係が原因になり、特定の操作が完了しない状態です。
多くのデータベース管理システムはデッドロックを検出すると、関係する処理の一部を強制的に中止します。
これにより全体が永久に停止する事態を避けますが、中止された処理はエラーとなり、利用者には再実行が必要になることがあります。
エラーが一度出ただけでも偶然として見過ごさず、発生時刻、操作内容、対象データを記録することが重要です。
| 状態 | 主な原因 | 処理の見え方 | 対応の考え方 |
|---|---|---|---|
| 通常の待機 | 先行処理の実行中 | 時間がたてば完了する | 待機時間を確認する |
| 性能低下 | 負荷集中や検索の重さ | 全体的に遅い | 性能測定と負荷対策 |
| デッドロック | 相互に資源を待つ | 一部処理が中止される | ロック順序を見直す |
| システム障害 | 停止や通信断 | 広範囲で利用できない | 復旧手順を実施する |
ビジネス業務で起こるデッドロックの場面
続いては、ビジネス業務で起こるデッドロックの場面を確認していきます。
承認フローで生じる相互待機
デッドロックはIT用語として使われることが多い一方、仕事の進め方にも似た構造が生まれます。
たとえば、営業部が見積書の提出にあたり経理部の原価確認を待ち、経理部は営業部からの案件条件の確定を待っている場合です。
どちらの部署にも作業の理由はありますが、相手が先に動かなければ自分の作業を終えられません。
このような状態では、担当者が多忙であるほど、問題が見えにくくなります。
チャットやメールで確認依頼だけが増え、責任者も判断材料を待っていると、案件全体が停滞するでしょう。
業務上のデッドロックは、担当範囲が曖昧で、誰が最終判断を下すか決まっていないときに起こりやすい傾向があります。
部門間の調整で発生する行き詰まり
新商品の発売、システム導入、契約締結など、複数部門が関わるプロジェクトでは依存関係が複雑になります。
法務部門は仕様確定後でなければ契約内容を確認できず、開発部門は契約条件が固まらなければ仕様を確定できないという状況もあるでしょう。
こうした相互待機は、各部門が慎重に仕事をしているからこそ発生します。
そのため、個人の能力や意欲の問題として扱うのではなく、工程設計の問題として整理する視点が必要です。
依頼の入力項目、確認期限、差し戻し条件、代替承認者を事前に決めると、停滞を減らせます。
業務の行き詰まりを防ぐには、各工程の開始条件と完了条件を明文化することが効果的です。
誰かの判断待ちになった場合に、何日後に上長へエスカレーションするかも決めておくと、相互待機が長期化しにくくなります。
会議や意思決定に見られる膠着状態
会議でも、デッドロックに近い状態は起こります。
企画部は予算承認がなければ案を確定できず、経営層は具体的な案がなければ予算を承認できないという循環です。
ここで必要なのは、完璧な情報がそろうまで待つことではありません。
仮説に基づく小規模な検証、条件付きの承認、決定期限の設定などを使い、次の行動を生み出すことが大切です。
担当者同士が善意で待ち続けるだけでは、優先順位の高い案件でも前進しません。
進行役が論点を分け、決める人と調べる人を明確にすると、膠着状態を解きやすくなります。
| 業務の場面 | 待機している内容 | 起こりやすい問題 | 予防策 |
|---|---|---|---|
| 見積作成 | 原価情報と販売条件 | 提出期限の超過 | 確認順序と期限の設定 |
| 契約審査 | 仕様と法務確認 | 開始日の遅れ | 暫定仕様の共有 |
| 経費承認 | 証憑と上長判断 | 支払い遅延 | 代理承認者の指定 |
| 商品開発 | 予算と企画案 | 意思決定の停止 | 検証予算の枠を設ける |
データベースでのデッドロック発生原因
続いては、データベースでのデッドロック発生原因を確認していきます。
更新順序の不一致
データベースでデッドロックが起こる代表的な原因は、複数の処理でデータを更新する順序がそろっていないことです。
ある機能が顧客テーブルを更新してから注文テーブルを更新し、別の機能が注文テーブルを更新してから顧客テーブルを更新すると、同時実行時に衝突する可能性があります。
処理の内容が正しくても、同じ資源を取得する順番が異なるだけで相互待機は起こります。
関連するデータを扱う処理では、ロックを取得する順序をシステム全体で統一することが基本です。
開発者ごと、画面ごと、バッチ処理ごとに実装方針が異なると、後から原因を追う難しさも増します。
長時間トランザクションの影響
トランザクションとは、複数のデータ処理をひとまとまりとして扱う単位です。
注文登録では、注文データの登録、在庫の減算、決済情報の更新などをまとめて成功させる必要があります。
途中で失敗した場合は、すでに行った変更を元に戻し、データの整合性を保ちます。
ただし、トランザクションの中で外部サービスへの通信、利用者の入力待ち、重い集計処理などを行うと、ロックを持つ時間が長くなります。
ロック保持時間が長いほど、他の処理が待つ時間も延び、競合とデッドロックの可能性が高まります。
安全な設計では、データ更新に必要な処理だけを短いトランザクションにまとめます。
メール送信、帳票作成、外部APIへの通知などは、更新完了後に別の処理として実行する方法を検討します。
これによりロック時間を短縮し、同時実行時の影響を抑えられます。
インデックス不足と検索範囲の拡大
インデックスが適切でない場合、データベースは目的の行を探すために多くのデータを確認することがあります。
更新対象を絞り込めないと、想定以上に広い範囲へロックの影響が及ぶ場合もあります。
その結果、本来は別々の顧客や注文を扱う処理まで待機し、競合が増えることにつながります。
ただし、インデックスを多く作ればよいわけではありません。
更新時にはインデックスも更新する必要があるため、検索条件、更新頻度、データ量を踏まえた設計が求められます。
デッドロック対策はプログラムの修正だけでなく、SQL文、実行計画、インデックス設計を一体で見直すことが重要です。
デッドロックの検知とシステム障害への対応
続いては、デッドロックの検知とシステム障害への対応を確認していきます。
ログから確認するべき情報
デッドロックが起きたときは、エラーメッセージだけを確認して終わりにしないことが大切です。
発生日時、利用者の操作、実行されたSQL、対象テーブル、トランザクションID、処理時間、アプリケーションのバージョンなどを確認します。
本番環境では同じエラーが短時間に集中することもあるため、件数の増減を監視する仕組みが役立ちます。
特定の時間帯、特定の画面、特定のバッチと重なる場合は、競合する処理を絞り込みやすくなります。
個人情報や機密情報をログに残す場合には、マスキングやアクセス権限にも注意が必要でしょう。
自動中止と再試行の考え方
多くのデータベースは、デッドロックを検出した際に、関係する処理の一方を犠牲にして中止します。
中止された側をデッドロックの被害処理として扱い、ロックを解放することで、残りの処理を完了させる仕組みです。
このとき、アプリケーション側ではエラーを適切に受け取り、必要に応じて再試行する設計が必要になります。
ただし、何度も即座に再試行すると再び競合する可能性があります。
少し時間を空ける、試行回数に上限を設ける、利用者へ再操作を案内するといった配慮が欠かせません。
再試行は、同じ処理を繰り返しても安全な場合に限って実装します。
二重注文や二重請求につながる処理では、重複実行を防ぐ識別子や状態管理を用意する必要があります。
失敗時の処理を設計することも、デッドロック対策の一部です。
利用者への影響を小さくする運用
利用者にとっては、デッドロックという内部の原因よりも、保存できない、決済が完了しない、作業内容が消えたと感じることの方が大きな問題です。
そのため、エラー画面では難しい技術用語だけを表示せず、再試行の可否や問い合わせ時に必要な情報をわかりやすく示す工夫が求められます。
途中入力を一時保存できるようにする、処理番号を発行する、障害情報を迅速に共有することも有効です。
技術的な復旧だけでなく、利用者が次に何をすればよいか分かる設計が、信頼低下を防ぐポイントになります。
障害対応の手順書には、担当者、連絡先、判断基準、復旧後の確認項目を整理しておくと安心です。
デッドロックを回避する設計と業務改善
続いては、デッドロックを回避する設計と業務改善を確認していきます。
ロック取得順序の標準化
システム設計における最も基本的な回避方法は、ロックを取得する順序を統一することです。
複数のテーブルや複数のデータを更新するなら、どの機能でも同じ並びで取得するルールを定めます。
たとえば顧客、注文、在庫の順に更新すると決めたなら、例外的な画面やバッチ処理でも原則を守ります。
仕様書や設計書に更新対象と取得順序を記載し、コードレビューで確認する運用が効果的です。
処理単位では自然に見える実装でも、システム全体で順序がそろっていなければデッドロックの原因になります。
処理の分割と待機時間の制御
一度に大量のデータを更新する処理は、ロックの範囲と保持時間を大きくしがちです。
夜間バッチで何十万件ものデータを一括更新する場合は、一定件数ごとに処理を区切る方法が考えられます。
業務要件を確認したうえで、長い処理を小さな単位へ分割すると、他の処理が割り込める余地が生まれます。
また、ロック待機時間の設定を適切に調整し、異常に長い待機を検知することも重要です。
ただし、待機時間を短くしすぎると、通常の混雑でもエラーが増えるため、実際の負荷状況に合わせて判断します。
業務フローにおける責任分担の明確化
業務上のデッドロックを避けるには、誰が何を決めるのかを見える化します。
依頼する側、確認する側、承認する側、最終判断する側を分け、それぞれの期限を設定しましょう。
例外対応が起きた場合に、担当者同士で抱え込まず、決裁者へ引き上げるルートを用意することも大切です。
定例会議では、進んでいない案件だけを確認するのではなく、何を待っているのか、誰が次に動くのかを明確にします。
デッドロックの回避では、待ち合わせの関係を一方向にする考え方が役立ちます。
システムならロック取得順序、業務なら承認順序をそろえることで、相互に待つ輪を断ち切りやすくなります。
デッドロックの意味と回避方法のまとめ
ここまでの内容をまとめます。
デッドロックとは、複数の処理や担当者が互いに必要な資源や判断を待ち続け、作業が進まなくなる相互待機の状態です。
データベースではロック取得順序の不一致、長時間トランザクション、検索範囲の広さなどが主な原因になります。
ビジネスの現場では、承認者の不明確さ、部門間の依存関係、判断基準の不足が似た構造を生み出します。
対策の中心になるのは、順序の統一、処理時間の短縮、責任分担の明確化、ログに基づく継続的な改善です。
一時的なエラーを再実行だけで済ませるのではなく、どの処理がどの資源を待っていたのかを確認すると、再発防止につながります。
利用者への案内や復旧手順まで整えることで、システム障害の影響を小さくできるでしょう。
デッドロックは完全に起こらないようにするだけでなく、起きても検知し、影響を抑え、原因を改善できる運用を整えることが重要です。
技術と業務フローの両面から見直すことが、安定したシステム運用と円滑な仕事の進行につながります。