オブザーバビリティの意味をわかりやすく!ビジネスでの重要性・モニタリングとの違い・導入のポイントも(システム可観測性・ログ・トレース・メトリクスなど)
クラウドサービスやSaaSの利用が広がるなか、システム障害の原因を素早く見つけ、事業への影響を小さくする取り組みが重要になっています。
そこで注目される考え方が、システムの内部状態を外部から把握するオブザーバビリティです。
言葉だけを見ると難しく感じるかもしれませんが、ログ、メトリクス、トレースなどを結び付けて状況を読み解く仕組みと考えると理解しやすいでしょう。
本記事では意味やモニタリングとの違い、ビジネスで求められる理由、導入時の進め方をわかりやすく解説します。
オブザーバビリティの意味と役割
それではまず、オブザーバビリティの基本的な意味と役割について解説していきます。
システム可観測性という考え方
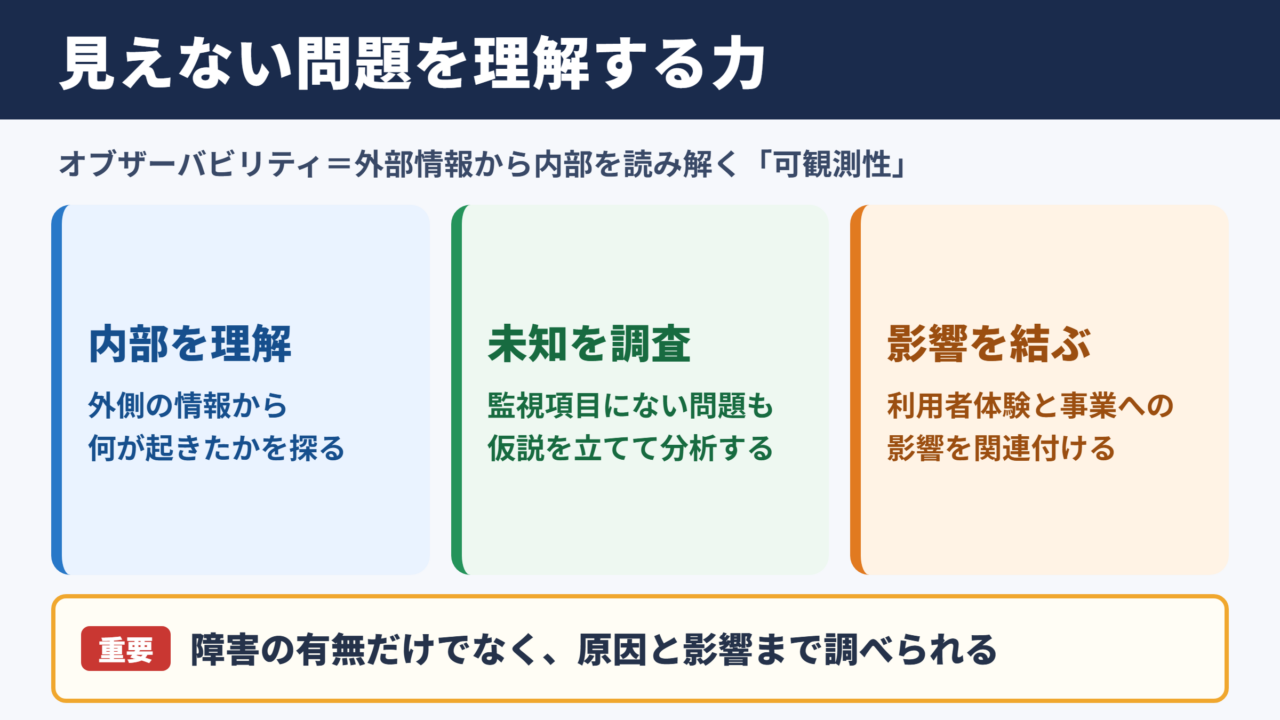
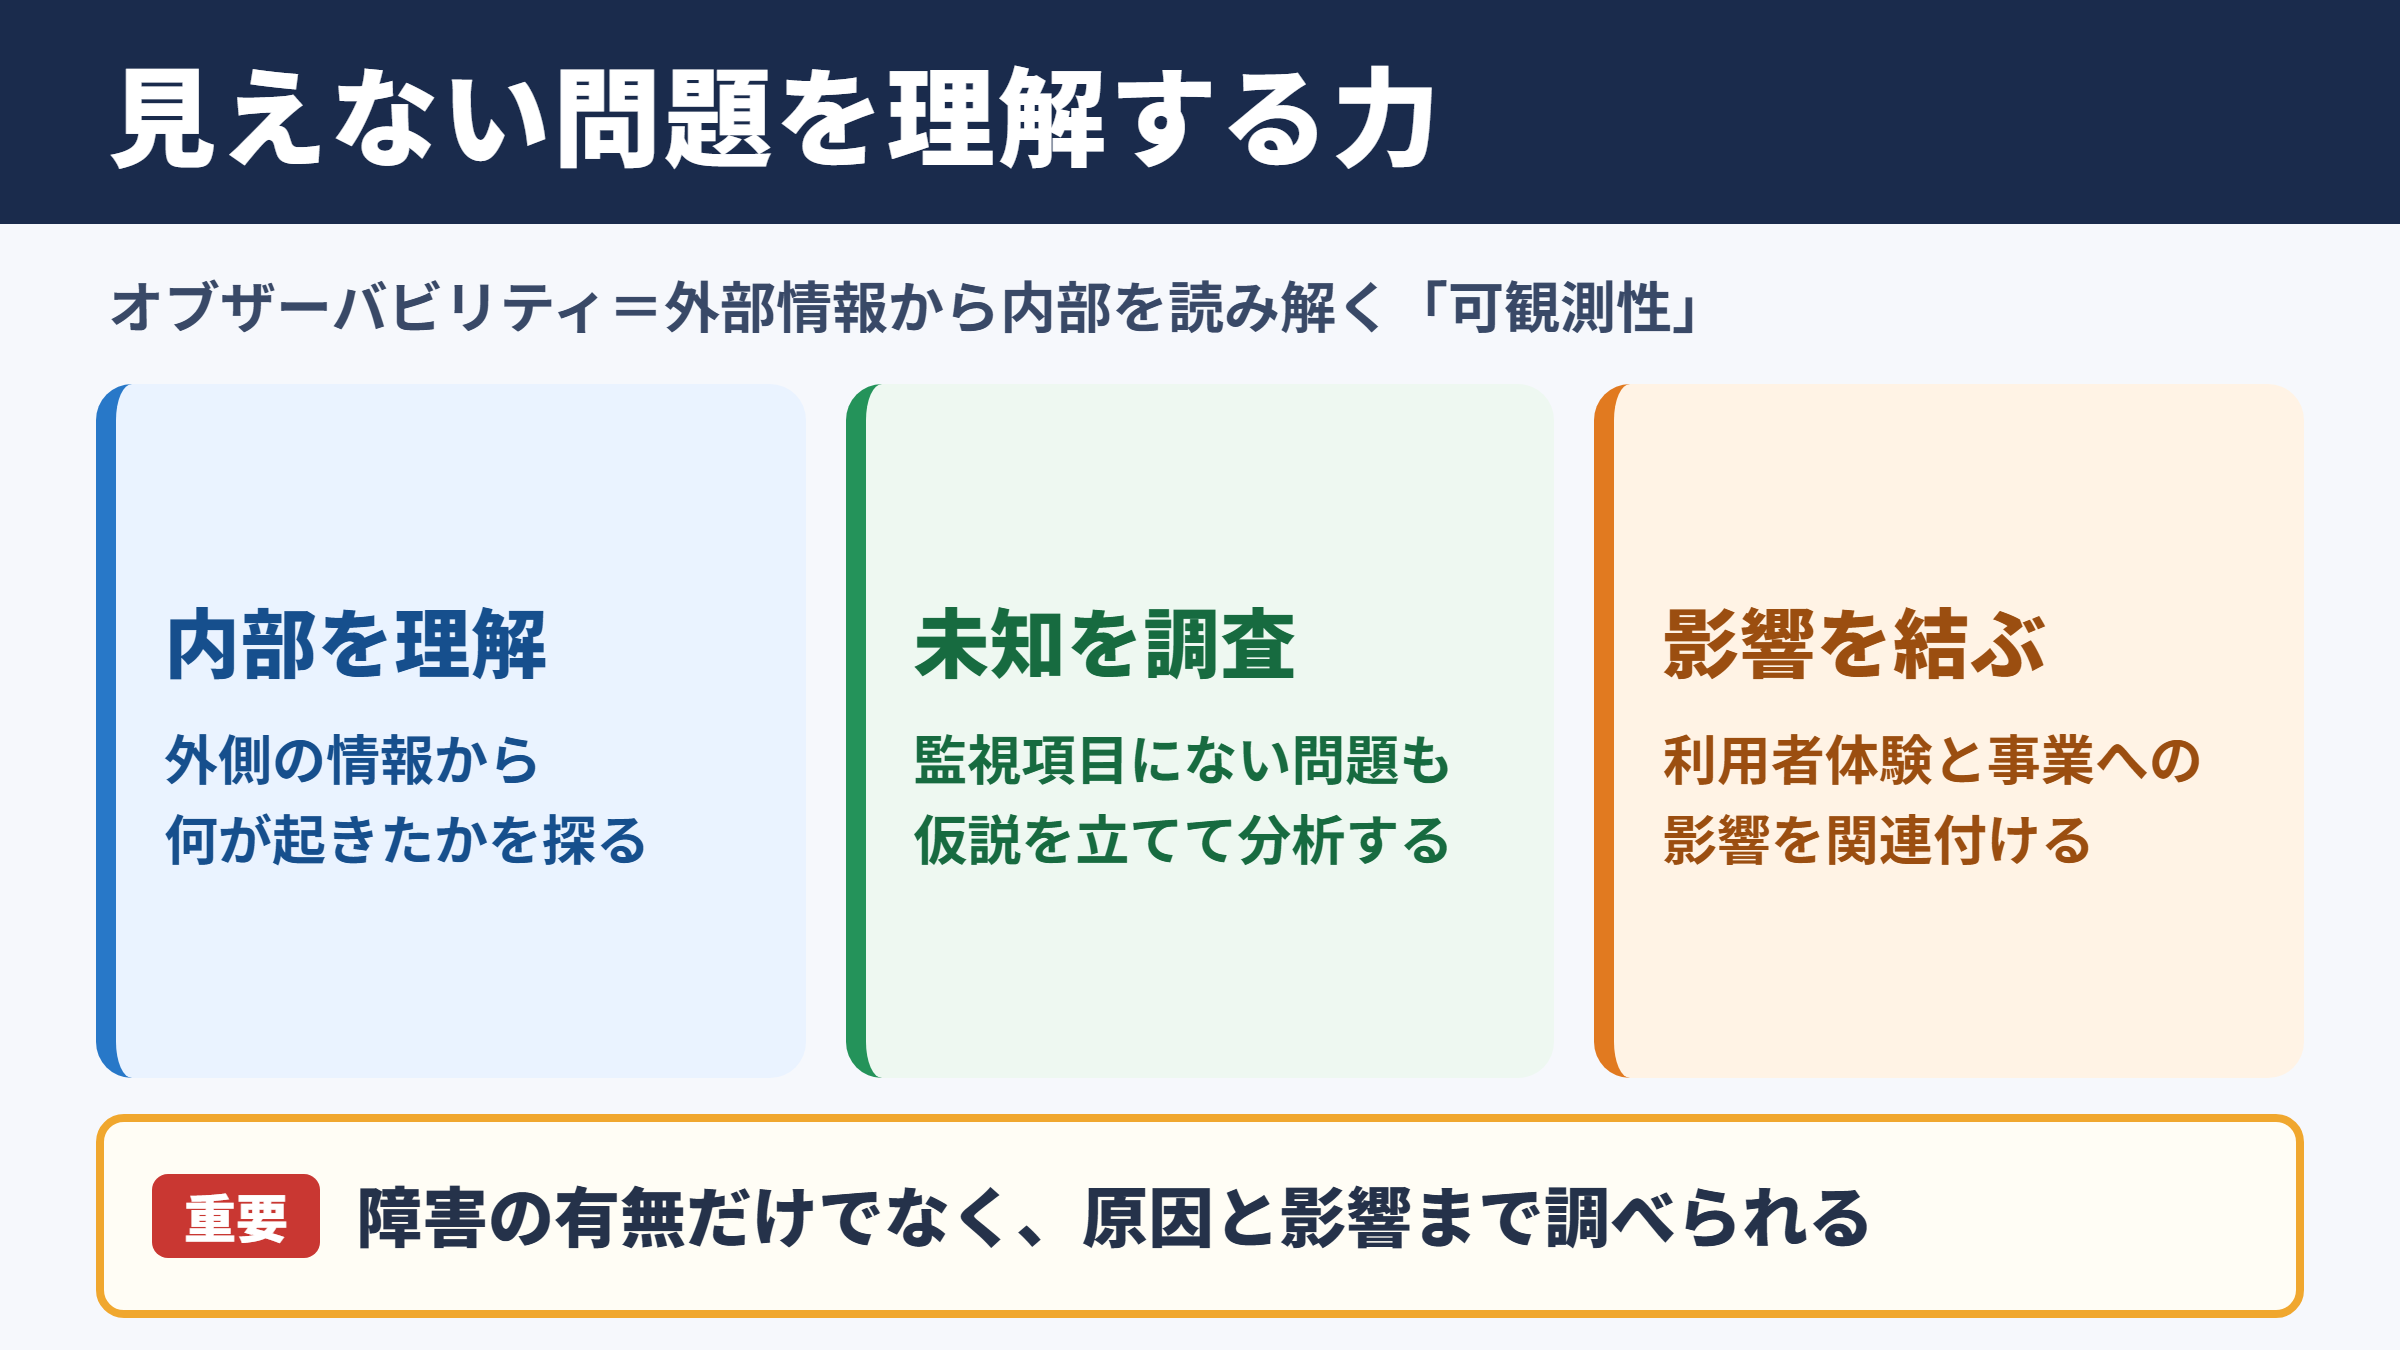
オブザーバビリティは日本語でシステム可観測性と訳され、システムの外側から得られる情報を基に、内部で何が起きているかを理解できる性質を指します。
単に異常を知らせるだけではなく、なぜ遅くなったのか、どの処理が失敗したのか、どの利用者に影響が及んだのかまで調べられる状態が重要です。
見えていない問題を推測できるようにすることが、オブザーバビリティの中心にあります。
現代のシステムは複数のクラウドサービス、マイクロサービス、外部API、データベースが連携することも珍しくありません。
そのため一部の画面だけを確認しても、障害の全体像をつかめないケースが増えています。
監視だけでは把握しにくい未知の事象
従来の監視は、CPU使用率が一定値を超えた場合や、応答時間が基準を超えた場合にアラートを出す仕組みとして活用されてきました。
これは既知の問題を検知するうえで有効ですが、想定していない不具合や複雑な連鎖障害を分析するには情報が足りない場合があります。
オブザーバビリティでは、事前に決めた監視項目以外の角度からもデータを検索し、仮説を立てながら原因に近づきます。
オブザーバビリティは、障害の有無を知らせる仕組みだけではありません。
利用者の体験、アプリケーションの処理、インフラの状態を関連付け、未知の問題を調査できる運用基盤です。
事業成果とのつながり
システムの不調は、技術部門だけの課題ではありません。
ECサイトの決済エラー、予約サービスの遅延、法人向け業務システムの停止は、売上、顧客満足度、取引先からの信頼に直結します。
技術データを事業への影響と結び付ける視点があると、優先順位を判断しやすくなります。
たとえばエラー件数が少なくても、高額な注文を行う顧客層に集中していれば、早急な対応が必要になるでしょう。
可観測性を高めることは、開発と運用の効率化に加え、経営判断の質を支える取り組みにもなります。
モニタリングとの違いと関係
続いては、オブザーバビリティとモニタリングの違いを確認していきます。
目的の違い
モニタリングは、あらかじめ定めた正常な状態を継続的に監視し、逸脱があれば通知する活動です。
一方のオブザーバビリティは、観測可能なデータを利用して、システム内部の状態や問題の原因を理解する活動といえます。
両者は対立する概念ではなく、役割が異なる補完関係にあります。
| 比較項目 | モニタリング | オブザーバビリティ |
|---|---|---|
| 主な目的 | 異常の検知 | 状態の理解と原因分析 |
| 対象となる問題 | 想定済みの問題 | 未知の問題を含む事象 |
| 代表的な方法 | しきい値監視とアラート | ログ、トレース、メトリクスの横断分析 |
| 対応の起点 | 通知を受けた時点 | データから仮説を立てた時点 |
| 得られる価値 | 早期検知 | 復旧時間の短縮と再発防止 |
アラート設計との関係
アラートを増やせば安全になるように見えても、通知が多すぎると重要な異常が埋もれてしまいます。
担当者が頻繁に通知を受け、確認しても問題がない状態が続くと、アラートへの反応が遅れるおそれがあります。
行動につながるアラートだけを残す設計が、運用負荷の軽減に役立ちます。
原因分析に必要な詳細情報は、すべてをアラート化するのではなく、ログやトレースとして検索できる状態に整えることが大切です。
監視から分析への運用変化
モニタリング中心の運用では、異常検知後に担当者が複数の画面を開き、経験を頼りに原因を探すことがあります。
オブザーバビリティを取り入れると、同じリクエストに関するログ、処理時間、依存先の応答、エラー内容を追跡しやすくなります。
例えば決済画面の応答時間が急増した場合、トレースを確認して決済API、在庫照会、データベースのどこで待機時間が発生したかを調べます。
処理全体の遅延時間から各処理の所要時間を引き比べることで、優先的に確認すべき箇所を絞り込めます。
調査の属人化を減らせる点も、チーム運用における大きな利点です。
ログ・トレース・メトリクスの基礎
続いては、可観測性を支える代表的なデータを確認していきます。
ログの役割
ログは、システム内で起きた出来事を記録したデータです。
ログイン成功や失敗、注文番号、API呼び出し、例外内容、処理日時などを残すことで、個別の事象を詳しく確認できます。
検索しやすい構造化ログにすると、担当者やツールが必要な条件で絞り込みやすくなります。
文章だけのログではなく、時刻、サービス名、リクエストID、利用者区分、エラーコードなどを項目として記録すると分析効率が高まります。
ただし、パスワード、クレジットカード情報、個人情報を不用意に記録しないルールも欠かせません。
トレースの役割
トレースは、一つの利用者操作やリクエストが、複数のサービスをどの順番で通過したかを追跡するデータです。
画面表示、認証、商品検索、在庫確認、決済といった一連の処理をつなげて確認できるため、分散システムで特に力を発揮します。
各処理単位はスパンと呼ばれ、開始時刻、終了時刻、処理名、成否などを持ちます。
リクエストを横断して追える共通IDを持たせることで、ログとトレースの行き来も容易になります。
利用者が注文を確定した時刻を起点に、注文サービスで二百ミリ秒、在庫サービスで百ミリ秒、決済サービスで二秒かかったと確認できれば、調査対象は決済側へ絞り込めます。
全体の遅延を感覚で判断せず、処理経路と時間で説明できる点がトレースの強みです。
メトリクスの役割
メトリクスは、システムの状態を数値として一定間隔で集計したデータです。
CPU使用率、メモリ使用量、リクエスト数、エラー率、応答時間、キューの滞留件数などが代表例です。
時系列のグラフで変化を把握しやすく、異常の兆候を早期に見つける用途に適しています。
メトリクスは全体傾向をつかむ入口として有用であり、詳細な調査はログやトレースで補う流れが基本です。
高い精度でデータを収集しようとして項目を増やしすぎると、保存費用や検索負荷が増えるため、目的に沿った設計が求められます。
ビジネスで求められる重要性
続いては、企業活動においてオブザーバビリティが重要となる理由を確認していきます。
顧客体験の維持
利用者はシステム内部の事情を知ることはなく、画面が遅い、購入できない、通知が届かないといった体験でサービスを評価します。
小さな性能劣化であっても、繁忙期やキャンペーン時には離脱率の上昇につながる可能性があります。
利用者視点の応答時間や成功率を見える化すれば、技術上の数値を顧客体験の課題として捉えられます。
障害が発生してから対応するだけでなく、遅延の兆候を基に増強や設定変更を行う予防的な運用にもつながります。
復旧時間と損失の抑制
障害発生時には、検知までの時間、原因特定までの時間、復旧までの時間が積み重なります。
可観測性が低い環境では、複数チームに確認を依頼し、ログを個別に集めるだけで時間を要することがあります。
障害対応で重要なのは、誰かの経験だけに頼らず、事実を共有できる状態です。
共通のダッシュボードと検索可能なデータがあれば、開発、運用、セキュリティ、事業部門が同じ状況を見ながら判断できます。
平均復旧時間を短縮できれば、売上機会の損失、問い合わせ対応、信用低下といった影響も抑えやすくなるでしょう。
開発速度と組織連携
リリース頻度が高い組織では、変更による影響を迅速に把握する必要があります。
新機能を公開した直後にエラー率や応答時間、利用状況を確認できれば、問題が広がる前にロールバックや修正を検討できます。
開発者自身が本番環境の状態を理解できる仕組みは、DevOpsやSREの実践にも役立ちます。
担当範囲だけを見るのではなく、利用者の操作からバックエンドまでを共有することで、部門間の責任の押し付け合いも減らしやすくなります。
導入設計と運用のポイント
続いては、オブザーバビリティを導入する際の実践的なポイントを確認していきます。
目的と重要な利用者行動
導入を始める際は、ツール選定より先に、どの事業上の成果を守りたいのかを整理します。
会員登録、検索、見積もり依頼、予約、購入、契約更新など、サービスにとって重要な利用者行動を洗い出すとよいでしょう。
その行動の成功率、応答時間、失敗理由を追えるようにすると、技術データが目的を失いにくくなります。
重要な購入処理について、成功率、九十五パーセンタイルの応答時間、決済失敗件数、処理経路を確認する設計を考えます。
平均値だけでは一部利用者の大きな遅延を見落とすため、遅い側の応答時間も合わせて確認することが重要です。
データ品質と関連付け
ログ、トレース、メトリクスを収集しても、サービス名や時刻の基準がばらばらでは十分に活用できません。
環境名、リリース番号、リージョン、リクエストID、エラー分類などの共通項目を定義し、各チームでそろえる必要があります。
データを関連付けるための命名規則は、導入効果を左右する重要な土台です。
特に分散トレーシングでは、サービス間でトレース情報を引き継げるかを事前に確認しましょう。
標準化が不十分なまま範囲を広げると、後から分析しにくいデータが大量に蓄積されるおそれがあります。
費用と段階的な展開
観測データは量が増えやすく、保存期間、検索頻度、サンプリング率によって費用が変わります。
すべてのログを永久に保存するのではなく、障害調査、監査、セキュリティ、分析といった用途ごとに保持方針を設計することが現実的です。
まずは売上や顧客体験に直結するサービスから始め、運用手順やダッシュボードの有効性を検証してから対象を広げると進めやすいでしょう。
導入の成功は、データ量の多さでは決まりません。
障害時に必要な問いへ短時間で答えられるか、改善判断に使えるかという実用性が判断基準になります。
オブザーバビリティの活用まとめ
オブザーバビリティは、ログ、トレース、メトリクスなどのデータを活用し、複雑なシステム内部で起きていることを理解するための考え方です。
モニタリングが既知の異常を検知する役割を持つのに対し、可観測性は未知の問題を調査し、原因を絞り込む力を高めます。
顧客体験、売上、信頼を守るための運用基盤として捉えると、導入目的が明確になります。
まずは重要な利用者行動を定め、必要なログ、トレース、メトリクスを関連付けるところから始めるとよいでしょう。
アラートの量を増やすことよりも、必要なときに状況を理解し、迅速に行動できる状態を整えることが、継続的なシステム改善につながります。