アウトオブオーダーは、CPUが命令を受け取った順番どおりではなく、実行できるものから先に処理を進める仕組みです。
一見すると処理順序が乱れるように感じられますが、プログラムが求める結果は保ちながら、待ち時間を減らすために使われています。
パソコン、スマートフォン、サーバーなどで動く高性能なCPUを理解するうえで、重要な基礎用語の一つでしょう。
この記事では、アウトオブオーダー実行の意味、処理の流れ、インオーダー実行との違いを、CPU内部の役割とともにわかりやすく解説します。
アウトオブオーダー実行の基本的な意味
それではまず、アウトオブオーダー実行の結論と基本的な考え方について解説していきます。
命令の準備状況に応じた実行順序
アウトオブオーダーは英語でOut of Orderと表記され、日本語では順不同実行や順序外実行などと説明されます。
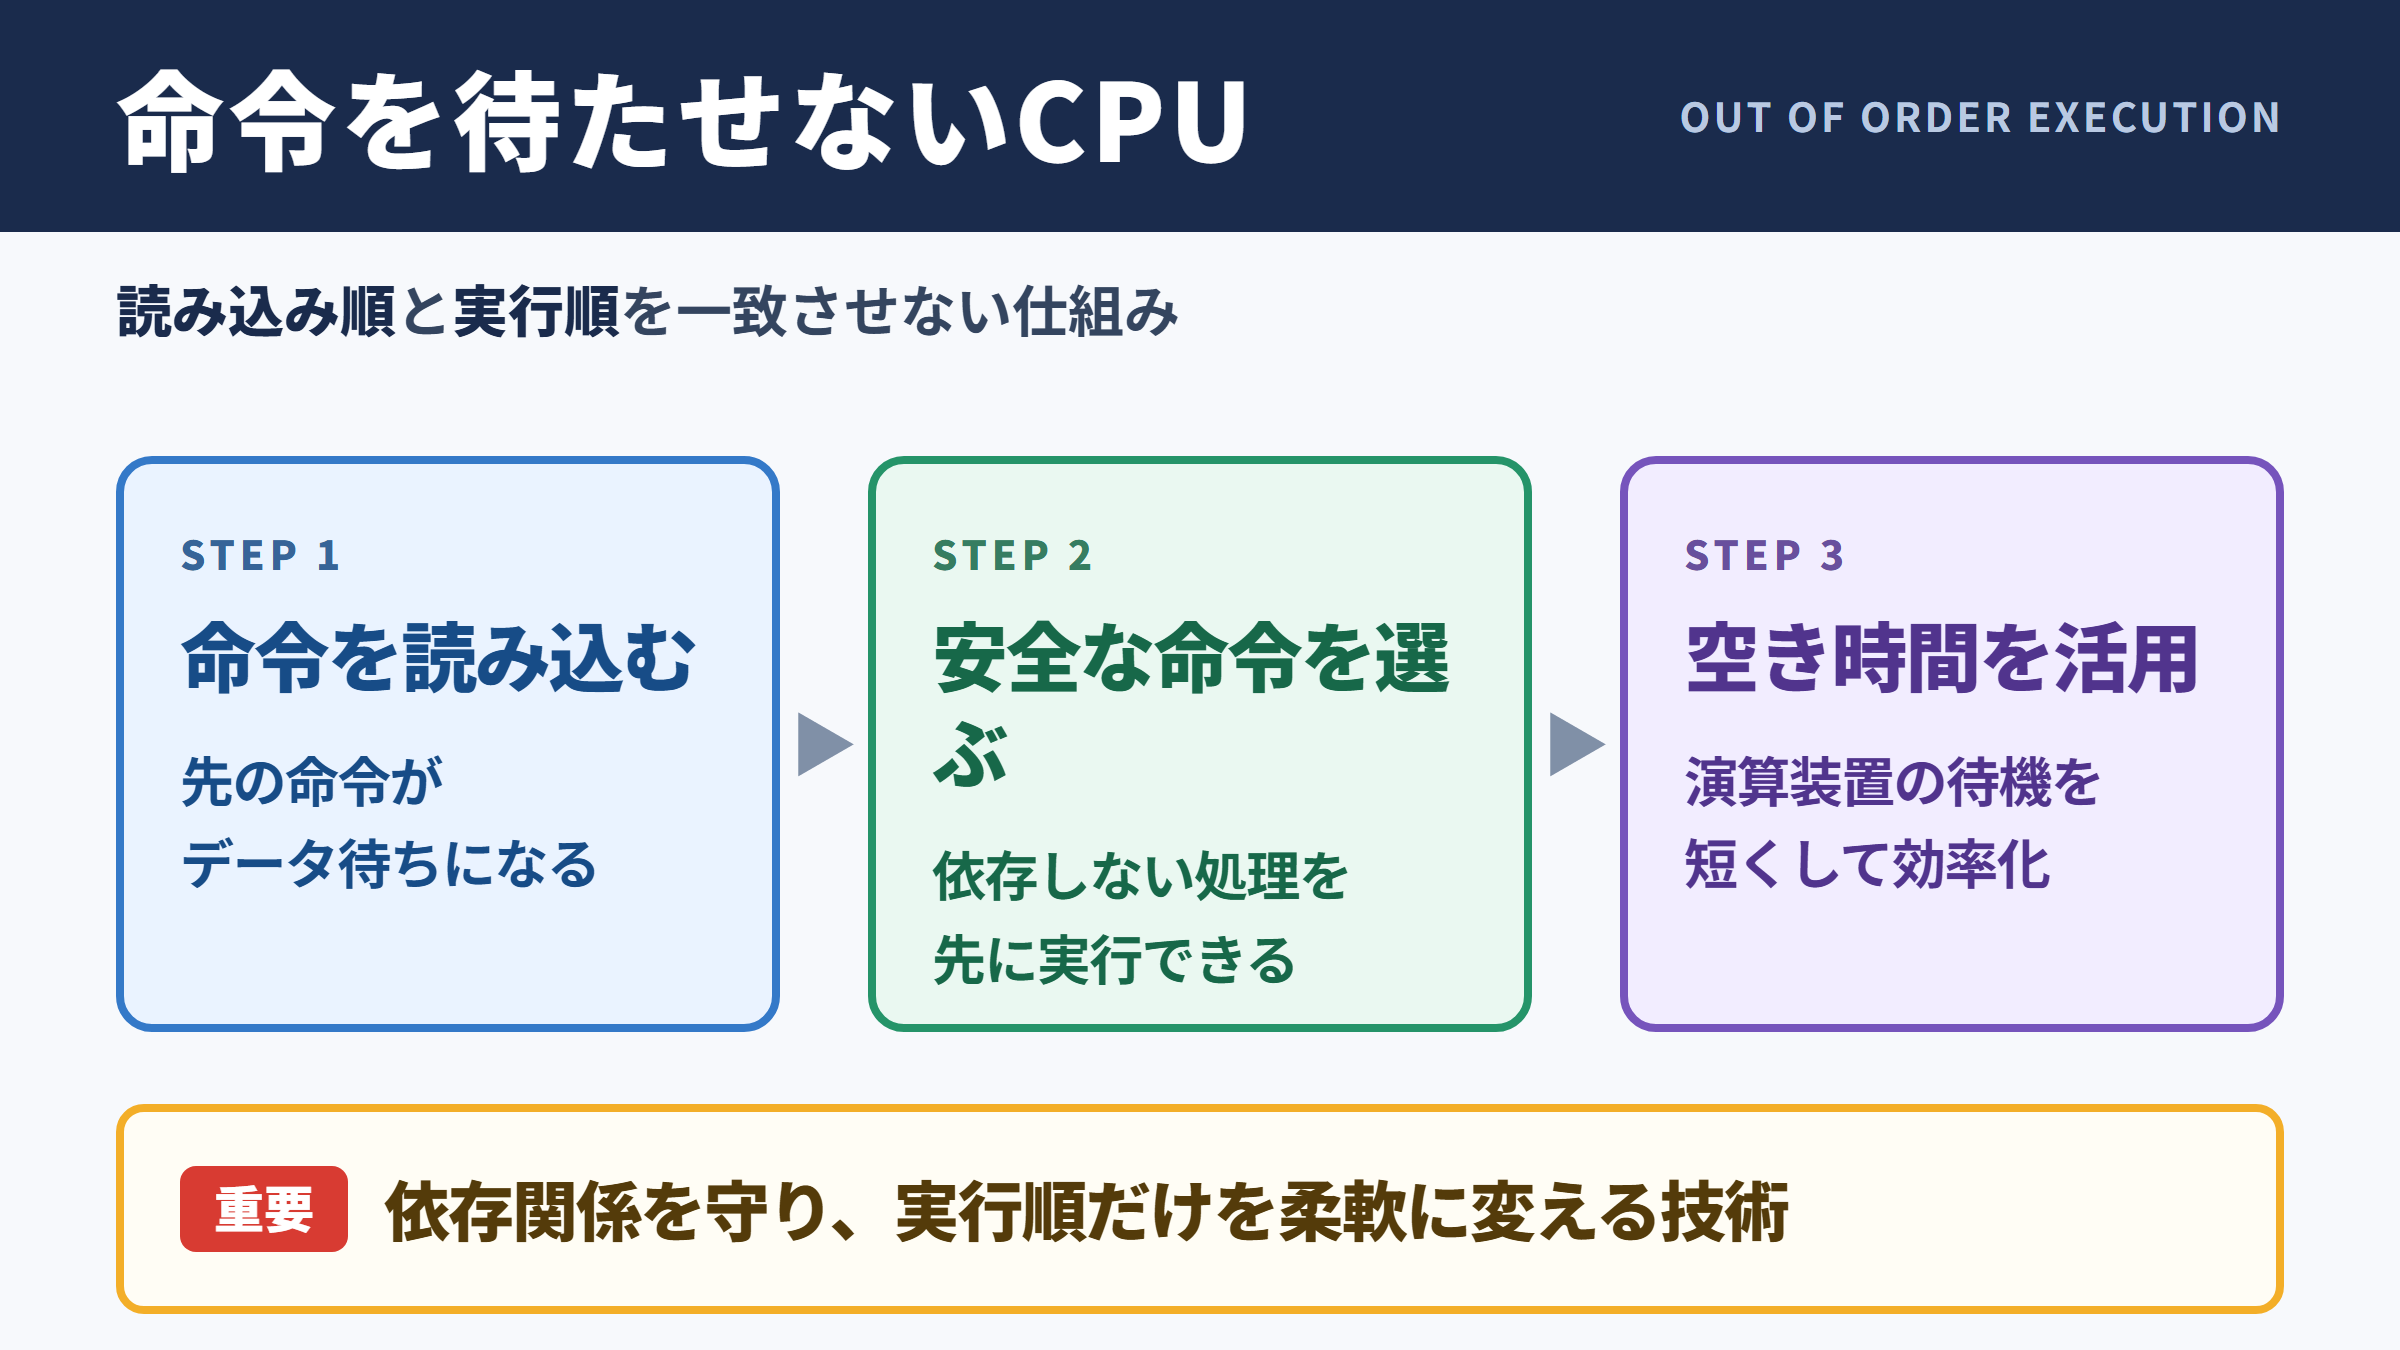
CPUがプログラムの命令を読み込む順序と、実際に計算を始める順序を一致させなくてよい点が特徴です。
たとえば先に読み込んだ命令がメモリからのデータ待ちになっている場合、その命令だけを待ち続ける必要はありません。
後ろにある命令のうち、必要なデータがそろっていて他の処理に影響しないものがあれば、CPUは先に実行できます。
この柔軟な判断によって、演算装置が何もしないまま待機する時間を短くします。
命令を勝手に並べ替えて結果を変える技術ではなく、依存関係を守ったうえで空き時間を活用する技術と理解するとわかりやすいでしょう。
簡単な例です。
命令Aが主記憶からデータを受け取るまで時間がかかり、命令BがAと無関係な加算処理なら、CPUはBを先に計算できます。
Aに必要な値が届いた時点でAを実行し、最終的にはプログラムが期待する順序で結果を扱います。
プログラムの見た目とCPU内部の動作
ソースコードや機械語の命令列には、通常は上から下へ処理する順番があります。
しかしCPU内部では、命令フェッチ、命令デコード、依存関係の確認、演算、結果の保存といった複数の工程が同時並行で進みます。
このため、外から見えるプログラムの順序と、CPUの演算器が実際に働く順番は必ずしも同じではありません。
アウトオブオーダー実行では、CPUが命令同士のつながりを調べ、先に終わらせても安全な処理を見つけます。
たとえば乗算器が空いているのに、加算命令の待ち時間だけが原因で乗算器まで止まるのは効率的ではありません。
そこでCPUは、利用可能な演算ユニットへ実行可能な命令を割り当てます。
CPU内部の順序を柔軟にすることで、クロックごとに処理できる仕事量を増やすことが主な目的です。
結果を正しく見せるための仕組み
実行順序を入れ替えるなら、途中で起きる例外や分岐の扱いが難しくなります。
そこで多くのCPUでは、計算そのものは順不同で進めつつ、プログラムに結果を反映する段階では元の順序を守る構造が採用されます。
この処理はコミット、リタイア、命令完了の確定などと呼ばれます。
先に実行した命令でも、前の命令が正常に確定するまで結果を正式な状態として公開しない考え方です。
もし前の命令でエラーや予測失敗が見つかった場合、後から実行した処理の結果を取り消せます。
そのため、ソフトウェアから見ると命令は整然と順番に終わったように振る舞います。
アウトオブオーダー実行の要点は、実行は前後しても、プログラムに見せる結果の整合性は守ることです。
高速化と正確性を両立させるため、CPUは内部で非常に細かな管理を行っています。
用語の由来とインオーダー実行の違い
続いては、言葉の由来とインオーダー実行との違いを確認していきます。
Out of Orderという英語表現
Out of Orderは、本来の順序から外れているという意味を持つ英語表現です。
CPUの分野では、命令列に書かれた順番どおりに演算を開始しない方式を指します。
略してOoO実行、OoO CPUと書かれることもあります。
英語圏では故障中や使用不可という意味でもOut of Orderが使われますが、CPU用語では故障を意味しません。
ここでは順番どおりではないという意味に着目する必要があります。
対になる用語はIn Orderであり、命令を原則として到着順に処理するインオーダー実行です。
インオーダー実行との性能差
インオーダー実行では、先頭の命令が待ち状態になると、後ろにある命令も進めにくくなります。
設計が比較的単純で、消費電力や回路規模を抑えやすい点はメリットです。
一方、メモリアクセスや除算のように時間がかかる処理があると、CPU内の演算器が空いていても十分に活用できません。
アウトオブオーダー実行は、この停止時間を減らして命令レベル並列性を引き出します。
命令レベル並列性とは、一つのプログラムに含まれる複数の命令を同時に進められる余地を意味します。
| 比較項目 | インオーダー実行 | アウトオブオーダー実行 |
|---|---|---|
| 基本の実行順 | 命令列の順番を重視 | 実行可能な命令を優先 |
| 回路の複雑さ | 比較的抑えやすい | 依存関係の管理が必要 |
| 待ち時間への強さ | 先行命令の停止に影響されやすい | 独立した後続命令を進めやすい |
| 消費電力 | 抑えやすい傾向 | 管理回路の分だけ増えやすい傾向 |
| 主な利用場面 | 小型機器や単純な処理系 | 高性能PC、サーバー、スマートフォン |
採用されるCPUの傾向
デスクトップPCやノートPC向けの高性能CPUでは、アウトオブオーダー実行が広く利用されています。
サーバー向けCPUでも、多数の要求を効率よく処理するために重要な技術です。
近年のスマートフォン向けプロセッサでも、性能と電力のバランスを考えながら採用されています。
ただし、すべてのCPUが大規模なアウトオブオーダー実行を必要とするわけではありません。
組み込み機器では、処理性能より予測しやすさ、低消費電力、低コストを優先する設計もあります。
CPUの優劣を単純に決める技術ではなく、用途に応じて選ばれる設計方針の一つです。
CPU内部で処理順序を変える流れ
続いては、アウトオブオーダー実行がCPU内部で動く流れを確認していきます。
フェッチとデコードの工程
CPUはまず、メモリ上にあるプログラムの命令を取り出します。
この作業は命令フェッチと呼ばれ、取り出した命令をCPUが理解できる形に分解する工程がデコードです。
高性能なCPUは一度に複数の命令を読み込み、複数の処理候補を内部に蓄えます。
ここで重要になるのが、後ろの命令を見通せるだけの命令ウィンドウです。
命令ウィンドウが広いほど、CPUは実行可能な命令を多く探せる可能性があります。
ただし、広げるほど回路は複雑になり、消費電力や設計上の負担も増えます。
依存関係の判定
命令の並び替えで最も大切なのは、データの依存関係を壊さないことです。
ある命令が前の命令の計算結果を必要とするなら、前の処理が終わるまで待たなければなりません。
たとえば変数Aに値を代入した後で、Aを使って計算する命令がある場合、後者を先に実行することはできません。
一方で、別の変数だけを使う計算なら、前後の命令が独立している可能性があります。
CPUはどの命令がどの値を読み書きするのかを追跡し、安全な実行順序を判断します。
この判定があるため、順不同実行は単なる並べ替えではなく、高度なスケジューリング処理といえます。
依存関係の例です。
最初にXへ10を入れ、次にXへ5を加える命令は、前後を入れ替えられません。
一方でYへ3を掛ける命令がXと無関係なら、Xの処理を待つ間にYの計算を始められます。
発行と実行ユニットへの割り当て
依存関係の確認後、実行条件が整った命令は実行ユニットへ発行されます。
実行ユニットには整数演算器、浮動小数点演算器、ロードストアユニット、分岐処理ユニットなどがあります。
加算に向いた回路、乗算に向いた回路、メモリ読み書きに向いた回路は、それぞれ役割が異なります。
CPUは空いているユニットと実行可能な命令を組み合わせ、複数の処理を並行して進めます。
この工程がうまく働くほど、命令当たりの実行効率が高まります。
クロック周波数だけでは測れないCPU性能の差は、この内部構造にも表れます。
レジスタリネーミングとリオーダーバッファ
続いては、順不同実行を支える代表的な内部機構を確認していきます。
レジスタ名の衝突回避
CPUには計算途中の値を置くレジスタがあります。
プログラム上では同じレジスタ名を何度も使いますが、実際には前の値と後の値が混在する場面があります。
そこで使われるのがレジスタリネーミングです。
これは、プログラムに見えるレジスタ名を、CPU内部の別々の物理レジスタへ割り当てる仕組みです。
同じ名前に見えるレジスタでも、内部では異なる保存先を持たせることで、不要な待ちを減らします。
レジスタリネーミングは、名前が同じという理由だけで発生する見かけ上の依存関係を解消する技術です。
リオーダーバッファの役割
リオーダーバッファは、順不同で実行された命令の結果を一時的に管理するための仕組みです。
英語ではReorder Bufferと呼ばれ、ROBと略されることがあります。
CPUは命令を先に実行しても、すぐには結果を正式なレジスタやメモリの状態へ反映しません。
リオーダーバッファに記録し、命令列の先頭から順番に問題がないかを確認します。
確定できる状態になった命令だけがコミットされるため、プログラムから見た整合性を保てます。
例外処理が起きた場合にも、未確定の命令を破棄しやすくなる点が大きな利点です。
リオーダーバッファは、内部では自由に実行しながら、外部には正しい順番で結果を見せるための整理箱のような役割を担います。
アウトオブオーダー実行の信頼性を支える中心的な仕組みです。
投機実行との関係
アウトオブオーダー実行は、投機実行と組み合わせて説明されることが多い技術です。
投機実行とは、条件分岐の結果などを予測し、正しいと見込んだ経路の命令を先回りして処理する方法を指します。
たとえば条件式の結果がまだ確定していなくても、CPUは分岐予測を使って次の命令を読み込むことがあります。
予測が当たれば待ち時間を削減できますが、外れた場合は不要になった処理を取り消す必要があります。
順不同実行は実行可能な命令を選ぶ技術であり、投機実行は未来の処理を予測して進める技術です。
両者は同じ意味ではありませんが、現代CPUでは互いに性能向上へ貢献しています。
性能向上につながる場面と限界
続いては、アウトオブオーダー実行が効果を発揮する場面と限界を確認していきます。
メモリ待ち時間の活用
CPUの演算は非常に高速ですが、主記憶からデータを取得する処理には相対的に長い時間がかかります。
キャッシュメモリに必要なデータがなければ、CPUはメモリ階層の下位へアクセスしなければなりません。
この待ち時間が発生したとき、インオーダー実行では後続命令まで止まりやすくなります。
アウトオブオーダー実行なら、読み込み待ちの命令と無関係な計算を先に進められます。
メモリ待ちの間にも演算器を働かせ続けられることが、実際の性能向上につながる代表例です。
ただし、後続の命令がすべて読み込み結果に依存していれば、順不同実行でも待機を完全には避けられません。
命令レベル並列性の大きさ
アウトオブオーダー実行の効果は、プログラム中に独立した命令がどれだけあるかによって変わります。
独立した加算、比較、アドレス計算などが多ければ、CPUは同時に進められる候補を見つけやすくなります。
反対に、前の結果を次の計算で必ず使う連鎖が長い場合、実行順序を変える余地は小さくなります。
このような依存関係の連続は、データ依存や依存チェーンと呼ばれます。
プログラムの種類によってCPU性能の伸び方が異なるのは、命令レベル並列性の量も関係しています。
コンパイラが命令を並べ替え、CPUがさらに動的に判断することで、処理効率を高める場合もあります。
性能差が出やすい例です。
画像処理のように独立した計算が多数ある処理では、複数の演算を並行させる余地があります。
前の計算結果を毎回使う単純な連鎖計算では、順不同実行だけで大きく高速化することは難しいでしょう。
電力と設計コストの課題
アウトオブオーダー実行には、命令をためる領域、依存関係を確認する回路、結果を確定する回路などが必要です。
命令数が増えるほど、どの命令が実行可能かを探す処理も複雑になります。
その結果、回路面積、消費電力、発熱、設計検証の負担が増えやすくなります。
特にバッテリー駆動の機器では、最高性能だけでなく電力効率が重要です。
順不同実行は常に大きいほどよいわけではなく、性能、電力、コストの釣り合いが重要になります。
CPUメーカーは命令ウィンドウの大きさや実行ユニット数を調整し、用途に合った設計を目指しています。
理解を深めるための関連用語
続いては、アウトオブオーダー実行と合わせて押さえたい関連用語を確認していきます。
パイプライン処理
パイプライン処理は、命令の実行を複数の段階へ分け、それぞれの段階を重ねて進める仕組みです。
工場の流れ作業のように、ある命令が演算中でも、次の命令はデコード、その次の命令はフェッチを行えます。
アウトオブオーダー実行は、このパイプラインをより効率よく使うための技術と考えられます。
先頭の命令が止まった際に、パイプライン全体が空きやすくなる状況を減らせるためです。
ただしパイプラインが深いほど、分岐予測の失敗時に取り消す処理が増える場合もあります。
CPU設計では、処理段階の数と予測精度、実行順序の制御が密接に関係します。
スーパースカラと同時実行
スーパースカラは、1クロックの間に複数の命令を発行できるCPU設計を指します。
複数の実行ユニットを備え、加算と乗算、ロード処理などを並行して進める方式です。
アウトオブオーダー実行は、スーパースカラCPUが複数の命令を有効に発行するために役立ちます。
命令を順番どおりにしか処理できないと、利用可能な演算器があっても仕事を渡せないことがあります。
複数の演算器を持つことと、そこへ実行可能な命令を柔軟に送ることは、別々ながら補い合う関係です。
この二つが組み合わさることで、CPUは限られたクロック時間をより有効に使えます。
キャッシュと分岐予測
キャッシュメモリは、CPUがよく使うデータや命令を高速に取り出すための記憶領域です。
キャッシュヒットが多ければ、メモリ待ちが減り、アウトオブオーダー実行に頼る場面も少なくなります。
一方、キャッシュミスが起きたときは、順不同実行が待ち時間を埋める助けになります。
分岐予測は、if文のような条件分岐で次にどちらへ進むかを予測する技術です。
予測精度が高いほど、CPUは先の命令を途切れにくく読み込み、実行候補を確保できます。
キャッシュ、分岐予測、アウトオブオーダー実行は、それぞれ異なる役割でCPUの処理性能を支えています。
CPUの速さはクロック周波数だけで決まりません。
キャッシュの効率、分岐予測、パイプライン、命令の並列性、アウトオブオーダー実行など、多くの仕組みが組み合わさって体感性能につながります。
まとめ
アウトオブオーダー実行とは、CPUが命令列の順番に縛られず、条件が整った命令から処理することで待ち時間を減らす技術です。
先行する命令がメモリアクセスなどで止まっていても、独立した後続命令を進められるため、演算器の遊休時間を減らせます。
ただし結果を無秩序に反映するわけではありません。
依存関係の判定、レジスタリネーミング、リオーダーバッファ、コミット処理によって、プログラムが期待する正しい結果を守っています。
インオーダー実行より複雑で電力も必要になりやすい一方、高性能CPUが多くの命令を効率よく処理するうえで欠かせない考え方です。
CPUの仕様を見るときは、コア数やクロック数だけでなく、アウトオブオーダー実行、キャッシュ、分岐予測といった内部設計にも目を向けると、性能差への理解が深まるでしょう。