
機械学習の分類モデルを評価するとき、正解率だけでは性能を十分に判断できない場面があります。
とくに、不正利用の検知、病気のスクリーニング、迷惑メールの判定のように、見逃しと誤検知のどちらを重く見るかが重要なテーマでは、適合率と再現率の理解が欠かせません。
両者は似た指標に見えますが、確認している方向が異なります。
この記事では、PrecisionとRecallの意味、混同行列を使った計算方法、F値やF1スコアとの関係、用途別の考え方までをわかりやすく整理します。
適合率と再現率の違い
それではまず、適合率と再現率の違いについて解説していきます。
適合率が示す予測の確かさ
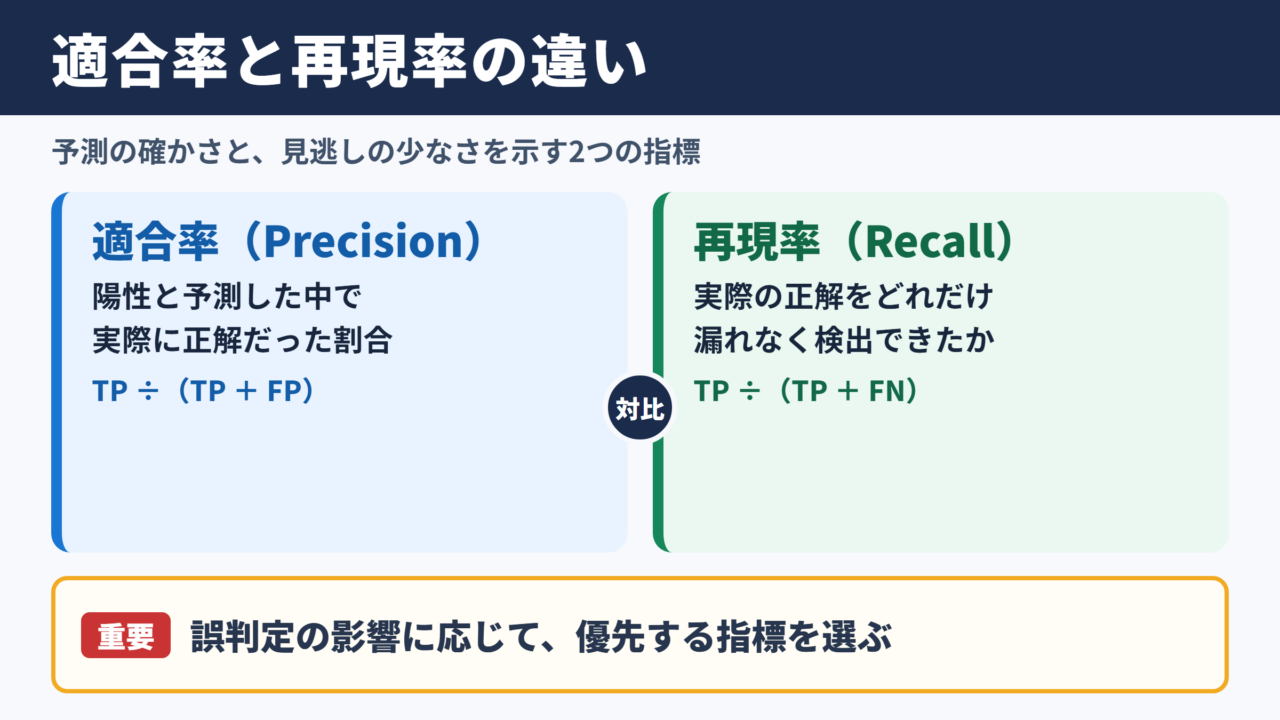
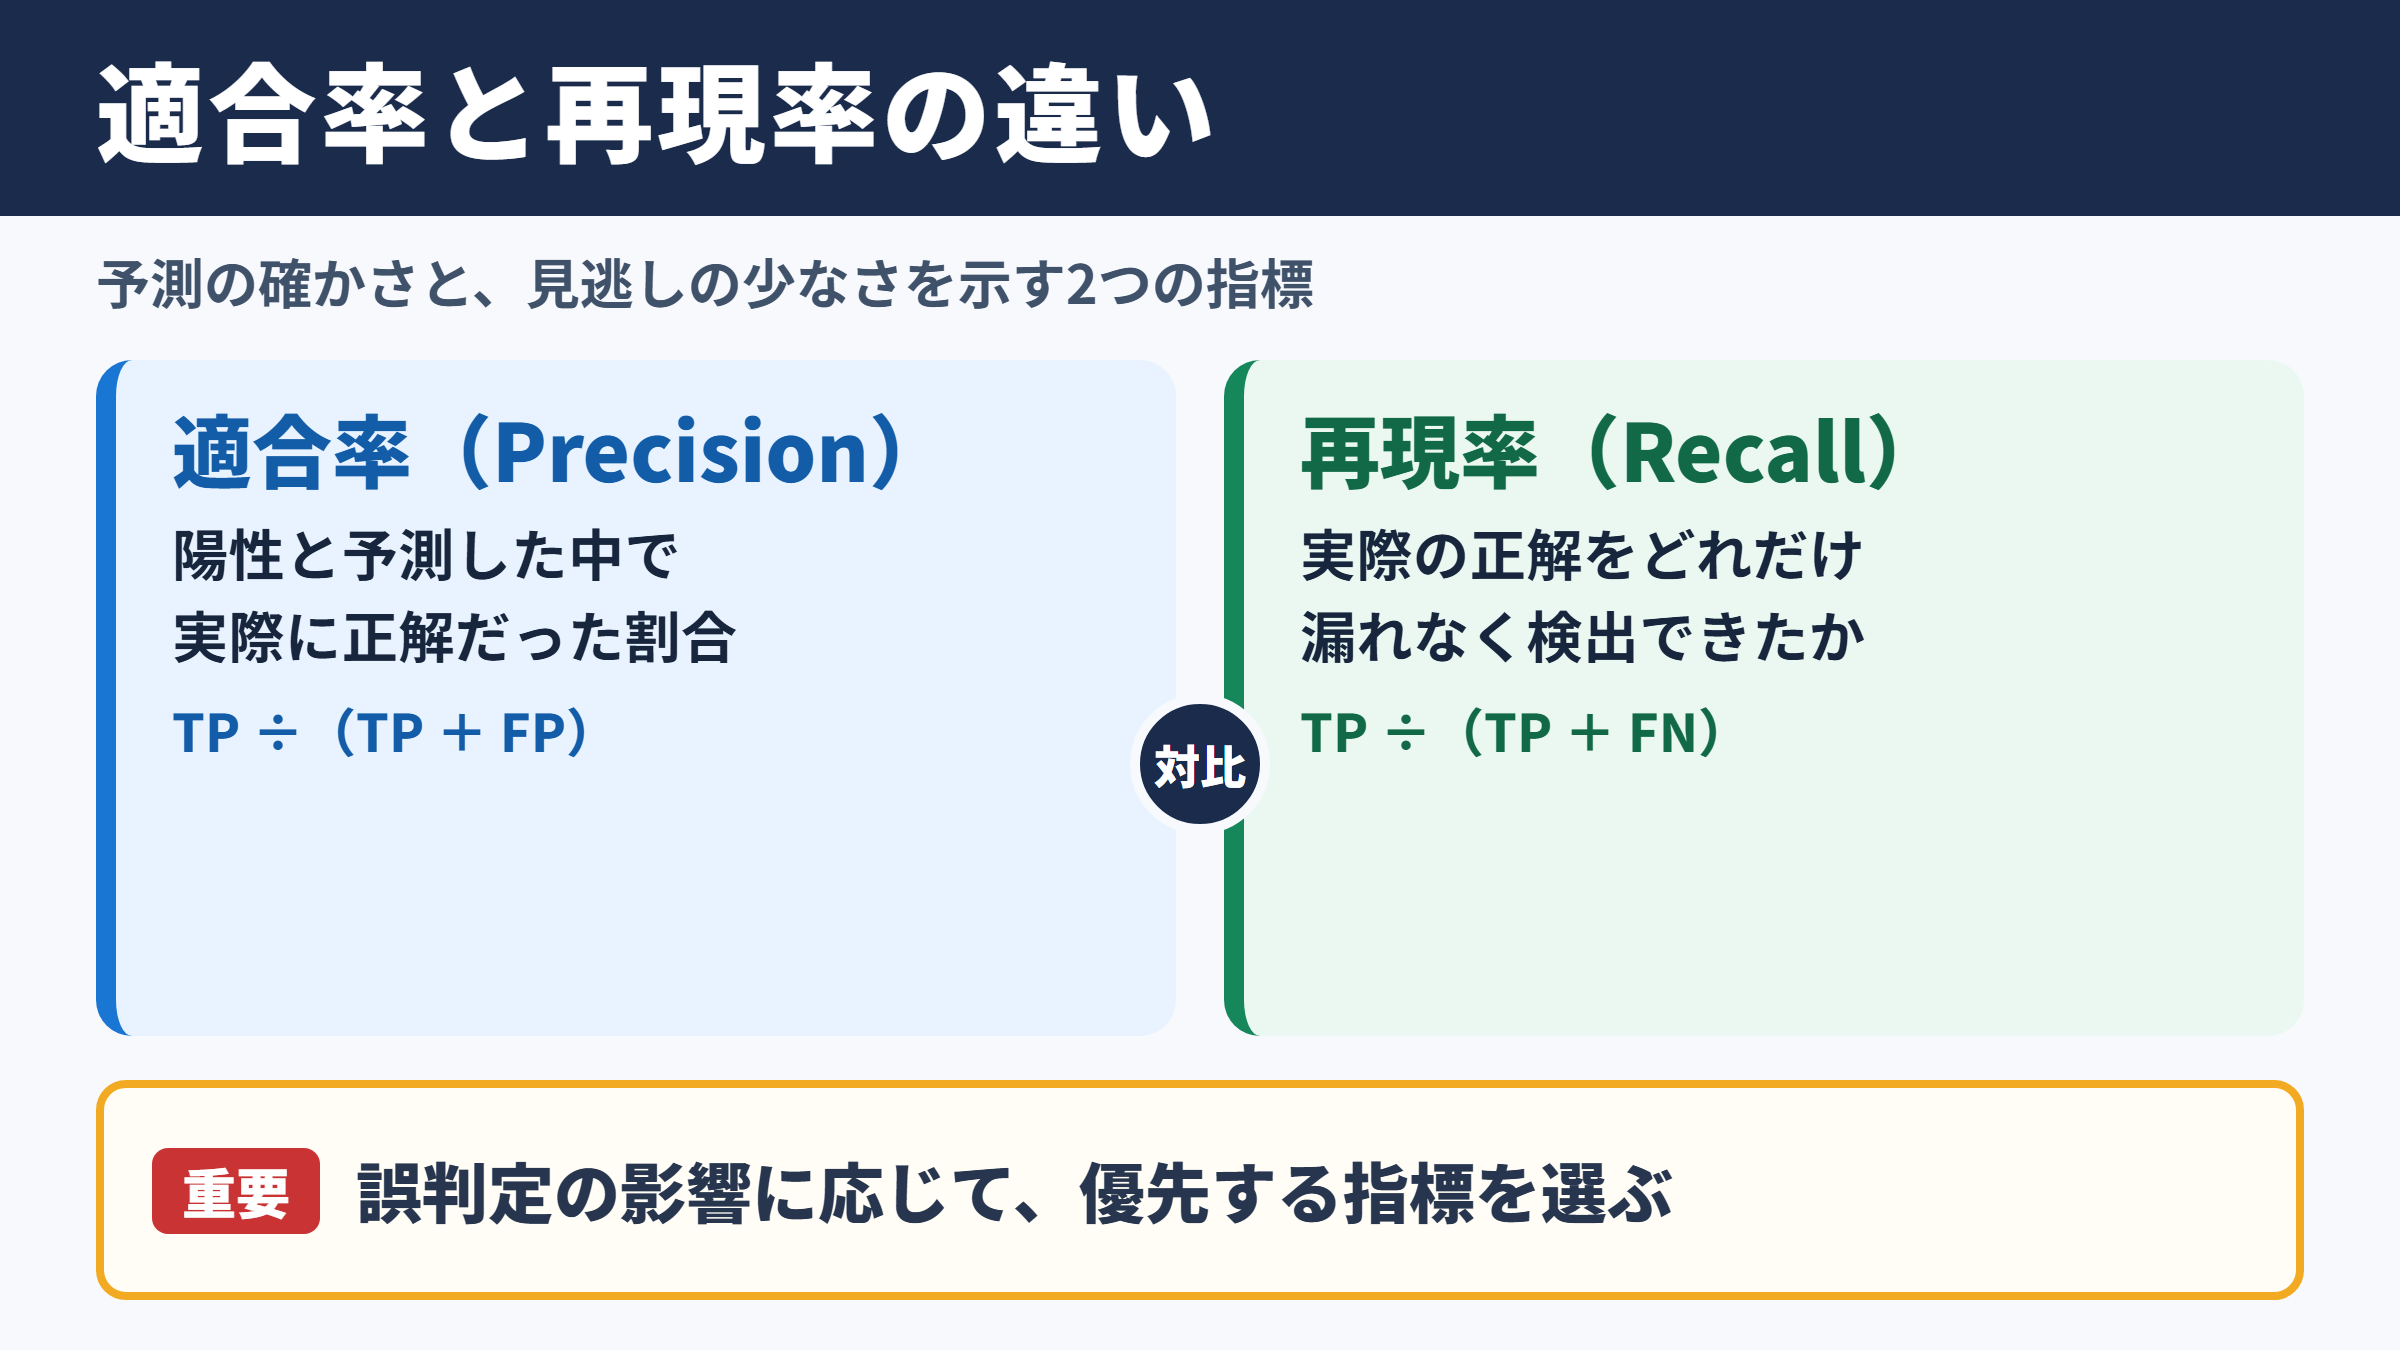
適合率は、モデルが正解だと予測したデータのうち、実際に正解だった割合を表す指標です。
英語ではPrecisionと呼ばれ、予測の的中の確かさを確認したいときに使われます。
たとえば、あるメールを迷惑メールだと判定した件数が100件あり、そのうち90件が本当に迷惑メールだった場合、適合率は90パーセントです。
適合率が高いモデルは、正解だと出した判定の信頼性が高いと考えられます。
一方で、慎重になりすぎると、正解と予測する件数自体が少なくなり、見つけるべき対象を取りこぼす可能性もあります。
適合率の計算式は、真陽性を真陽性と偽陽性の合計で割る形です。
Precision = TP ÷ (TP + FP)
TPは正しく陽性と判定した件数、FPは誤って陽性と判定した件数を指します。
再現率が示す見逃しの少なさ
再現率は、実際に正解であるデータのうち、モデルが正解として検出できた割合を示します。
Recallとも呼ばれ、対象をどの程度漏れなく拾えているかを知るための指標です。
実際には病気の人が100人いて、そのうち95人を陽性と判定できたなら、再現率は95パーセントになります。
再現率が高いほど見逃しは少なくなりますが、陽性と判定する範囲を広げすぎれば、誤った陽性判定も増えやすくなります。
このように、再現率だけを高めても、必ずしも実務で使いやすいモデルになるとは限りません。
再現率の計算式は、真陽性を真陽性と偽陰性の合計で割る形です。
Recall = TP ÷ (TP + FN)
FNは、本来は陽性なのに陰性と判定してしまった件数です。
用途によって変わる優先順位
適合率と再現率のどちらを優先するべきかは、誤判定による影響で変わります。
迷惑メール判定で普通のメールを大量に隔離してしまうと、重要な連絡を見落とすおそれがあります。
この場合は、迷惑メールと判定した結果の正確さ、つまり適合率が重要になりやすいでしょう。
反対に、重大な病気の一次検査では、陽性者を見逃さないことが大切です。
そのため、再現率を優先する設計が選ばれることがあります。
適合率は予測した陽性の正しさ、再現率は実際の陽性を見つける力を表します。
どちらか一方の数字だけで優劣を決めず、業務上許容できない失敗が何かを先に定めることが重要です。
混同行列による判定分類
続いては、適合率と再現率の土台となる混同行列を確認していきます。
真陽性と偽陽性の意味
二値分類では、予測結果と実際の結果を組み合わせて四つの区分に分けます。
実際に陽性で、モデルも陽性と予測した結果が真陽性です。
たとえば不正取引を不正取引として検知できた場合が該当します。
実際は陰性なのに、モデルが陽性と予測した結果は偽陽性です。
不正ではない正常な購入を不正だと止めてしまうケースが、偽陽性の代表例でしょう。
適合率では、真陽性の多さだけでなく、偽陽性をどこまで減らせるかが焦点になります。
真陰性と偽陰性の意味
実際に陰性で、モデルも陰性と予測した結果は真陰性です。
正常なメールを正常と判定するような結果が該当します。
一方、実際は陽性なのにモデルが陰性と予測した結果は偽陰性です。
病気の人を問題なしと判定したり、不正利用を通常の取引として通したりするケースが該当します。
再現率を高めたい場合には、偽陰性を減らすことが主要な課題になります。
混同行列の見方
混同行列は、実際の正解ラベルを縦軸、モデルの予測ラベルを横軸として整理すると理解しやすくなります。
| 実際の状態 | 陽性と予測 | 陰性と予測 |
|---|---|---|
| 実際は陽性 | 真陽性 TP | 偽陰性 FN |
| 実際は陰性 | 偽陽性 FP | 真陰性 TN |
適合率は予測が陽性だった列に注目し、再現率は実際に陽性だった行に注目する考え方です。
表を使うと、二つの指標が同じ真陽性を使いながら、分母に置く値が異なることを把握できます。
評価レポートを見るときは、割合だけでなく各件数も確認すると、実際の失敗の規模をつかみやすくなります。
計算方法と具体例
続いては、数値を使った適合率と再現率の計算方法を確認していきます。
メール分類の計算例
1,000通のメールを分類し、実際に迷惑メールだったものが100通あったとします。
モデルが迷惑メールと予測した件数は120通で、そのうち80通が本当に迷惑メールでした。
このとき、真陽性は80件、偽陽性は40件、偽陰性は20件です。
適合率は80 ÷ 120で、およそ66.7パーセントです。
再現率は80 ÷ 100で、80パーセントになります。
迷惑メールの取りこぼしは20通であり、正常メールを迷惑メールと誤判定した件数は40通です。
この結果では、実際の迷惑メールの多くを検出できていますが、迷惑メールと判定したうち約3分の1は誤判定です。
利用者の受信箱を守る目的と、正常メールを確実に届ける目的のバランスを考える必要があります。
正解率だけでは不足する理由
正解率は、全体の予測のうち正しかった割合を表すAccuracyです。
一見すると直感的ですが、陽性データが少ない不均衡データでは誤解を招くことがあります。
たとえば1万件の取引のうち、不正利用が100件しかない状況を考えてみましょう。
すべてを正常と判定しても、正解率は99パーセントになります。
しかし、不正利用を一件も発見できていないため、検知システムとしては役に立ちません。
このようなケースでは、正解率と適合率と再現率を併記することが欠かせません。
しきい値による数値変化
確率を出力する分類モデルでは、何パーセント以上なら陽性とするかというしきい値を設定します。
しきい値を低くすると陽性判定が増え、再現率は上がりやすい傾向があります。
ただし、実際は陰性のデータまで陽性と扱いやすくなるため、適合率が下がることもあります。
反対に、しきい値を高くすると陽性判定は慎重になり、適合率は高まりやすい一方で、再現率の低下につながる場合があります。
最適なしきい値は固定の数字ではなく、誤検知や見逃しにかかるコストを踏まえて決めるものです。
しきい値を変更すると、適合率と再現率は同時に動きます。
テストデータで最も高い数字を選ぶだけでなく、運用中の利用者や業務フローへの影響まで見通して調整しましょう。
F値とF1スコアの関係
続いては、適合率と再現率を一つの数値にまとめるF値とF1スコアを確認していきます。
F1スコアの基本
F1スコアは、適合率と再現率の調和平均です。
二つの指標をバランスよく評価したいときに、広く利用されています。
単純平均ではなく調和平均を使うため、片方だけが高くてもスコアは大きく伸びません。
適合率が100パーセントでも再現率が10パーセントなら、十分な性能とは評価しにくい仕組みです。
F1スコアの計算式は次のとおりです。
F1 = 2 × Precision × Recall ÷ (Precision + Recall)
適合率と再現率がともに1の場合、F1スコアも1になります。
調和平均を用いる理由
調和平均は、小さい値の影響を受けやすい平均方法です。
そのため、適合率と再現率の一方だけが高い状況を見逃しにくくなります。
たとえば適合率が90パーセント、再現率が30パーセントの場合、単純平均は60パーセントです。
しかしF1スコアは約45パーセントとなり、検出漏れの大きさをより慎重に反映します。
両方をある程度高い水準へ近づけたい場合に、F1スコアは便利な共通指標になります。
Fベータスコアの使い分け
適合率と再現率を同じ重さで扱うのがF1スコアです。
ただし、業務によっては再現率をより重視したい場合や、適合率を優先したい場合もあります。
そのようなときに使うのがFベータスコアです。
ベータが1より大きい場合は再現率を重く評価し、1より小さい場合は適合率を重く評価します。
医療の見逃し対策ではF2スコア、誤検知を抑えたい自動承認ではF0.5スコアを検討する考え方があります。
ただし、スコアの選択は目的の代わりにはなりません。
何を防ぎたいのかを文章で明確にしたうえで指標を設定することが大切です。
評価指標の使い分け
続いては、機械学習の実務における評価指標の使い分けを確認していきます。
医療検査と異常検知の考え方
医療検査や設備の異常検知では、見逃しによる損失が大きくなることがあります。
その場合、再現率を高く保つことが重要です。
初期段階で幅広く候補を拾い、その後に専門家の確認や追加検査を行う設計が選ばれることもあります。
ただし、偽陽性が多すぎると、利用者の不安や確認作業の増加につながります。
再現率を最優先にしつつも、適合率が許容範囲にあるかを確認する視点が必要です。
検索システムと推薦システムの考え方
検索結果や商品推薦では、利用者に不要な候補を多く見せると満足度が下がる可能性があります。
上位に表示する件数が限られる場合、適合率はとくに重要な指標です。
一方で、関連性の高い情報が検索結果にまったく現れないと、検索サービスとしての価値が下がります。
検索順位の評価では、適合率や再現率に加え、上位何件に正解が含まれているかを見る指標も利用されます。
評価対象となる利用場面に合わせ、指標の集計範囲を決めることがポイントです。
不均衡データにおける確認項目
不正検知、故障予測、希少疾患の識別では、陽性データが極端に少ないことがあります。
このような不均衡データでは、正解率だけを見ると、ほとんど役に立たないモデルでも高得点に見える場合があります。
適合率、再現率、F1スコアに加え、陽性と予測した件数そのものも確認しましょう。
学習用データとテスト用データで陽性率が異なる場合、運用後の数値も変わる可能性があります。
データ分割では、各データセットのクラス比率をできるだけ保つ層化抽出も有効です。
評価指標はモデルの通知表ではなく、業務上のリスクを数値で点検するための道具です。
適合率、再現率、F1スコア、件数、しきい値を組み合わせて見ることで、実装後の判断が安定します。
適合率と再現率のまとめ
適合率は、陽性と予測した結果がどれほど正しいかを表す指標です。
再現率は、実際に陽性である対象をどれほど見つけられたかを示します。
適合率を重視すると誤検知を抑えやすく、再現率を重視すると見逃しを減らしやすい特徴があります。
二つの数値にはトレードオフがあるため、片方だけを最大化する考え方では実務に合わないことがあります。
混同行列で真陽性、偽陽性、偽陰性、真陰性の件数を確認し、目的に応じて評価することが出発点です。
両方のバランスを一つの数値で確認したいときには、F1スコアが役立ちます。
医療検査、不正検知、検索、推薦など、用途ごとに許容できない失敗を定義し、しきい値と評価指標を選びましょう。
この視点を持つことで、機械学習モデルの精度を数字だけでなく、現実の価値として判断しやすくなります。

