生成AIを仕事で使う場面が増える一方で、もっともらしい誤答や古い情報への不安を感じる人は少なくありません。
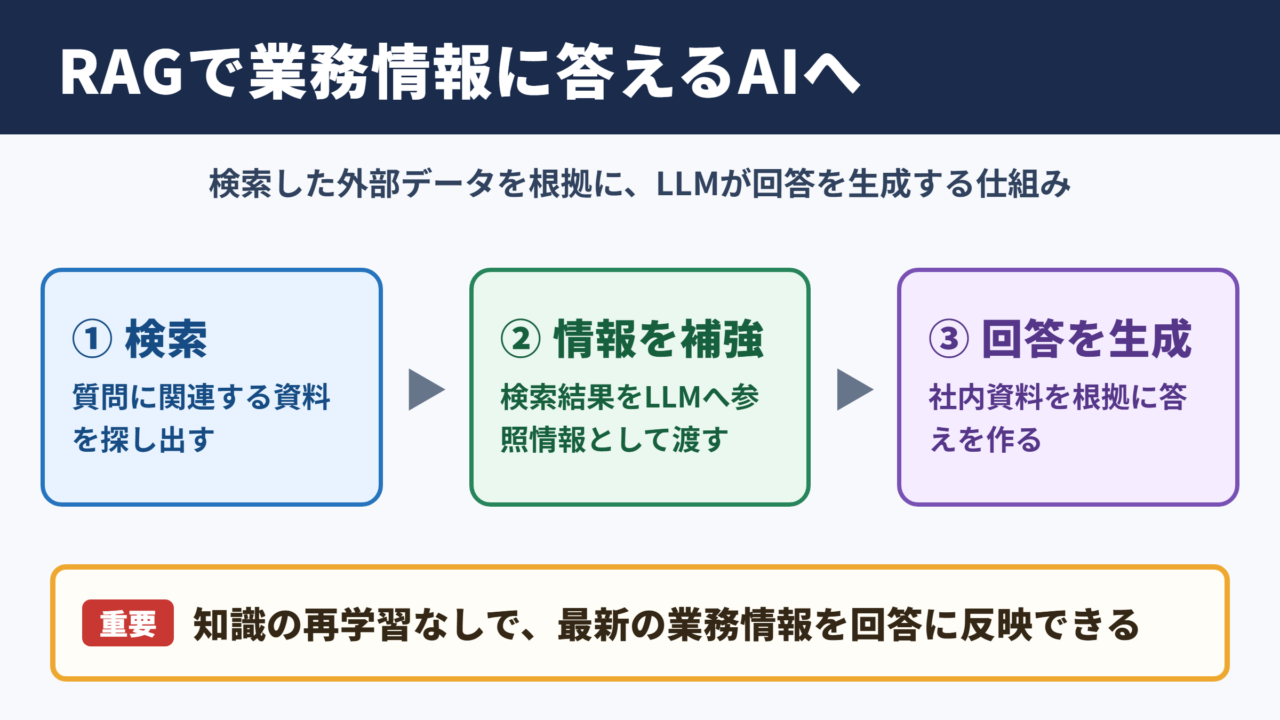
こうした課題への対策として注目されている技術が、検索拡張生成と呼ばれるRAGです。
RAGは社内文書、商品情報、規程、顧客対応履歴などを根拠にして、LLMの回答品質を高める仕組みです。
この記事ではRAGの意味、基本構造、ビジネスでの活用例、導入時に確認したい精度改善のポイントまで、わかりやすく整理します。
RAGの意味とビジネス活用の結論
それではまずRAGの意味と、ビジネスで期待できる役割について解説していきます。
検索拡張生成としてのRAG
RAGはRetrieval Augmented Generationの略称で、日本語では検索拡張生成と訳されます。
Retrievalは必要な情報を探し出す検索、Augmentedは情報を追加して補強すること、Generationは文章を生成することを意味します。
一般的なLLMは、学習済みの知識と入力された指示を基に回答を組み立てます。
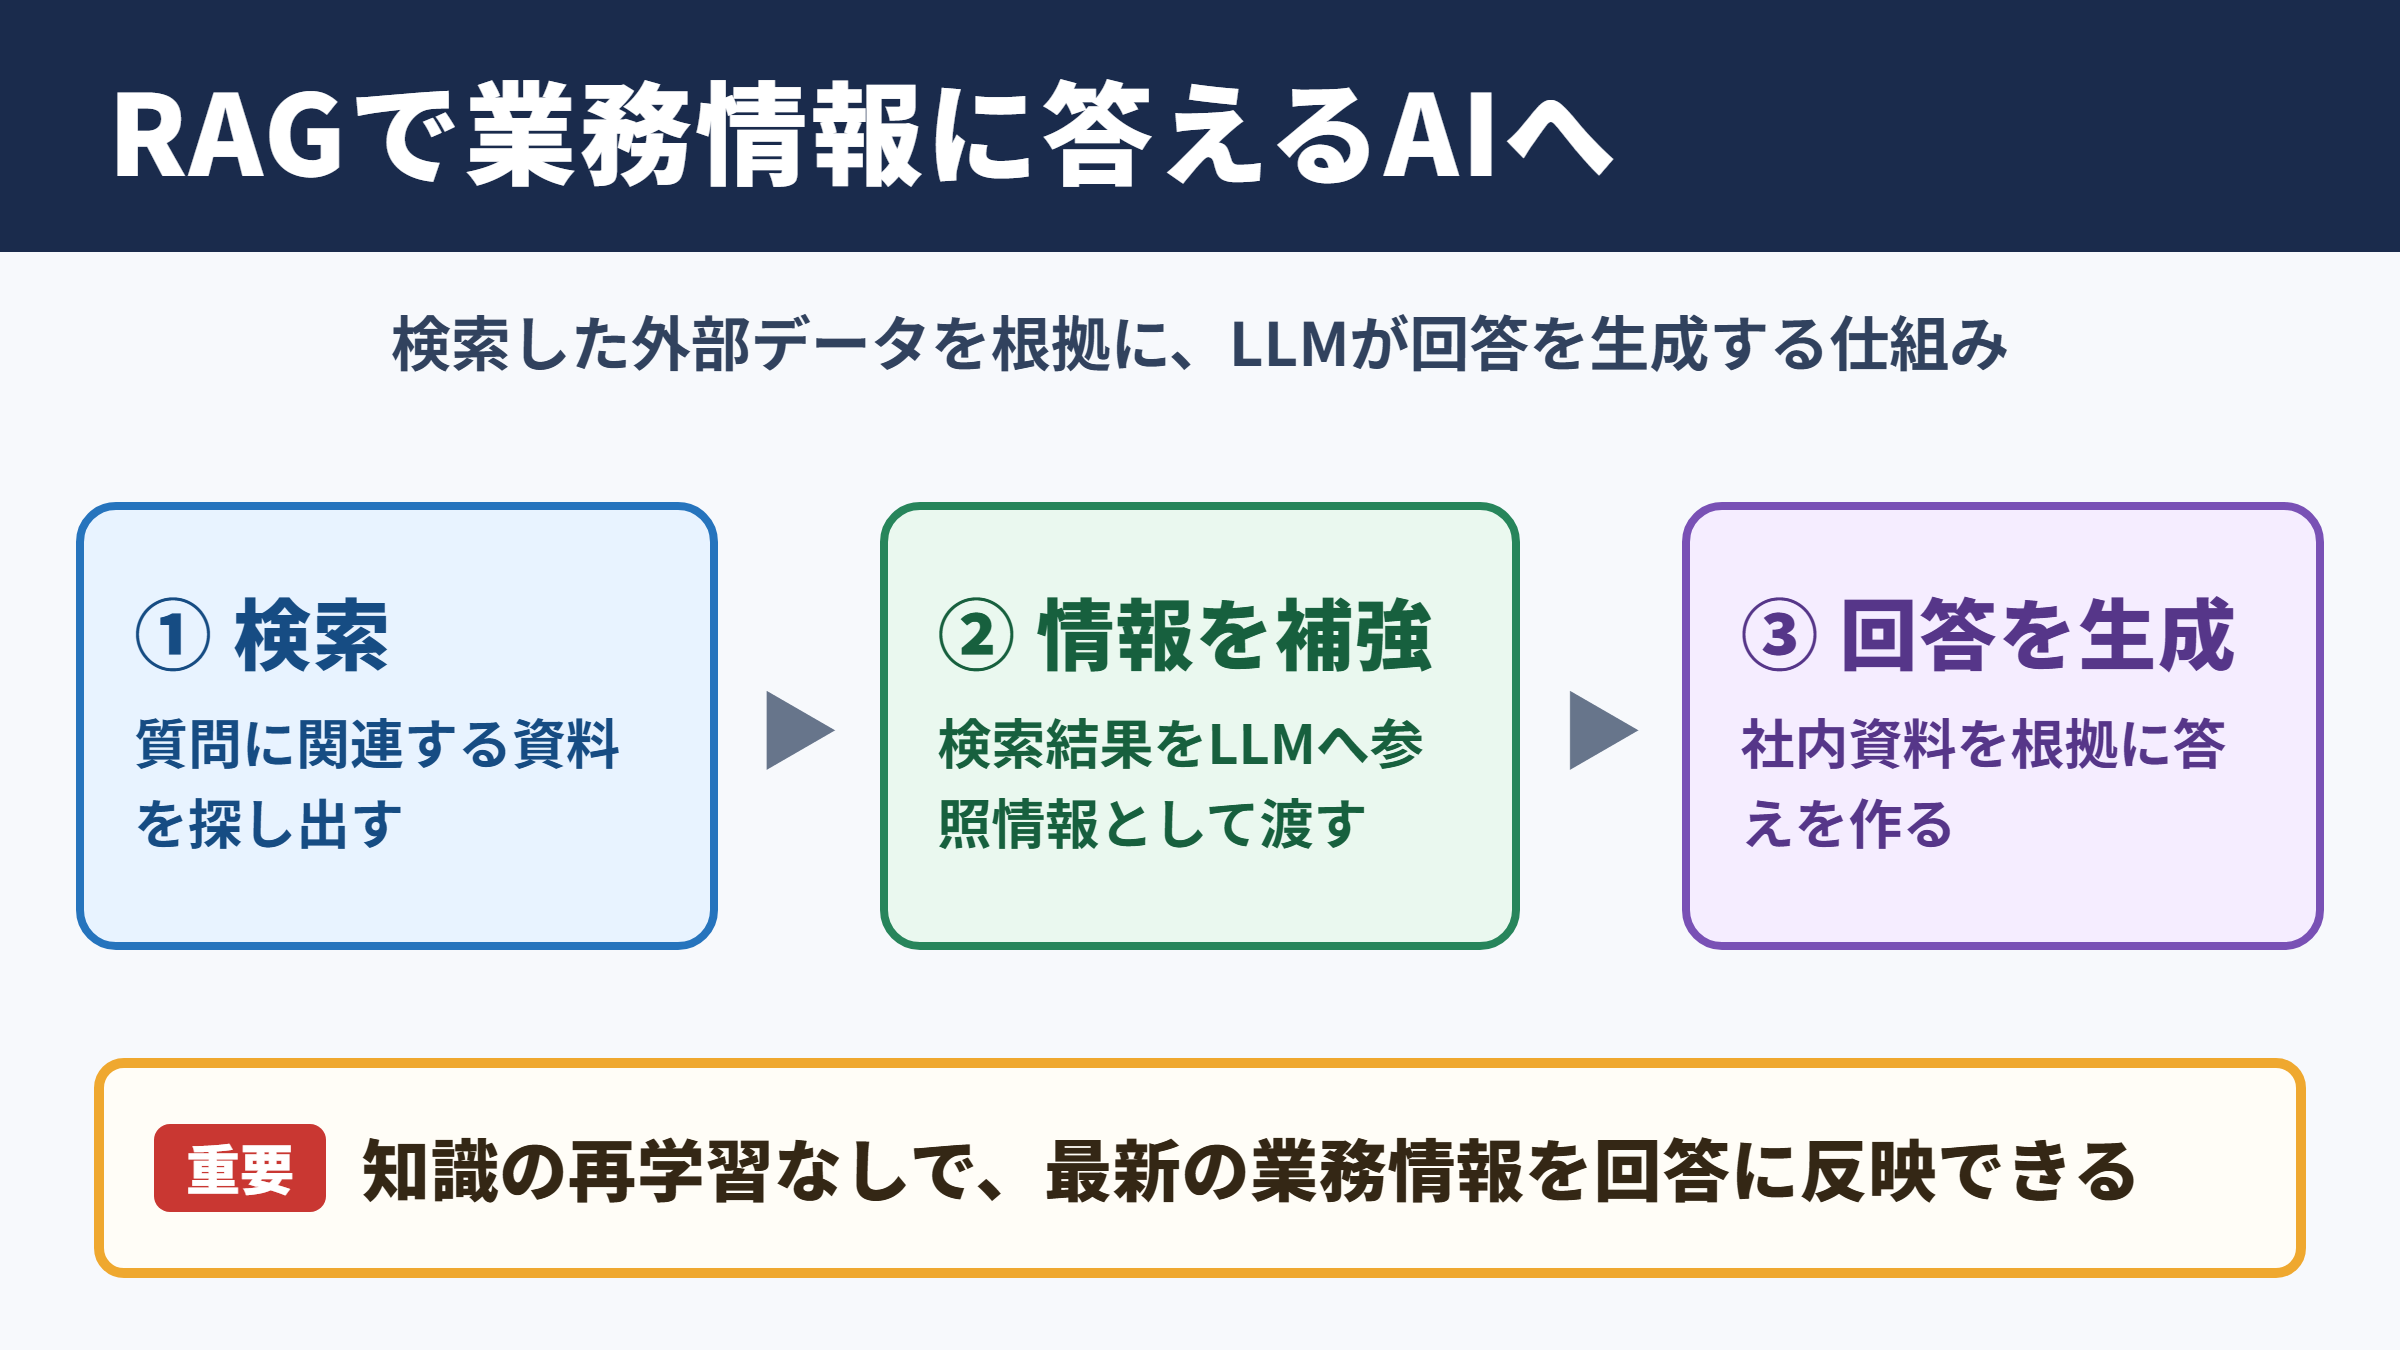
一方のRAGは、質問に関連する外部データを先に検索し、その検索結果を参照情報としてLLMへ渡してから回答を生成します。
つまり、LLMに知識を追加学習させなくても、必要な資料を読ませながら答えさせる考え方です。
RAGの重要な役割は、LLMを単なる会話相手ではなく、社内や業務の情報を根拠に答えるAIへ近づける点にあります。
たとえば就業規則について質問された場合、RAGは関連する規程の該当箇所を検索し、その内容を踏まえた回答を作成します。
回答の根拠となった資料名や参照箇所を表示する設計にすれば、利用者が内容を確認しやすくなるでしょう。
LLM単体との違い
LLM単体とRAGの違いは、回答時に外部情報を参照するかどうかにあります。
LLMは文章の流れを理解し、自然な回答を作る能力に優れています。
ただし、社内だけで使われるルール、頻繁に変わる価格、最新の製品仕様などを正確に知っているとは限りません。
RAGでは、回答の直前に最新データを検索するため、変化しやすい情報を扱いやすくなります。
モデルそのものを再学習するファインチューニングとは、目的も運用方法も異なります。
| 比較項目 | LLM単体 | RAG |
|---|---|---|
| 主な知識源 | 事前学習データと入力文 | 事前学習データと検索対象データ |
| 最新情報への対応 | 入力で補う必要がある | 検索データの更新で対応しやすい |
| 社内文書の利用 | 長文入力に依存しやすい | 質問に合う箇所を選択しやすい |
| 根拠の提示 | 設計しなければ難しい | 参照文書を示す設計にしやすい |
| 主な注意点 | 幻覚や情報不足 | 検索品質とデータ整備 |
精度向上につながる理由
RAGが精度向上に役立つ理由は、回答に必要な事実をプロンプトへ補えるからです。
LLMは情報が不足したまま質問されると、文脈から自然に見える内容を補完しようとします。
このとき、事実と異なる回答が生じることがあり、一般にハルシネーションと呼ばれます。
RAGによって信頼できる文書の抜粋を渡せば、推測だけに頼らない回答を作りやすくなります。
ただし、RAGを導入すれば自動的に正確になるわけではありません。
検索結果が質問に合っていなければ、LLMも誤った前提で回答する可能性があります。
RAGの流れは、質問を受け取る、関連資料を検索する、検索結果をLLMへ渡す、根拠を踏まえて回答を生成する、という順序です。
RAGを構成する検索と生成の仕組み
続いてはRAGがどのように情報を探し、回答を作るのかを確認していきます。
データの収集と分割
RAGの出発点は、検索対象にするデータの収集です。
社内規程、マニュアル、議事録、FAQ、製品カタログ、契約書、過去の問い合わせ履歴などが対象になります。
長い文書をそのまま登録すると検索精度が下がりやすいため、通常は意味のまとまりごとに小さく分割します。
この分割単位はチャンクと呼ばれます。
見出し、段落、表の単位、前後の文脈を考慮してチャンクを作ることが、検索品質の土台になります。
ベクトル検索と関連性判定
RAGでは文章を数値の並びに変換し、意味の近さを比較するベクトル検索がよく使われます。
質問と文書が完全に同じ単語を含まなくても、意味が近ければ候補として見つけやすい点が特徴です。
たとえば休暇申請という質問に対して、有給休暇の取得手続きという文書を候補にできる可能性があります。
キーワード検索とベクトル検索を組み合わせるハイブリッド検索も有効です。
製品番号や部署名のように表記一致が重要な情報では、キーワード検索が力を発揮します。
検索の関連度は、質問ベクトルと文書ベクトルの近さで判定します。
実務では検索上位の数件だけをLLMへ渡し、不要な情報を減らす設計がよく採用されます。
プロンプトへの情報付与
検索したチャンクは、質問とともにLLMへ入力されます。
このとき、参照情報だけに基づいて回答すること、不明な場合は不明と答えること、資料名を示すことなどを指示できます。
単に資料を大量に渡すのではなく、必要な根拠を絞って渡すことが重要です。
情報量が多すぎると、重要な記述が埋もれたり、回答が長くなりすぎたりする場合があります。
質問の分類、検索結果の再順位付け、回答後の根拠チェックまで含めると、より実用的なRAGシステムになります。
LLMとRAGとファインチューニングの関係
続いてはLLMとRAG、ファインチューニングの役割分担を確認していきます。
LLMが担う文章理解と回答生成
LLMは、大量の文章パターンを学習した生成AIモデルです。
質問の意図を読み取り、要点を整理し、自然な説明文として返す部分を担います。
RAGにおいても、最終的に回答を表現する中心はLLMです。
検索結果が箇条書きや専門用語中心の文書であっても、利用者に合わせて説明を整えられることが大きな利点でしょう。
ただし、LLMの言語能力と、社内情報の正しさは別の問題として考える必要があります。
RAGが向いている情報
RAGは、更新頻度が高い情報、文書量が多い情報、回答の根拠を残したい情報に向いています。
たとえば人事制度、販売条件、技術マニュアル、法令改定の社内通知、プロジェクト資料などが代表例です。
検索対象を更新すれば回答に反映しやすいため、モデルを作り直す負担を抑えられます。
知識を更新する仕組みとしてRAGを使うと考えると、用途を判断しやすくなります。
ファインチューニングが向いている情報
ファインチューニングは、特定の書き方、分類方法、応答形式、専門的な表現をモデルに覚えさせたいときに検討されます。
たとえば問い合わせ内容を決まったカテゴリへ振り分ける、企業独自の文章トーンで定型文を作る、といった用途です。
一方で、頻繁に更新される規程本文を学習させる目的には、RAGのほうが管理しやすい場合があります。
実際にはRAGとファインチューニングを組み合わせ、知識は検索で補い、回答形式は調整済みのモデルで整える構成もあります。
RAGは知識を参照する仕組み、ファインチューニングは振る舞いや表現を調整する方法です。
両者を同じものとして扱わず、解決したい課題から選ぶことが大切です。
ビジネスにおけるRAGの活用例
続いては業務のなかでRAGを活用する具体例を確認していきます。
社内問い合わせ対応
人事、総務、情報システム部門には、制度や手続きに関する同じような質問が繰り返し届きます。
RAGを使った社内チャットボットなら、就業規則、経費精算マニュアル、申請手順を検索して回答できます。
担当者は単純な問い合わせへの対応時間を減らし、例外対応や制度改善に時間を使いやすくなります。
回答の末尾に関連規程へのリンクや文書名を添えれば、利用者自身で確認する行動も促せます。
カスタマーサポートの支援
顧客対応では、製品仕様、障害情報、返金条件、操作手順を正確に案内する必要があります。
オペレーター向けのRAGでは、会話内容から関連FAQや最新マニュアルを検索し、回答案を提示できます。
顧客へ自動回答する前に人が確認する運用にすれば、回答速度と品質管理の両立を目指せます。
問い合わせ履歴を分析し、FAQに不足する項目を見つける用途にも広げられるでしょう。
営業と企画の情報活用
営業担当者は、提案資料、導入事例、価格表、競合比較、過去の商談記録などを横断して確認する機会があります。
RAGを使えば、顧客の業界や課題に応じて、関連する資料の候補を短時間で集められます。
企画部門では、市場調査の社内レポートや会議録から論点を探し、意思決定の準備を進めることも可能です。
ただし、営業秘密や個人情報を含む資料は権限に応じて検索範囲を制御しなければなりません。
| 活用部門 | 主な検索データ | 期待できる効果 |
|---|---|---|
| 人事総務 | 規程、申請手順、社内FAQ | 問い合わせ負荷の軽減 |
| 顧客対応 | 製品資料、障害情報、対応履歴 | 案内の迅速化と品質安定 |
| 営業 | 提案書、事例、価格情報 | 提案準備の短縮 |
| 開発 | 仕様書、設計書、過去チケット | 調査時間の削減 |
| 法務 | 契約ひな形、社内ルール、判例メモ | 確認作業の支援 |
RAG導入で確認したい精度と安全性
続いてはRAGを業務へ導入する前に押さえたい精度と安全性を確認していきます。
データ品質と更新管理
RAGの回答品質は、登録するデータの品質に大きく左右されます。
古いマニュアルと新しいマニュアルが混在していると、誤った案内につながるおそれがあります。
公開日、改定日、文書の管理者、利用対象、失効状態を整理し、正しい文書を検索できるようにします。
検索対象の棚卸しは、導入後も継続したい重要な運用です。
検索精度の評価方法
精度を確認するときは、実際に想定される質問を集め、必要な資料が検索上位に出るかを評価します。
回答文だけを見て判断するのではなく、検索、根拠、生成結果を分けて確認することがポイントです。
質問の言い換え、曖昧な質問、複数の条件を含む質問、答えが存在しない質問もテストに含めます。
答えがない場合に無理に生成せず、担当部署や確認方法を案内できるかも大切な評価項目です。
評価用の質問例として、最新の申請期限はいつか、特定条件で利用できる制度はあるか、該当規程がない場合はどう案内するか、という観点を用意します。
権限管理と情報漏えい対策
RAGでは、検索できること自体が情報アクセスにつながります。
そのため、文書ごとの閲覧権限と、質問した利用者の権限を照合する仕組みが必要です。
機密資料を一律に登録するのではなく、利用目的、保存先、ログ、削除方針を決めてから運用を始めます。
外部の生成AIサービスを使う場合は、入力データの保存や学習利用に関する条件も確認しましょう。
RAGの安全性は、AIモデルだけで決まりません。
データの公開範囲、アクセス権、更新手順、利用ログを含めた運用設計が欠かせません。
RAGの意味と活用ポイントのまとめ
RAGは検索拡張生成を意味し、質問に関連する外部データを検索してからLLMに回答させる仕組みです。
社内文書や最新情報を根拠にできるため、業務で使える生成AIを目指すうえで有力な選択肢になります。
特に社内問い合わせ、カスタマーサポート、営業支援、技術文書の検索といった場面で活用しやすいでしょう。
ただし、検索対象の文書が古い、分割方法が適切でない、権限管理が不足していると、期待した効果は得られません。
まずは対象業務を絞り、利用者が実際にする質問を基に検索精度を検証することが重要です。
LLMの文章生成能力とRAGの情報検索能力を組み合わせれば、正確性、説明性、業務効率の向上につながります。