システム開発やWebアプリケーションの設計では、シリアライズとデシリアライズという言葉が頻繁に登場します。
どちらもデータ変換に関わる処理ですが、変換の向きや利用目的は正反対です。
オブジェクトを保存したい場面、ネットワーク経由で送信したい場面、APIから受け取ったJSONをプログラムで扱いたい場面などで、両者の理解が役立ちます。
この記事では、意味の違いから内部の仕組み、バイナリ形式とテキスト形式の特徴、実装時の注意点までを順に解説します。
シリアライズとデシリアライズの違い
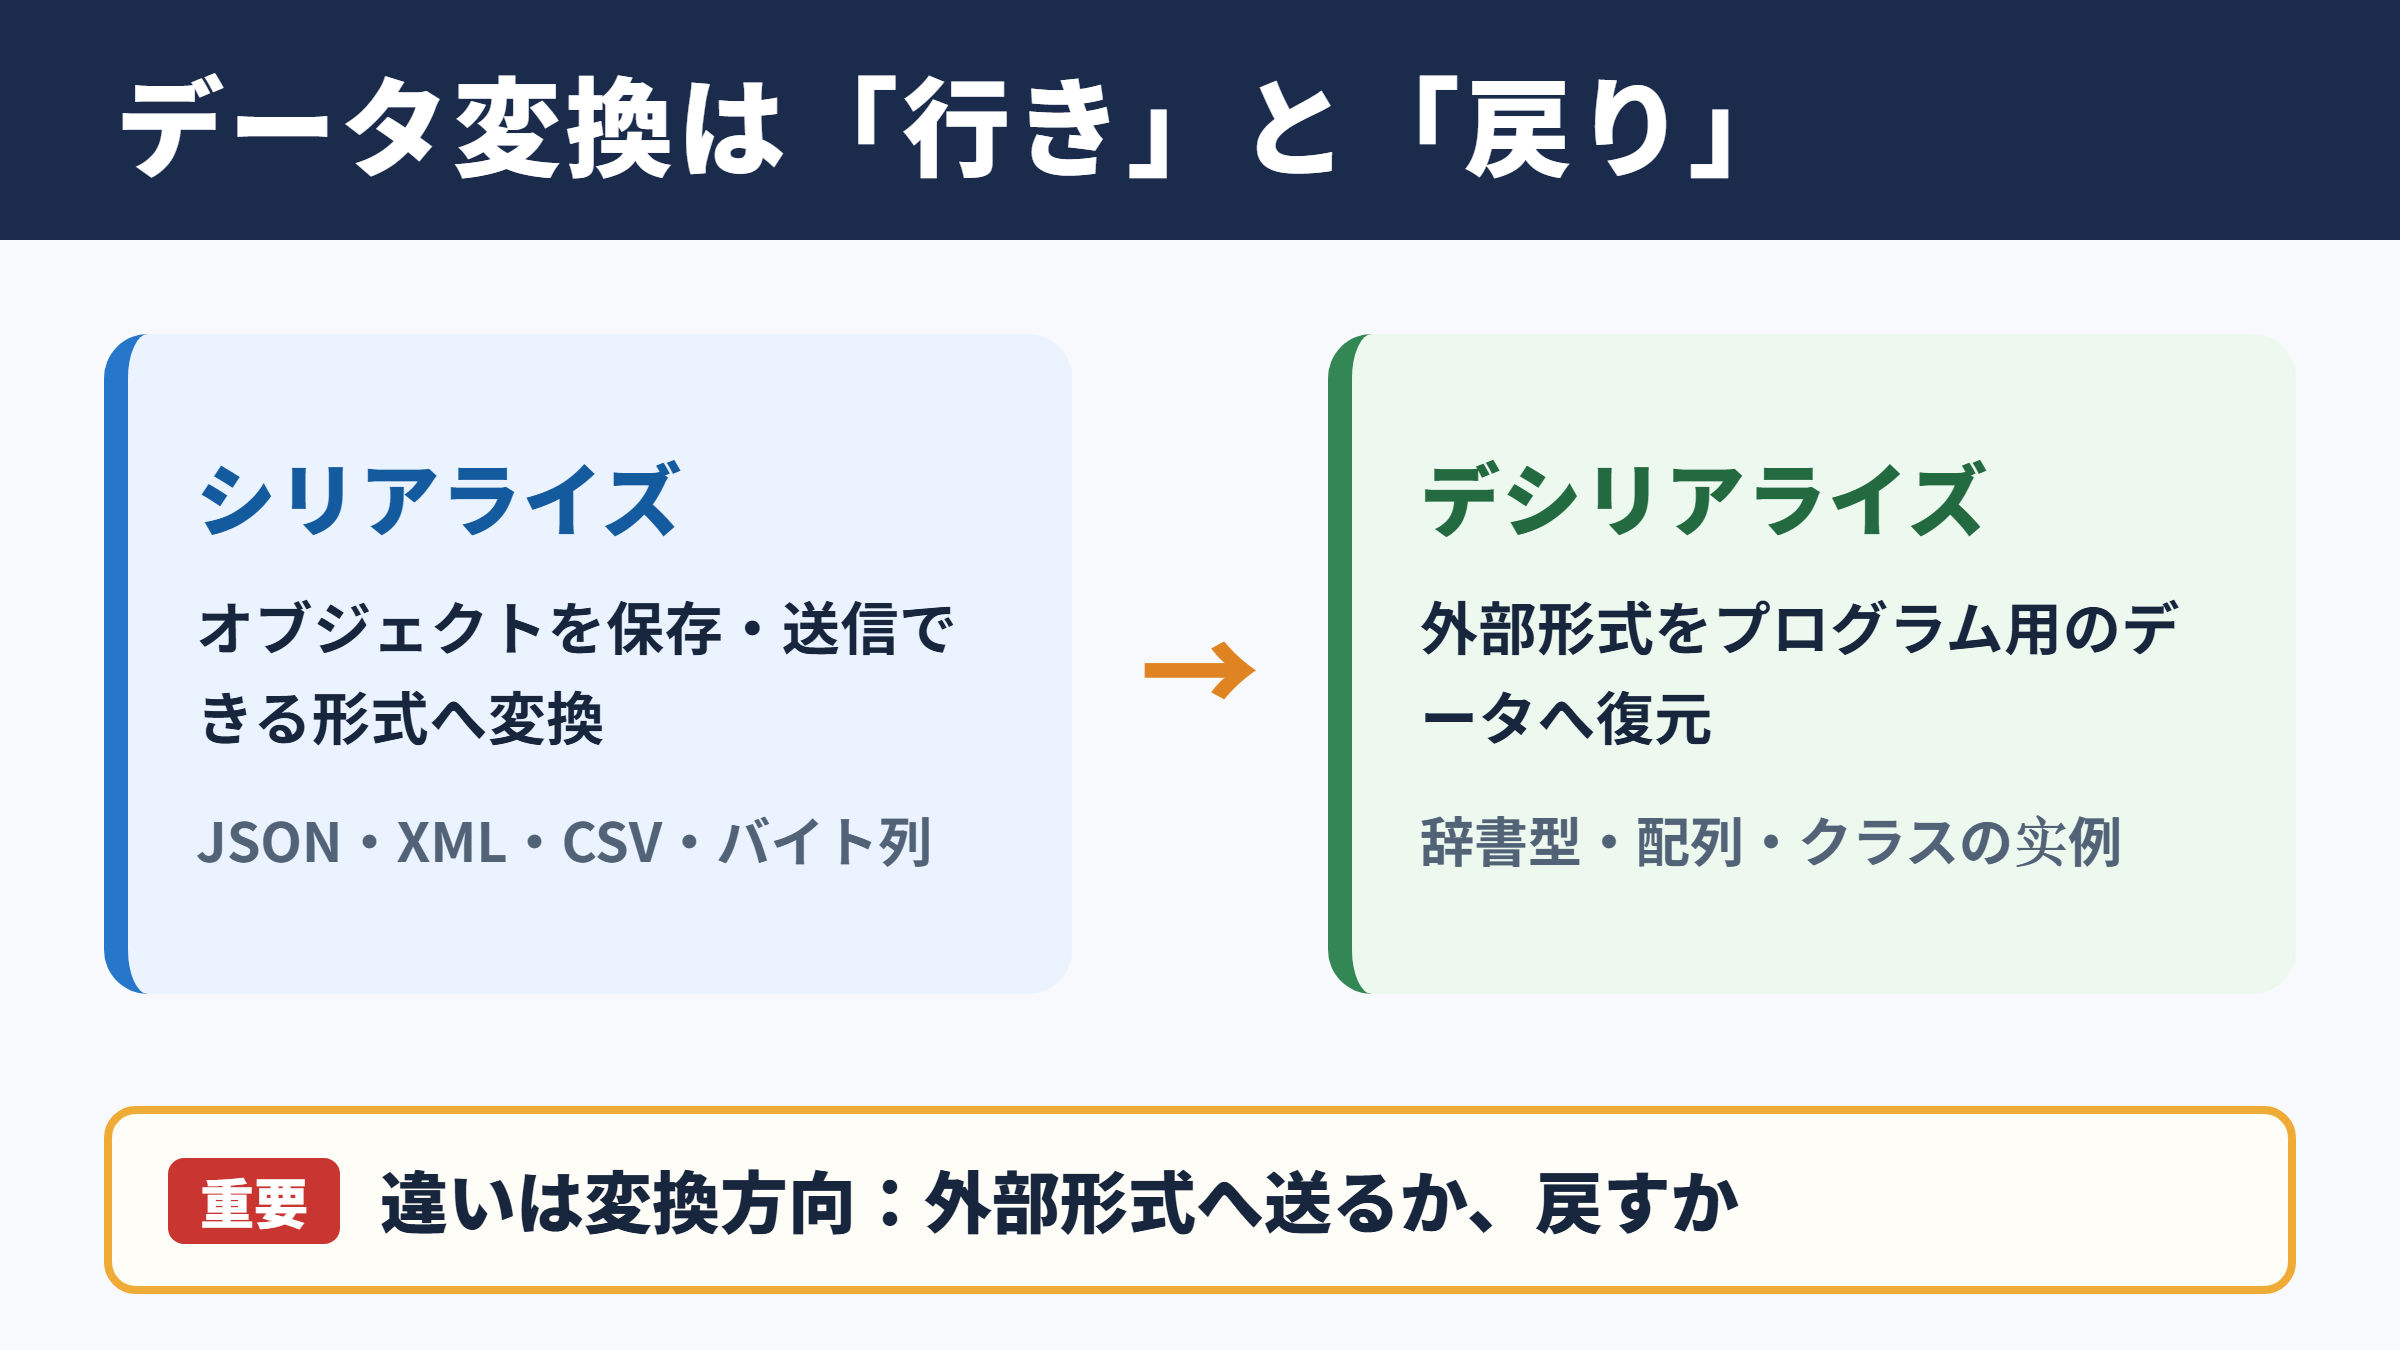
それではまずシリアライズとデシリアライズの違いについて解説していきます。
シリアライズの意味
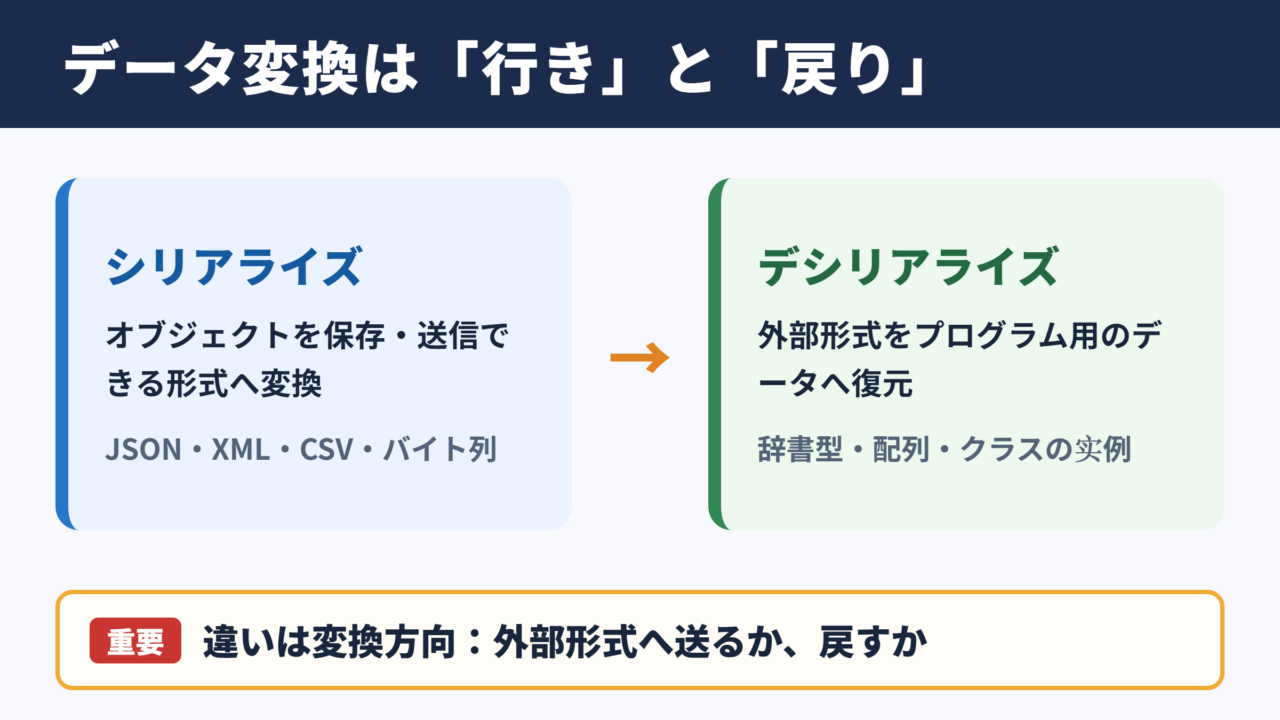
シリアライズとは、メモリ上に存在するオブジェクトやデータ構造を、保存や送信が可能な形式へ変換する処理です。
日本語では直列化と表現される場合もあります。
プログラム内のオブジェクトは、クラス、プロパティ、参照関係などを持つ複雑な構造です。
そのままではファイルに書き込んだり、HTTP通信で別のサーバーへ送ったりできません。
そこで、データをJSON、XML、CSV、独自のバイナリ形式などに変換します。
この変換処理がシリアライズです。
たとえば氏名、年齢、会員番号を持つユーザーオブジェクトを、JSON形式の文字列へ変換する処理がシリアライズにあたります。
変換後のデータは、一定のルールに従って並べられた文字列またはバイト列になります。
そのため、異なるプログラミング言語や異なる環境でも、同じ形式を理解できればデータ交換が可能です。
デシリアライズの意味
デシリアライズとは、シリアライズ済みの文字列やバイト列を読み取り、プログラムで扱えるオブジェクトやデータ構造へ復元する処理です。
復元、逆直列化、非直列化などと呼ばれることもあります。
たとえばWeb APIからJSON形式のレスポンスを受信しただけでは、アプリケーションの処理に直接利用しにくい場合があります。
JSONを辞書型、配列、クラスのインスタンスなどへ変換してはじめて、各項目を参照したり計算に使ったりできます。
この読み取りと復元がデシリアライズです。
シリアライズが荷物を梱包して発送できる状態にする作業なら、デシリアライズは受け取った荷物を開封し、使いやすい場所へ整理する作業に近いでしょう。
変換方向と目的
両者の最大の違いは、データ変換の方向です。
シリアライズはオブジェクトから外部形式へ、デシリアライズは外部形式からオブジェクトへ向かいます。
| 処理 | 変換前 | 変換後 | 主な目的 |
|---|---|---|---|
| シリアライズ | オブジェクト、配列、辞書 | JSON、XML、バイト列 | 保存、送信、キャッシュ |
| デシリアライズ | JSON、XML、バイト列 | オブジェクト、配列、辞書 | 読込、復元、処理 |
データを外へ出すならシリアライズ、外部から届いたデータをアプリケーション内で使うならデシリアライズと考えると整理しやすくなります。
ただし、変換後のデータが完全に元の状態へ戻るとは限りません。
関数、接続情報、一時的なキャッシュ、実行中の処理状態などは、通常のデータ形式へ含められないことがあります。
シリアライズとデシリアライズは対になる処理ですが、単純な完全コピーではありません。
どの項目を変換対象にし、どの項目を除外するかを設計段階で決めることが重要です。
データ変換の仕組み
続いてはデータ変換の仕組みを確認していきます。
オブジェクト構造の取り出し
シリアライザは、指定されたオブジェクトの中から変換対象となる値を取り出します。
代表的な対象は、文字列、数値、真偽値、日付、配列、入れ子になったオブジェクトです。
クラスのプロパティを順番に調べ、形式のルールに合わせて出力します。
JSONではキーと値の組み合わせが利用され、XMLではタグの階層で構造を表します。
このとき、公開対象ではない情報まで含めると、情報漏えいにつながる可能性があります。
パスワード、アクセストークン、内部管理用フラグなどは、変換対象から明示的に外す設計が必要です。
形式に沿ったデータ表現
シリアライズされたデータは、機械が読めるだけでなく、人が確認しやすい形式になる場合もあります。
JSONは波かっこと角かっこを使い、オブジェクトと配列の構造を表現するため、API通信で広く利用されています。
XMLはタグによる階層構造が明確で、古くから業務システムや設定ファイルで使われてきました。
CSVは表形式のデータに向いていますが、複雑な入れ子構造や型情報の表現には不向きです。
ユーザー情報をJSONへ変換した場合、名前は文字列、年齢は数値、購入履歴は配列として、それぞれの型を意識した形で出力されます。
日付を文字列へ変換する際は、タイムゾーンや書式を統一しておくと、受信側での解釈違いを防げます。
データ形式の選択は、可読性、通信量、処理速度、他システムとの互換性を見ながら決めるのが一般的です。
復元時の型判定
デシリアライズでは、入力データを読み取り、各値を適切な型として扱える状態へ変換します。
数字に見える文字列を数値として扱うのか、日付文字列を日付型へ変換するのかは、利用するライブラリや設定によって異なります。
JSONでは文字列と数値の区別はできますが、言語固有のクラス情報までは通常含まれません。
そのため、受信側でどのクラスへ割り当てるかを指定することがあります。
型の不一致が起きると、変換エラーや想定外の動作につながります。
特に整数、小数、null、真偽値、日時は、不具合が起きやすい項目です。
外部データを受け取る際は、デシリアライズ後にも必ず値の検証を行うべきでしょう。
バイナリ形式とテキスト形式
続いてはバイナリ形式とテキスト形式の特徴を確認していきます。
テキスト形式の特徴
テキスト形式は、人間が目で読んで内容を確認しやすいデータ形式です。
JSON、XML、YAML、CSVなどが代表例です。
開発中にログへ出力したり、通信内容を調査したりするとき、テキスト形式は大きな助けになります。
外部サービスとの連携でも採用例が多く、仕様書と照らし合わせながら問題を調べやすい点が魅力です。
JSONは軽量で扱いやすく、Web APIの標準的な形式として定着しています。
ただし、キー名や記号も含まれるため、同じ情報量ならバイナリ形式よりサイズが大きくなる場合があります。
バイナリ形式の特徴
バイナリ形式は、データをバイト単位で効率よく表現する形式です。
Protocol Buffers、MessagePack、Avro、独自フォーマットなどが知られています。
文字列として読むことは難しい一方、通信量を減らし、高速な処理を期待できる場合があります。
大量のイベントデータ、ゲーム通信、IoT機器との連携、低遅延が求められるサービスなどで選ばれやすい形式です。
一方で、内容を確認するには専用ツールやスキーマ情報が必要になることがあります。
運用や障害調査を考えると、性能だけではなく保守のしやすさも判断材料になります。
形式選定の判断基準
形式を選ぶ際は、データ量が多いから必ずバイナリ形式にする、という考え方では不十分です。
開発チームの技術力、外部連携先の仕様、将来の拡張、デバッグ頻度なども確認する必要があります。
| 比較項目 | テキスト形式 | バイナリ形式 |
|---|---|---|
| 人間による確認 | しやすい | 専用ツールが必要になりやすい |
| 通信量 | 大きくなりやすい | 小さくしやすい |
| デバッグ | 比較的容易 | スキーマ確認が必要 |
| 互換性 | 広く利用されやすい | 採用形式に依存する |
| 処理速度 | 用途によって十分 | 高速化できる場合がある |
一般的なWeb APIや管理画面の連携では、まずJSONが有力な選択肢になります。
高頻度の通信や大規模なデータ処理では、バイナリ形式を検討すると効果を得られるでしょう。
JSONとオブジェクトの関係
続いてはJSONとオブジェクトの関係を確認していきます。
JSONが扱いやすい理由
JSONはJavaScript Object Notationの略称で、オブジェクトのような構造を文字列として表現できるデータ形式です。
JavaScriptとの親和性が高い名称ですが、Java、Python、PHP、C#、Rubyなど、多くの言語で利用されています。
キーと値の組み合わせ、配列、入れ子構造を自然に表現できるため、商品情報、ユーザー情報、注文情報などをまとめて送信できます。
また、HTTP通信で扱いやすく、ブラウザとサーバーのやり取りにも適しています。
可読性と汎用性のバランスがよく、異なるシステム間の共通言語のような役割を果たしています。
オブジェクトへの変換手順
JSONを受信した後は、パーサーやライブラリを利用してデシリアライズします。
変換結果は、言語によって連想配列、辞書、マップ、オブジェクトなどになります。
必要に応じて、さらに業務用のクラスやデータモデルへ詰め替えることもあります。
注文データを受け取った場合、注文番号、購入者、配送先、明細、合計金額を読み取り、注文クラスとして管理する流れが考えられます。
明細が複数あるなら配列として復元し、各要素を商品明細クラスへ変換する設計も可能です。
この段階で、必須項目が存在するか、数値が正しい範囲にあるか、文字数が制限を超えていないかを確認します。
変換成功と入力データの安全性は別の問題であるため、検証処理を省略しないことが大切です。
nullと省略項目の扱い
JSONでは、項目が存在しない状態と、項目が存在して値がnullである状態を区別できます。
この違いを曖昧にすると、更新処理で意図しない上書きが発生することがあります。
たとえばプロフィール更新APIで、電話番号という項目が送られていない場合は変更しない、nullの場合は削除する、といったルールが必要になるケースがあります。
空文字、0、falseも有効な値として扱う必要があります。
単純に値があるかどうかだけで判定すると、0件やfalseの設定を誤って無視するおそれがあります。
項目の有無と値の内容を分けて設計することが、安定したデシリアライズにつながります。
実装時の注意点
続いては実装時の注意点を確認していきます。
セキュリティ上のリスク
デシリアライズは、外部から届いたデータをプログラム内の構造へ変換する処理です。
信頼できない入力をそのまま復元すると、予期しないクラスの生成や任意コード実行などの脆弱性につながることがあります。
特に言語やフレームワークによっては、危険なオブジェクトデシリアライズが問題になる場合があります。
受信データの形式が正しいかだけでなく、許可された項目だけを含むか、想定した型だけを扱うかを確認する必要があります。
外部入力は信頼しないという前提を置き、型情報を無条件に受け入れない設計が求められます。
デシリアライズ対象のクラスを限定し、スキーマ検証と入力値検証を組み合わせると、安全性を高められます。
シリアライズデータに署名や暗号化を加える場合も、鍵管理と検証手順まで含めて設計することが重要です。
バージョン変更への対応
アプリケーションを長期間運用すると、データ項目の追加、名称変更、削除が発生します。
古いアプリケーションが新しい形式を読めない、新しいアプリケーションが過去のデータを復元できない、といった問題も起こり得ます。
互換性を保つには、新しい項目を追加する際に既定値を用意したり、廃止予定の項目をすぐに削除せず段階的に移行したりする工夫が有効です。
バイナリ形式ではスキーマ管理が特に重要になります。
JSONでも、APIのバージョン管理や必須項目の設計を慎重に行う必要があります。
変更に強い形式とは、単に新しい項目を追加できる形式ではなく、古いデータを安全に扱える形式でもあります。
循環参照と容量増大
オブジェクト同士が互いを参照している循環参照は、シリアライズ時の代表的な問題です。
親オブジェクトが子オブジェクトを持ち、子オブジェクトが親オブジェクトを持つ構造では、変換処理が終わらなくなる可能性があります。
多くのライブラリには循環参照を検出する仕組みがありますが、例外になる場合やnullへ置き換わる場合もあります。
APIで返すデータには必要な項目だけを持つ専用のデータ転送用オブジェクトを用意すると、問題を避けやすくなります。
また、不要な関連データを大量に含めると、レスポンス容量が膨らみ、通信速度とサーバー負荷に影響します。
必要最小限のデータ構造を設計することが、性能面でも保守面でも有効でしょう。
シリアライズとデシリアライズのまとめ
シリアライズは、オブジェクトやデータ構造をJSON、XML、CSV、バイナリなどの外部形式へ変換する処理です。
一方のデシリアライズは、そのデータを読み込み、プログラム内で利用できるオブジェクトや配列へ復元する処理を指します。
データ保存、API通信、キャッシュ、メッセージキュー、設定ファイルの読込など、幅広い場面で両者は使われています。
テキスト形式は確認しやすく連携に向き、バイナリ形式は容量や速度で有利になる場合があります。
ただし、形式選びでは性能だけでなく、互換性、保守性、デバッグのしやすさも見逃せません。
とくに外部データをデシリアライズする際は、入力値検証、型の制限、不要な項目の除外を徹底することが重要です。
変換の向き、データ形式、セキュリティの3点を押さえれば、シリアライズとデシリアライズを実務で適切に使い分けやすくなるでしょう。