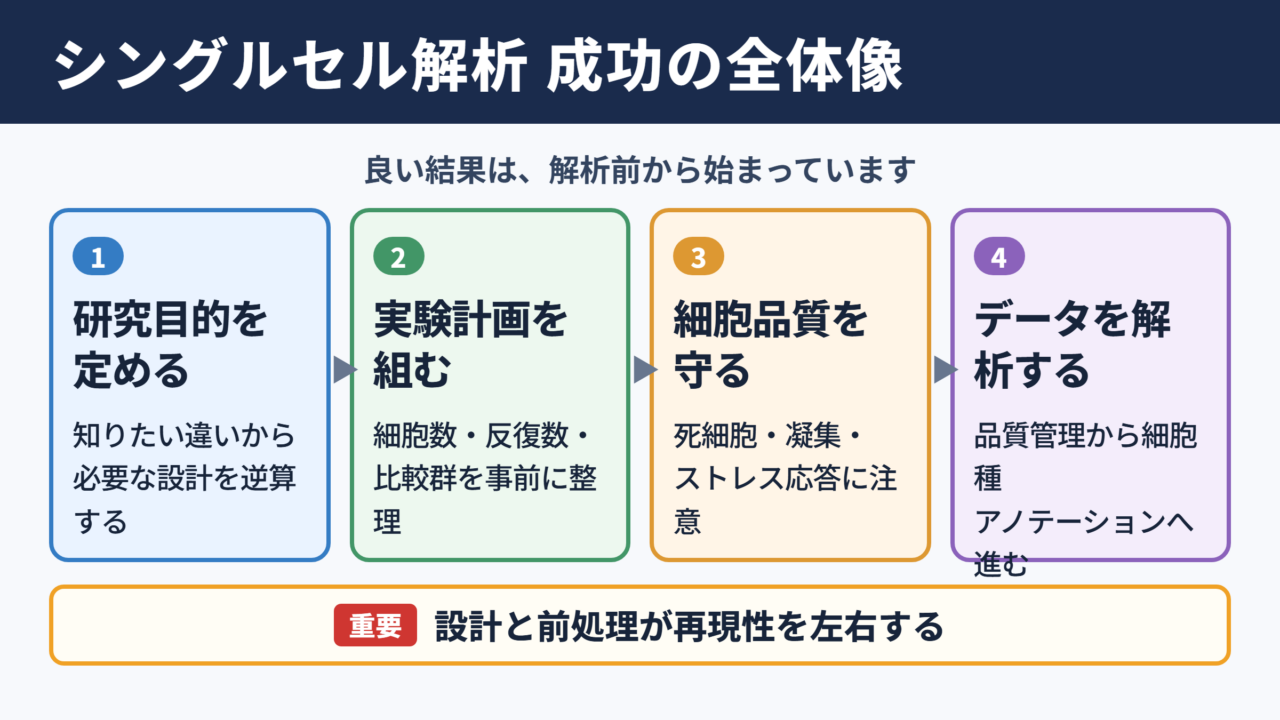
シングルセル解析は、組織や培養細胞を構成する細胞を一つずつ捉え、遺伝子発現や細胞集団の違いを調べる研究手法です。
従来のバルク解析では平均値に埋もれやすかった少数細胞や細胞状態の差を読み取れるため、がん研究、免疫研究、発生研究、創薬などで活用が広がっています。
一方で、サンプル調製からライブラリー作製、シーケンシング、品質管理、クラスタリング、可視化まで工程が連なり、どこか一つでも条件が合わないと結果の解釈が難しくなります。
本記事では、シングルセルRNAシーケンシングを中心に、実験計画からデータ解析までの流れと、各工程で確認したいポイントを分かりやすく解説します。
シングルセル解析の全体像
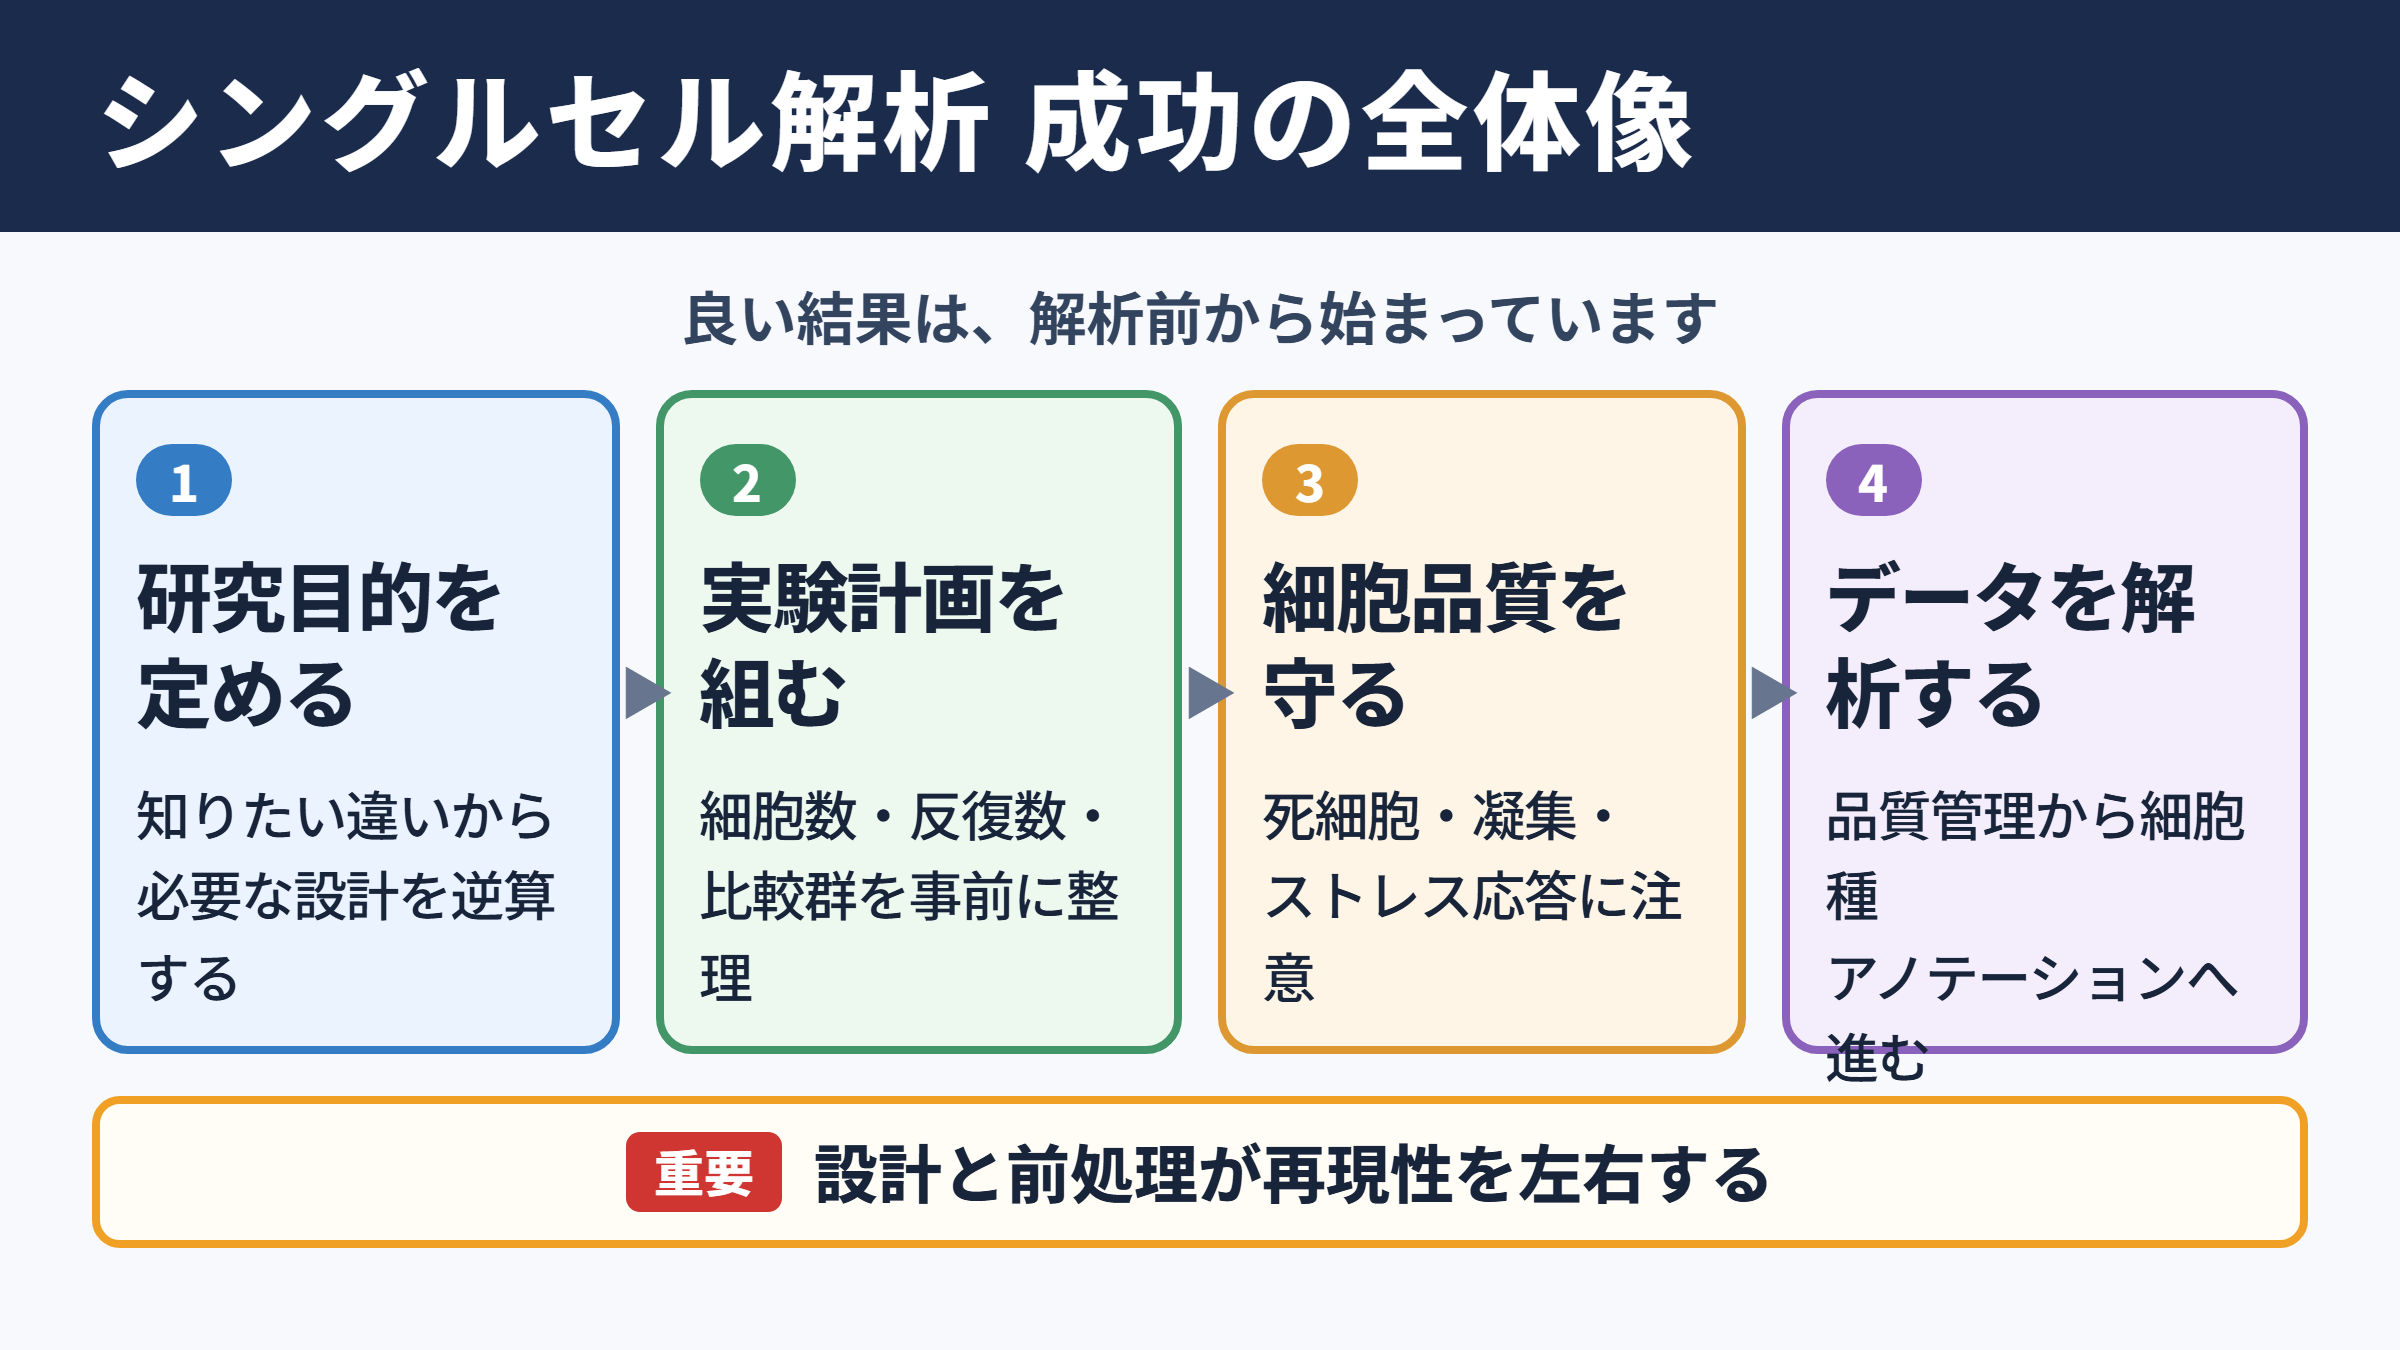
それではまずシングルセル解析の全体像について解説していきます。
結論からいえば、良い解析結果は解析ソフトの設定だけでは決まりません。
研究目的に合うサンプル設計と、細胞品質を保つ前処理が、後工程の再現性を大きく左右します。
研究目的から逆算する解析設計
最初に決めたいのは、何を明らかにしたいのかという研究目的です。
細胞種の構成比を知りたい場合と、刺激による遺伝子発現変化を比較したい場合では、必要な細胞数、サンプル数、シーケンス深度の考え方が変わります。
たとえば希少な免疫細胞を探索する目的なら、1細胞当たりの深さだけでなく、対象細胞を十分に含む総細胞数が重要になります。
一方で既知の細胞集団における発現差を詳しく見るなら、個体差を扱えるように生物学的反復を確保する設計が有効でしょう。
シングルセル解析では、細胞を多く読むことと、各細胞を深く読むことのバランスが重要です。
探索的な細胞種同定では細胞数を優先し、微妙な発現差の検出では十分なリード数と反復数を意識します。
実験群、対照群、採取時点、個体情報、処理条件を事前に表へ整理しておくと、後の統計解析やバッチ補正の判断もしやすくなります。
代表的なワークフロー
一般的なscRNA-seqでは、組織採取後に細胞懸濁液を作り、細胞を一細胞ずつ区画化してRNAにバーコードを付与します。
その後、cDNA合成、ライブラリー調製、次世代シーケンサーによる読み取りを行い、得られた配列データを細胞ごとの遺伝子発現マトリクスへ変換します。
解析段階では低品質細胞の除外、正規化、次元削減、クラスタリング、マーカー遺伝子の確認、細胞種アノテーション、可視化という順に進むことが多いです。
| 工程 | 主な目的 | 注意したい点 |
|---|---|---|
| 実験計画 | 比較群と必要細胞数の設定 | 個体差とバッチの混同 |
| サンプル調製 | 単細胞懸濁液の作製 | 細胞死、凝集、ストレス応答 |
| ライブラリー作製 | 細胞別バーコードの付与 | 細胞投入量と二重細胞 |
| シーケンシング | 遺伝子発現情報の取得 | リード数、インデックス設計 |
| データ解析 | 細胞集団と状態の抽出 | 品質管理と解釈の妥当性 |
手法選択とプラットフォームの違い
シングルセル解析には、液滴を利用して多数細胞を処理する方式、プレートに一細胞ずつ分注する方式、組織内の位置情報を保持する空間トランスクリプトミクスなどがあります。
液滴方式は数千から数万細胞を比較的効率よく扱いやすく、細胞集団の網羅的な探索に向きます。
プレート方式は一細胞当たりの情報量を得やすい場合がある一方、処理細胞数や作業負荷を見積もる必要があります。
細胞数、検出したい遺伝子数、予算、試料の鮮度、位置情報の必要性を並べて、手法を選ぶことが大切です。
サンプル調製と単細胞化
続いてはサンプル調製と単細胞化を確認していきます。
解析の出発点となる細胞懸濁液の状態は、得られるデータの品質に直結します。
組織採取から保存までの管理
組織を採取してから単細胞化を始めるまでの時間が長いと、細胞死やRNA分解が進み、ストレス関連遺伝子の発現が高くなることがあります。
可能であれば採取後すみやかに処理し、温度、培地、酸素条件を試料特性に合わせて管理します。
凍結試料や保存試料を扱う場合は、生細胞ではなく核を用いるsingle nucleus RNA-seqも選択肢になります。
核解析は壊れやすい組織や凍結組織に対応しやすい反面、細胞質RNAを含む全細胞解析とは検出傾向が異なるため、結果を同列に比較しすぎない配慮が必要です。
酵素処理と細胞懸濁液の作製
固形組織では、コラゲナーゼ、ディスパーゼ、トリプシンなどの酵素処理と、穏やかな機械的解離を組み合わせて細胞を分散させます。
適切な酵素や反応時間は組織によって異なり、処理が弱すぎると細胞塊が残り、強すぎると細胞表面分子の損傷や発現変動につながります。
細胞をばらす効率だけでなく、細胞本来の状態をどこまで保てるかを評価する視点が欠かせません。
単細胞化の確認例です。
顕微鏡で大きな凝集塊がないかを確認し、細胞数と生存率を測定します。
赤血球が多い試料では、必要に応じて赤血球除去を行い、目的細胞への影響も記録します。
フィルターを通す工程では、目的細胞のサイズに適したメッシュを選びます。
細胞が大きい組織で細かすぎるフィルターを使うと、特定の細胞種だけが失われる可能性もあります。
生存率と細胞濃度の評価
細胞数計測では、目標とする細胞回収数だけでなく、生細胞率、細胞濃度、細胞サイズのばらつきを確認します。
死細胞が多いと遊離RNAが増え、周囲の細胞に本来存在しない遺伝子シグナルが混入するアンビエントRNAの原因になり得ます。
細胞濃度が高すぎる場合には、一つの区画に複数細胞が入るダブレットの割合も上がります。
生存率が低い試料を無理に進めると、後で低品質細胞の除外が増え、貴重な細胞群の解釈まで難しくなることがあります。
試料ごとに生存率、回収細胞数、処理時間を記録し、解析時の判断材料として残しましょう。
ライブラリー作製とシーケンシング
続いてはライブラリー作製とシーケンシングを確認していきます。
この工程では、どのRNAがどの細胞に由来するのかを識別できる形で配列情報へ変換します。
細胞バーコードとUMIの役割
液滴型のシングルセルRNA解析では、細胞、試薬ビーズ、反応液を微小な液滴内に封入し、細胞由来RNAへ細胞バーコードを付与します。
同じ細胞に由来する配列は共通のバーコードを持つため、シーケンシング後に細胞単位で遺伝子発現を再構成できます。
さらにUMIと呼ばれる分子識別子を使うことで、PCR増幅によって増えた重複配列を補正し、元のRNA分子数に近いカウントを得られます。
細胞バーコードは細胞の識別、UMIはRNA分子の重複補正という役割分担で理解すると整理しやすいでしょう。
投入細胞数とダブレット対策
多くの細胞を一度に投入すれば回収数は増えますが、二つ以上の細胞が同じバーコードとして扱われるダブレットも増えやすくなります。
ダブレットでは、本来は同時に現れにくい細胞種マーカーが一つの細胞に共存して見えることがあります。
たとえばT細胞と上皮細胞の特徴が強く混ざるクラスターがあれば、新しい細胞集団と決めつける前にダブレットを疑う必要があります。
ダブレット率は一般に回収目標細胞数が増えるほど上がる傾向があります。
希少細胞の探索では回収数を増やす価値がありますが、解析時にはダブレット検出ツールとマーカー遺伝子の両方で確認します。
リード数とシーケンス設計
必要なシーケンス深度は、細胞種の探索、遺伝子発現の精密比較、免疫受容体解析など、目的によって変わります。
深く読めば必ず新しい細胞種が見つかるとは限らず、飽和度や検出遺伝子数を確認しながら配分を決めることが現実的です。
複数試料を同じランで読む場合は、インデックスの組み合わせ、サンプル間のリード配分、バッチの偏りも事前に確認します。
性別、採取日、処理者、装置ロットなどの情報は、後の品質評価で役立つ重要なメタデータです。
品質管理と発現マトリクス
続いては品質管理と発現マトリクスを確認していきます。
シーケンシング後の解析では、まず配列を細胞別、遺伝子別の数値に変換し、信頼できる細胞だけを残します。
FASTQからカウントデータへの変換
シーケンサーから得られるFASTQファイルには、塩基配列と品質情報が含まれています。
解析パイプラインでは、リードから細胞バーコードとUMIを読み取り、参照ゲノムまたは参照トランスクリプトームへアラインメントし、遺伝子ごとにカウントします。
最終的には、行が遺伝子、列が細胞、各要素がカウント値となる遺伝子発現マトリクスが作られます。
この行列に加え、細胞ごとの総UMI数、検出遺伝子数、ミトコンドリア由来リードの割合などを記録しておきます。
低品質細胞のフィルタリング
品質管理では、極端に遺伝子数が少ない細胞、UMI数が少ない細胞、ミトコンドリア遺伝子の割合が高い細胞などを候補として確認します。
ただし、すべての試料に同じ閾値を機械的に当てはめると、代謝特性の異なる細胞種を不適切に除外するおそれがあります。
閾値は一般論ではなく、サンプル分布と生物学的な特徴を見ながら決めることが重要です。
| 指標 | 確認する内容 | 解釈時の注意 |
|---|---|---|
| 検出遺伝子数 | 細胞内で検出された遺伝子の種類 | 低すぎると空液滴や低品質細胞の可能性 |
| 総UMI数 | 細胞ごとのRNA捕捉量の目安 | 高すぎる細胞はダブレットの候補 |
| ミトコンドリア割合 | 細胞ストレスや損傷の目安 | 組織や細胞種で自然な差がある |
| リボソーム遺伝子割合 | 転写状態の偏りの目安 | 単独の指標としては判断しない |
アンビエントRNAとバッチ効果
壊れた細胞から放出されたRNAが周囲に混ざると、本来は発現していない遺伝子が弱く検出される場合があります。
特定の強発現遺伝子が多くの細胞に薄く見えるときは、アンビエントRNAの影響を検討します。
また、採取日や試薬ロット、シーケンスランの差によって、同じ種類の細胞が別々に分かれて見えるバッチ効果も起こります。
バッチ補正は便利ですが、過剰に補正すると本来の群間差まで消える可能性があります。
補正前後の可視化を比較し、研究目的に沿った差が維持されているかを確認する姿勢が大切です。
正規化とクラスタリング
続いては正規化とクラスタリングを確認していきます。
細胞ごとのRNA量の違いを調整し、似た発現パターンを持つ細胞をまとめることで、細胞集団の構造を読み取ります。
正規化と特徴量の選択
細胞ごとに捕捉されるRNA量は異なるため、生のカウント値だけを比べると、RNA量が多い細胞の影響を強く受けます。
そこでライブラリーサイズを考慮した正規化を行い、細胞間で比較しやすい表現値へ変換します。
次に、細胞間の差をよく表す高変動遺伝子を選び、次元削減やクラスタリングの入力に使います。
概念的には、ある遺伝子のカウントを細胞内の総カウントで割り、一定の係数でスケーリングしてから対数変換する処理がよく用いられます。
ただし実際の手法は解析ツールによって異なるため、使用した正規化方法を記録しておくことが再現性につながります。
主成分分析と近傍グラフ
遺伝子数は非常に多いため、そのまま細胞同士の関係を捉えるのは困難です。
主成分分析では、多数の遺伝子情報を細胞間の主要な変動軸へ圧縮します。
その後、主成分空間で近い細胞同士を結んだ近傍グラフを作り、局所的に似た発現状態を持つ細胞群を見つけます。
クラスタリングは細胞名を自動で決める処理ではなく、発現が似た細胞を統計的に集める処理です。
したがって、クラスター番号だけで生物学的な意味を断定せず、マーカー遺伝子や実験条件と照らし合わせる必要があります。
解像度設定とクラスターの解釈
クラスタリングの解像度を高くすると細胞群は細かく分かれ、低くすると大まかな集団としてまとまります。
どの設定が正しいかは一つに決まるものではなく、組織の複雑さ、細胞数、研究目的に応じて判断します。
細かく分かれたクラスターが、技術的なばらつきなのか、実際に異なる細胞状態なのかを見極めることが重要です。
複数の解像度で結果を確認し、主要な細胞集団が安定して再現されるかを見ると、過剰な分割を避けやすくなります。
可視化と細胞種アノテーション
続いては可視化と細胞種アノテーションを確認していきます。
解析結果を研究上の意味へ結び付ける工程であり、図の見た目だけで結論を急がないことがポイントです。
UMAPとt-SNEによる可視化
UMAPやt-SNEは、多次元の遺伝子発現データを二次元または三次元に配置して、細胞間の近さを直感的に示す方法です。
近くに配置された細胞は発現パターンが似ている傾向がありますが、図上の距離やクラスター間の空白を物理的な距離のように解釈することはできません。
UMAP上で離れて見えるからといって、必ずしも生体内で明確に別系統とは限りません。
可視化は仮説を作るための入口であり、マーカー遺伝子、統計検定、追加実験で裏付けるという順序が大切です。
マーカー遺伝子による細胞種同定
各クラスターで高く発現する遺伝子を調べ、既知のマーカー遺伝子や公開データベースと照らし合わせて細胞種を推定します。
一つのマーカーだけに依存すると誤認しやすいため、複数の遺伝子、陰性マーカー、組織の背景知識を組み合わせます。
たとえば免疫細胞では、系統を示す遺伝子と活性化状態を示す遺伝子を分けて読むことで、細胞種と細胞状態を混同しにくくなります。
| 確認観点 | 考え方 | よくある注意点 |
|---|---|---|
| 陽性マーカー | 候補細胞種で期待される遺伝子 | 単一遺伝子だけで決めない |
| 陰性マーカー | 別系統で強く出る遺伝子 | 混在やダブレットを確認する |
| 状態マーカー | 増殖、炎症、低酸素などの変化 | 細胞種マーカーと分けて解釈する |
| 既報データ | 類似組織の参照アトラス | 種差、年齢差、疾患差に注意する |
差次的発現解析と結果の提示
群間比較では、特定の細胞種に絞って差次的発現解析を行うと、細胞組成の違いと細胞内の変化を分けて考えやすくなります。
細胞を独立した生物学的反復として扱いすぎると、有意差が過大に見える擬似反復の問題が生じることがあります。
個体単位の情報を保った集約解析や、適切な統計モデルの採用も検討しましょう。
結果の提示では、UMAP、ドットプロット、バイオリンプロット、ヒートマップを目的に応じて使い分けます。
図には解析対象の細胞数、フィルタリング条件、正規化方法、クラスター設定を併記すると、読み手が判断しやすくなります。
見栄えのよい図よりも、解析条件が追跡できる図が、研究成果の信頼性を高めます。
シングルセル解析のまとめ
シングルセル解析は、サンプル調製、単細胞化、バーコード付与、ライブラリー作製、シーケンシング、品質管理、正規化、クラスタリング、可視化という流れで進みます。
最初の実験設計で研究目的と必要な細胞数を明確にし、試料の鮮度や生存率を保つことが、高品質なデータ取得の土台になります。
データ解析では、低品質細胞、ダブレット、アンビエントRNA、バッチ効果を確認したうえで、細胞集団と発現変化を慎重に解釈することが重要です。
クラスタリングやUMAPは結論そのものではなく、細胞の違いを発見するための手段として活用しましょう。
マーカー遺伝子、既存知見、個体ごとの再現性、必要に応じた組織染色や追加実験を組み合わせれば、シングルセル解析は複雑な生体組織を理解する強力な方法になります。