Sparkの意味をわかりやすく!ビジネスでの仕組み・使い方・関連用語との違いも(IT・開発・特徴・メリット・注意点など)
ITや開発の会話でSparkという言葉を見かけても、何を指すのか迷うことがあるでしょう。
Sparkには火花という一般的な意味がある一方、ビジネスやデータ分析の現場では、大量データを高速処理するための技術として使われる場面が多くあります。
ただし、製品名やサービス名としてSparkが使われる例も多いため、会話の前後を見て意味を判断することが大切です。
この記事ではIT分野のApache Sparkを中心に、仕組み、使い方、関連用語との違い、導入時の注意点をわかりやすく解説します。
Sparkの意味とビジネスにおける位置づけ
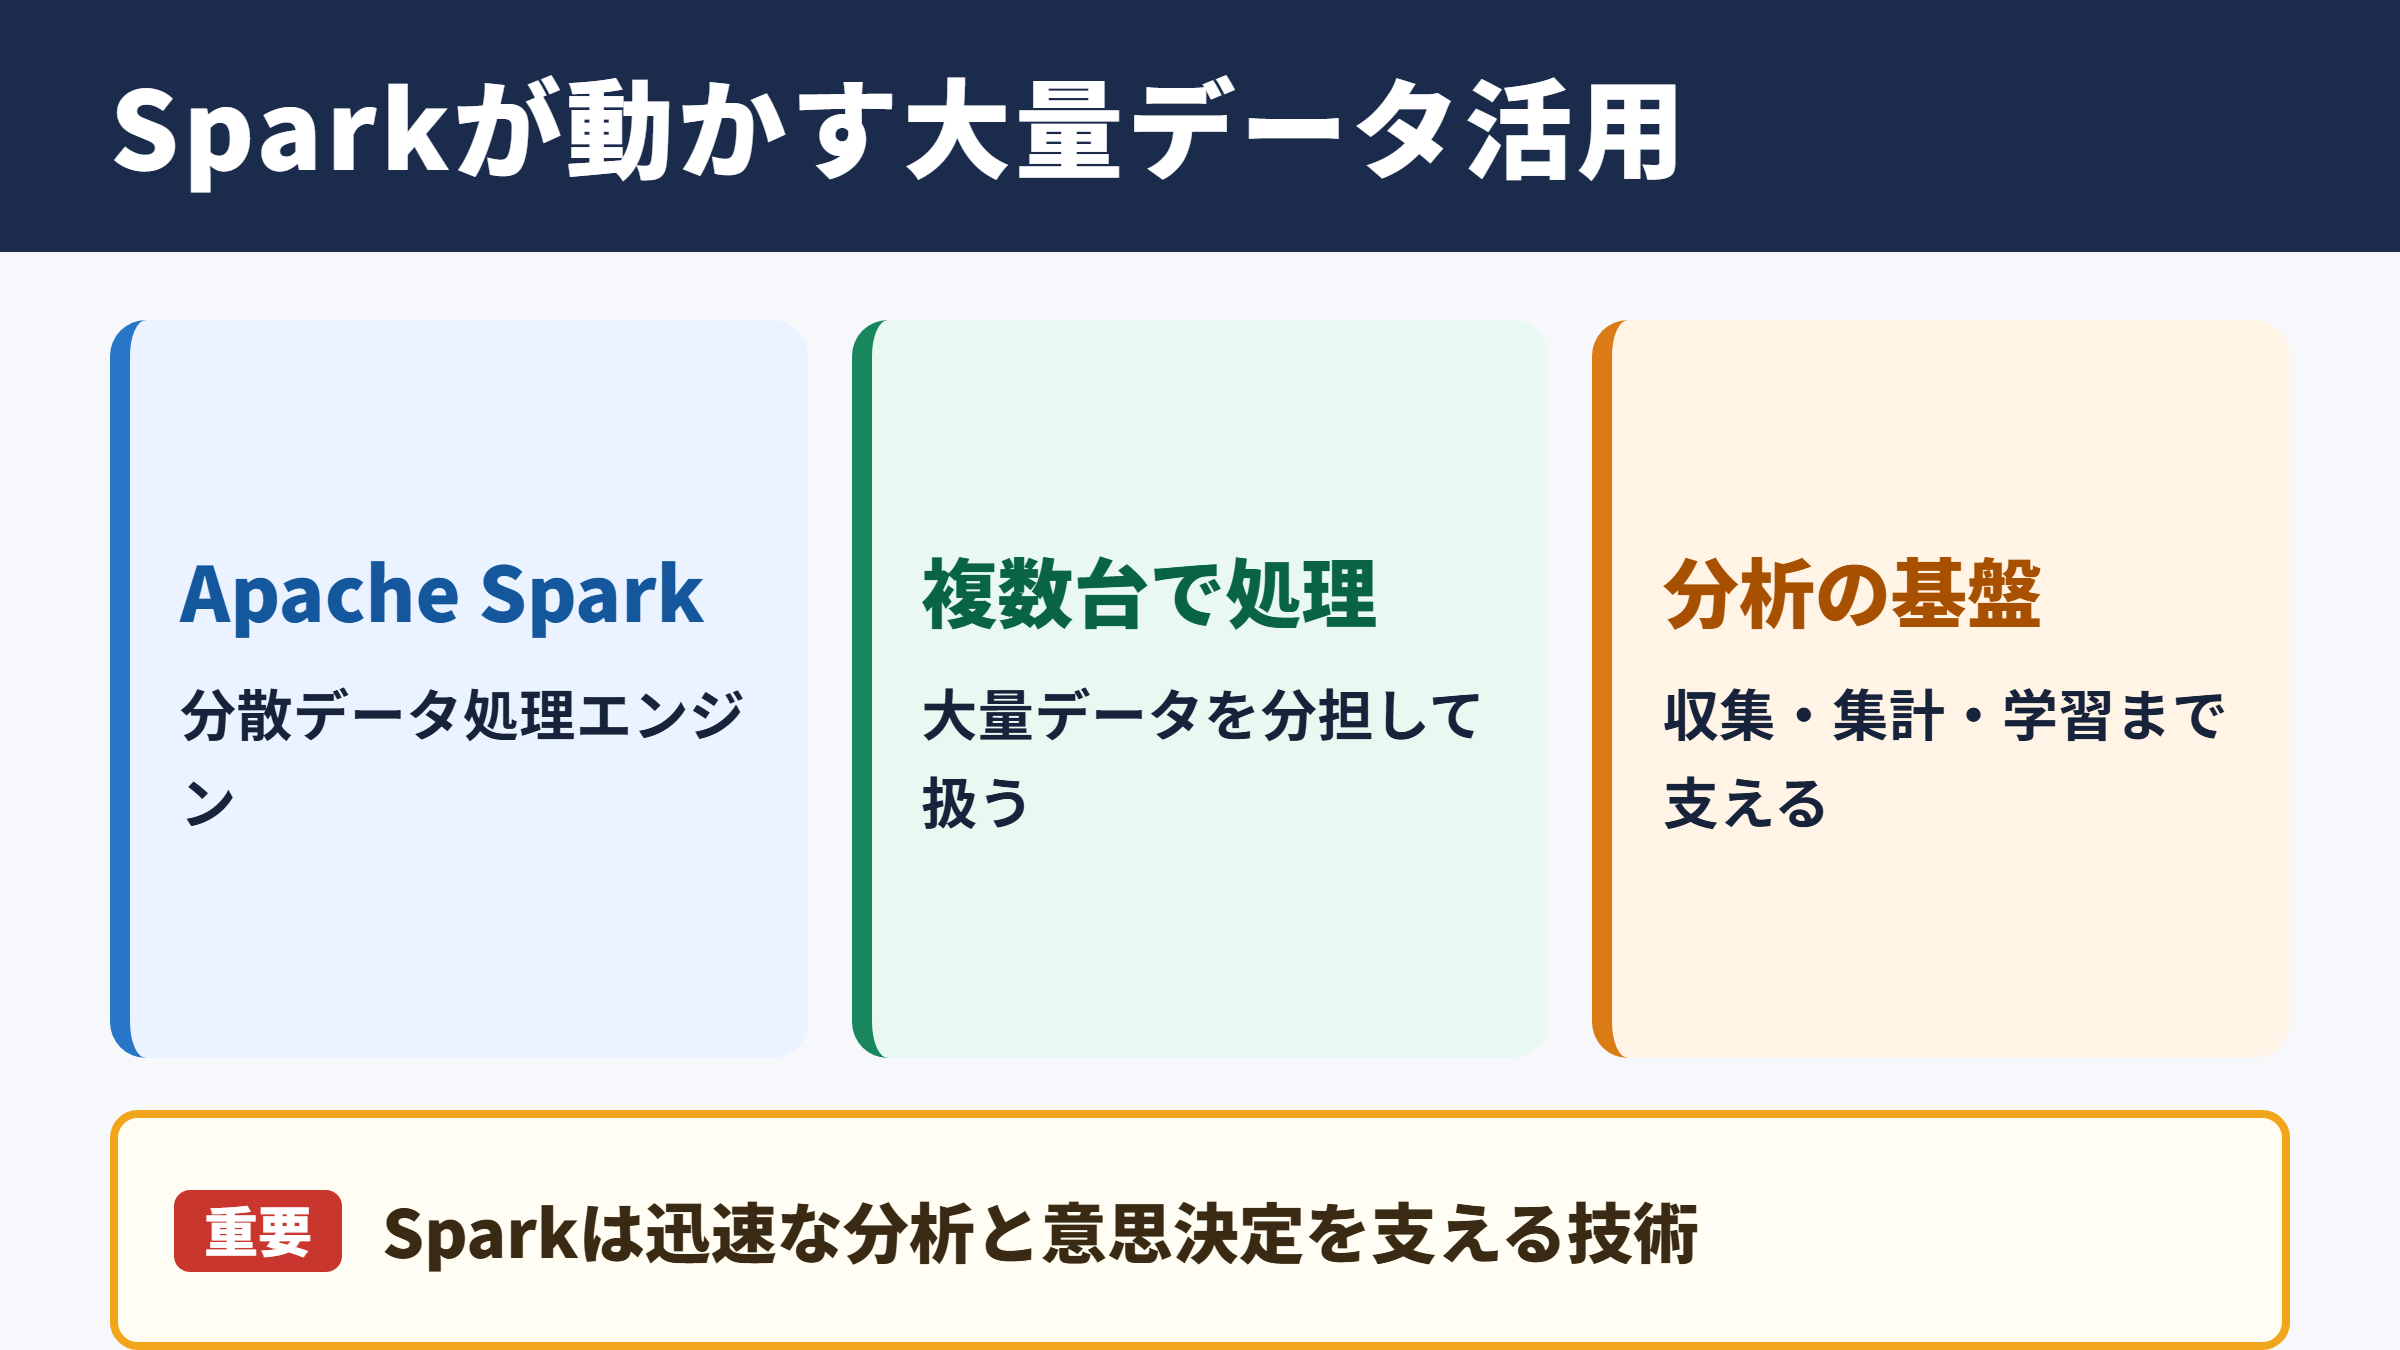
それではまずSparkの意味と、ビジネスでどのように役立つ技術なのかについて解説していきます。
Apache Sparkとしての基本的な意味
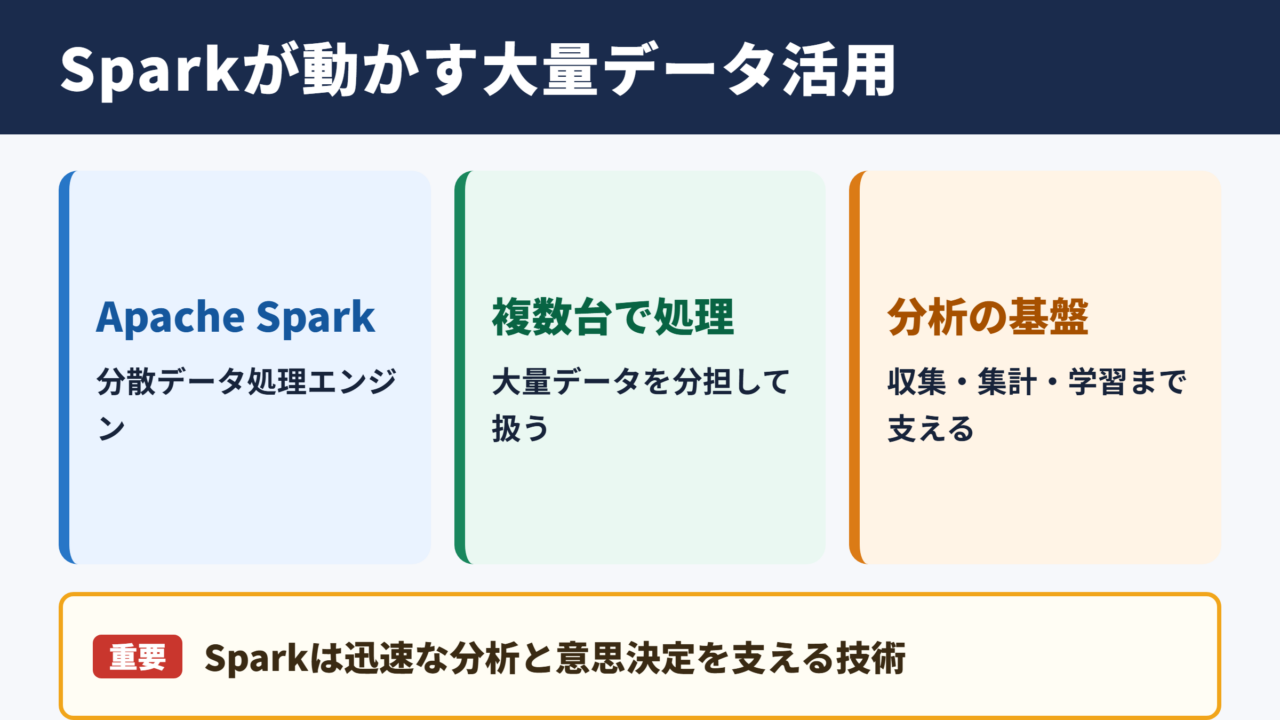
ITや開発の文脈でSparkといった場合、一般的にはApache Sparkという分散データ処理エンジンを指します。
複数のコンピューターを連携させ、大量のデータを分担して処理できるオープンソースのソフトウェアです。
たとえば、数百万件から数億件に及ぶ売上履歴、アクセスログ、センサーデータ、顧客行動データを分析する場合、1台のパソコンだけでは時間がかかりすぎることがあります。
Sparkは処理を複数のマシンへ割り振ることで、規模の大きいデータにも対応しやすくします。
名称のSparkには火花という意味があります。
データを素早く処理し、分析や意思決定に火をつける存在というイメージで捉えると覚えやすいでしょう。
Apache Software Foundationのプロジェクトとして開発が進められており、多くの企業や開発者が利用しています。
Sparkは単なる表計算ツールではなく、大量データの収集、加工、集計、機械学習、ストリーミング処理までを幅広く支える基盤技術です。
ビジネスでSparkが必要とされる背景
企業活動では、販売実績、在庫、広告配信、Webサイトの閲覧履歴、問い合わせ内容など、さまざまなデータが日々増えています。
こうした情報を活用できれば、需要予測、顧客分析、不正検知、業務改善といった施策につなげられます。
一方で、データ量が増えるほど、集計や分析に必要な時間、保存コスト、システム運用の負荷も大きくなります。
そこで注目されるのが、分散処理によって大量データを扱うSparkです。
夜間まで待たなければ得られなかった集計結果を早めに確認できれば、担当者は変化に素早く対応しやすくなります。
広告施策の見直し、欠品の予防、異常な取引の検知など、時間が成果に影響する業務ほど価値を感じやすい領域です。
もちろん、すべての企業がSparkを導入すべきわけではありません。
小規模なデータであれば、データベースの集計機能やBIツールだけで十分なこともあります。
データ量、処理頻度、分析の目的を見極めて選ぶことが重要です。
一般名詞のsparkとの使い分け
英語のsparkには、火花、きっかけ、ひらめき、活気といった意味があります。
たとえば、spark an ideaはアイデアを生み出すきっかけになるというニュアンスです。
ビジネス英語では、会議が新しい議論の火付け役になったという意味合いで使われることもあります。
しかし、社内資料にSparkという表記があり、データ基盤、Python、SQL、クラウド、ログ分析などの言葉が近くにある場合は、Apache Sparkを示す可能性が高いでしょう。
| 表現 | 主な意味 | 使われやすい場面 |
|---|---|---|
| spark | 火花、きっかけ、ひらめき | 一般英語、企画、コミュニケーション |
| Spark | Apache Sparkなどの固有名詞 | IT、データ分析、システム開発 |
| Apache Spark | 分散データ処理エンジン | 技術文書、開発資料、導入検討 |
| Spark job | Spark上で実行する処理単位 | 運用監視、バッチ処理、障害調査 |
同じ表記でも意味が異なるため、略称だけで断定しない姿勢が求められます。
Sparkの処理の仕組み
続いてはSparkが大量データを扱える理由と、処理の流れを確認していきます。
分散処理を支えるクラスター構成
Sparkは、複数のコンピューターで構成されるクラスター環境で動かすことを前提にしています。
処理全体を管理する役割を持つコンポーネントと、実際の計算を担当するコンピューターが協力して作業を進めます。
一般に、処理を指示する側はドライバー、個別の計算を実行する側はワーカーやエグゼキューターと呼ばれます。
大きなデータを小さな単位に分け、複数のエグゼキューターで並行処理する点が重要です。
たとえば1億件の注文データを10の処理単位に分割できれば、各単位を並行して集計できる可能性があります。
実際の処理時間はデータの偏り、ネットワーク、CPU、メモリ、保存先の性能にも左右されるため、単純に10分の1になるとは限りません。
それでも、1台だけで順番に処理する方式と比べて、規模に応じた拡張を考えやすいことがSparkの特徴です。
処理時間の考え方の例です。
単一環境で120分かかる処理でも、データを適切に分割し、並列実行の効率が高ければ、実行時間を大幅に短縮できる場合があります。
ただし、分割や通信にも時間がかかるため、処理台数を増やすだけで必ず高速化するわけではありません。
メモリを活用する高速処理
Sparkの大きな特徴として、メモリを活用して処理を高速化しやすい設計が挙げられます。
従来の大量データ処理では、中間結果をディスクへ何度も書き出しながら処理を進めることがありました。
ディスクへの読み書きは、メモリ上での処理と比べて時間がかかる傾向があります。
Sparkでは、繰り返し使う中間データをメモリに保持する仕組みを利用できます。
この仕組みはキャッシュや永続化と呼ばれ、反復計算が多い分析や機械学習で特に役立ちます。
たとえば、同じ顧客データに対して年齢層別、地域別、購入頻度別と複数の切り口で分析する場合、共通部分を再利用できる可能性があります。
ただし、メモリは無限ではありません。
保持するデータが多すぎると、メモリ不足や処理の遅延を招くため、キャッシュする対象を慎重に選ぶ必要があります。
遅延評価と処理計画の考え方
Sparkでは、処理命令を書いた直後にすべてが実行されるとは限りません。
必要な結果を取得する段階まで処理をまとめ、より効率的な実行計画を考える仕組みがあります。
この考え方は遅延評価と呼ばれます。
たとえば、データを読み込み、不要な列を削除し、条件で絞り込み、最後に集計する処理を記述したとします。
最終結果が必要になるまで、Sparkは処理の流れを組み立てている状態になることがあります。
集計結果を画面表示したり、ファイルに保存したりする操作を実行のきっかけにして、実際の計算が始まります。
この仕組みにより不要な処理を減らせることがありますが、初心者には動作が見えにくい面もあります。
想定より遅い場合は、実行計画、データ量、分割数、結合方法を確認する習慣が必要でしょう。
Sparkの性能はプログラムだけで決まりません。
データの保存形式、分割方法、クラスター構成、メモリ設定、ネットワーク状況を含めて最適化する視点が欠かせません。
Sparkでできることと主な使い方
続いてはSparkの代表的な機能と、実務での使い方を確認していきます。
SQLによるデータ集計と分析
Spark SQLは、SQLに近い書き方でデータを抽出、結合、集計できる機能です。
SQLはデータベースを扱う多くの担当者にとって親しみのある言語であり、Sparkを活用する入口にもなります。
売上データから月別の売上額を求めたり、商品マスタと注文履歴を結合したり、特定条件の顧客を抽出したりする用途に向いています。
CSV、JSON、Parquetなど複数のデータ形式を扱える点も利点です。
特にParquetのような列指向形式を使うと、分析時に必要な列だけを読み込みやすくなります。
結果として、処理時間やストレージアクセスを抑えられる場合があります。
月別売上を集計するイメージです。
注文データから対象期間を絞り込み、注文日を月単位にまとめ、金額を合計します。
分析対象が大きくても、Spark SQLを使えばSQLの考え方を生かしながら処理を設計できます。
ただし、SQLが書けることと、分散処理を効率よく設計できることは別の知識です。
大量データの結合では、どちらの表が大きいか、キーに偏りがないか、不要な列を早めに除外できるかを意識する必要があります。
ストリーミングデータのリアルタイム処理
Spark Structured Streamingを利用すると、継続的に届くデータを処理する仕組みを構築できます。
Webサイトのアクセスログ、IoT機器のセンサーデータ、決済イベント、アプリの操作履歴などが代表例です。
リアルタイム処理と聞くと、データが届いた瞬間に必ず処理する印象を持つかもしれません。
実際には、短い時間間隔でデータをまとめて処理する方式も多く使われます。
数秒や数分ごとに新着データを集計し、ダッシュボードを更新する運用であれば、ビジネス上は十分にリアルタイムといえる場合もあります。
求める速報性と運用コストのバランスを見て、処理間隔を決めることが大切です。
不正利用の兆候を検知したい、注文急増を早く把握したい、障害の前兆を見つけたいといった業務で活用を検討できます。
機械学習とデータサイエンス
SparkにはMLlibという機械学習ライブラリがあり、分類、回帰、クラスタリング、特徴量の変換といった処理を扱えます。
たとえば、過去の購買履歴から購入見込みを予測したり、似た傾向を持つ顧客群を分類したりする用途が考えられます。
データ前処理からモデル学習までを同じ基盤で進めやすいことは、分析業務の流れを整理するうえで便利です。
一方で、高度な深層学習や最新の生成AIモデルの学習では、専用フレームワークやGPU環境を組み合わせることもあります。
SparkはすべてのAI開発を置き換える道具ではなく、大規模データの加工と分析を支える土台として理解するとよいでしょう。
| 主な機能 | できること | 活用例 |
|---|---|---|
| Spark SQL | 抽出、集計、結合、分析 | 売上分析、顧客分析、レポート作成 |
| Structured Streaming | 継続的に届くデータの処理 | ログ監視、異常検知、速報ダッシュボード |
| MLlib | 機械学習の前処理と学習 | 需要予測、顧客分類、離反予測 |
| GraphX | つながりを持つデータの分析 | ネットワーク分析、関係性の可視化 |
SparkとHadoopやデータベースとの違い
続いてはSparkと比較されやすい関連技術との違いを確認していきます。
Hadoopとの役割の違い
SparkとHadoopは、どちらも大量データを扱う文脈で登場するため、混同されがちです。
Hadoopは大規模データの保存や分散処理の仕組みを支える技術群であり、長くビッグデータ基盤の中心的な存在でした。
Hadoop MapReduceは、処理の途中でディスクへの書き込みを行う設計が基本です。
対してSparkは、メモリを活用した処理に強みがあり、反復計算や対話的な分析で高速性を期待しやすい特徴があります。
ただし、SparkとHadoopは常に競合する関係ではありません。
Hadoopの分散ファイルシステムに保存したデータをSparkで処理する構成も考えられます。
現在はクラウドストレージとSparkを組み合わせるケースも増えており、利用環境によって最適な構成は変わります。
役割を単純化すると、Hadoopは大規模データを保存し分散して扱うための基盤、Sparkはそのデータを高速に計算するためのエンジンとして整理できます。
ただし、製品やクラウドサービスごとに提供範囲は異なるため、導入時は個別の機能を確認する必要があります。
データベースやBIツールとの違い
データベースは、業務システムのデータを正確に登録、検索、更新するために使われます。
一方、Sparkは大量データをまとめて加工、変換、分析する処理に適しています。
たとえば、注文を受け付ける画面で在庫数を即時に確認する処理は、通常は業務用データベースが担います。
過去5年分の注文履歴を使い、顧客ごとの購買傾向を分析する処理は、Sparkのような分析基盤が得意とする領域です。
BIツールは、集計結果をグラフや表で可視化し、利用者が意思決定しやすくする役割を持ちます。
Sparkでデータを整備し、BIツールで見える形にするという連携もよく行われます。
どれか一つを選んで終わりではなく、データの発生、保存、加工、分析、可視化という流れで役割を分ける考え方が実務的です。
クラウドサービス上のSparkとの関係
Sparkを利用するには、以前はクラスターの構築、サーバー管理、ライブラリ設定などを自社で行う場面が多くありました。
現在はクラウドサービス上でSpark環境を利用できる選択肢が広がっています。
代表的な例として、マネージド型の分析基盤やノートブック環境があり、インフラ管理の負担を減らしながら開発を始めやすくなっています。
クラウドを使う場合でも、Sparkの基本的な仕組みを理解していなければ、コストや性能の問題に気付きにくくなります。
処理が終わった後も計算資源を起動したままにすると、利用料金が想定以上になることがあります。
利用者が増えるほど、権限管理、データ持ち出し対策、監査ログの確認も重要になります。
| 比較対象 | 主な役割 | Sparkとの関係 |
|---|---|---|
| Hadoop | 分散保存と大規模処理の基盤 | 保存基盤などを組み合わせる場合がある |
| 業務用データベース | 日常業務の登録、更新、検索 | 分析用にデータを連携することがある |
| データウェアハウス | 分析向けの統合データ管理 | Sparkで加工したデータを格納する場合がある |
| BIツール | 可視化とレポート | Sparkの処理結果を表示する場合がある |
| クラウド分析基盤 | 環境提供と運用支援 | Sparkを実行する場として利用できる |
Spark導入によるメリット
続いてはSparkを導入することで期待できるメリットを確認していきます。
大量データ処理のスピード向上
Sparkを導入する大きなメリットは、データ量が増えたときにも処理時間を抑えやすい点です。
処理が数時間から数十分へ短縮されれば、分析担当者が試行錯誤できる回数も増えます。
分析結果を翌日まで待つ必要がなくなれば、担当部署との対話も進めやすくなるでしょう。
特に、複数回の集計や機械学習の学習処理では、待ち時間の短縮が業務の質に直結します。
ただし、単純な集計だけであれば、より軽量な仕組みの方が費用対効果に優れることもあります。
まずは現在の処理時間、データ増加率、利用者数を測定し、本当に高速処理が必要な業務を明確にすることが大切です。
多様なデータ形式への対応
企業が保有するデータは、整然とした表形式だけではありません。
CSVのようなテキストデータ、JSON形式のログ、画像に付随する情報、クラウドストレージ上のファイルなど、形式や保管場所が分かれています。
Sparkはさまざまなデータソースを読み込み、分析しやすい形に加工する処理を設計できます。
たとえば、Webログと会員情報、商品情報、広告データを組み合わせ、顧客の行動を多面的に把握することが可能になります。
このとき重要なのは、単にデータを集めることではありません。
項目名の揺れ、欠損値、重複、文字コード、更新時刻の違いを整えなければ、分析結果の信頼性が下がります。
Sparkはデータ整形を効率化する手段ですが、データ品質の判断まで自動で行うものではない点を理解しておきましょう。
言語選択の幅と開発チームの連携
SparkはPython、Java、Scala、R、SQLなど複数の言語やインターフェースで利用できます。
Pythonを使うデータ分析担当者、SQLを使うデータアナリスト、JavaやScalaを使うアプリケーション開発者が、同じ基盤を活用できる可能性があります。
特にPythonからSparkを扱うPySparkは、データ分析や機械学習の分野で広く知られています。
使い慣れた言語で始められることは、導入の心理的な壁を下げる要素になるでしょう。
一方で、同じ処理でも書き方や性能特性が異なる場合があります。
チーム内でコーディング規約、データ定義、レビュー方法、実行環境の管理方法を決めておくと、運用品質を保ちやすくなります。
Sparkの価値は高速化だけではありません。
データ加工から分析までの流れを共通基盤に集約し、部門横断でデータ活用を進めやすくする点にも大きなメリットがあります。
Sparkを使う際の注意点
続いてはSparkの導入や運用で見落としやすい注意点を確認していきます。
データ偏りによる処理遅延
Sparkではデータを分割して並列処理しますが、各処理単位に均等にデータが配られるとは限りません。
特定の顧客ID、商品コード、地域コードなどにデータが集中すると、一部の処理だけが極端に遅くなることがあります。
このような状態はデータスキューと呼ばれます。
たとえば、全注文の大半が一つの大口顧客に集中している場合、その顧客IDをキーにした集計や結合で偏りが起きやすくなります。
クラスターの台数を増やしても、偏った一部の処理が終わらなければ全体は完了しません。
実行時間の長い処理単位を監視し、キーの設計、分割方法、結合方法を見直す必要があります。
コスト管理とリソース設計
Sparkは大規模な計算資源を利用できる反面、設定を誤るとコストが大きくなります。
メモリやCPUを多く割り当てれば速くなるとは限らず、データ量に対して過剰な構成では費用が無駄になります。
反対に、リソースが不足すれば処理の失敗、再実行、待ち時間の増加につながります。
まずは小規模な検証で実行時間、メモリ使用量、データ読み込み量を測定し、段階的に構成を調整する方法が現実的です。
定期実行のバッチ処理では、処理終了後に計算資源を停止できているかも確認しましょう。
コスト確認の基本項目です。
実行回数、1回あたりの処理時間、使用した計算資源、保存データ量、データ転送量を定期的に確認します。
月額だけを見るのではなく、処理1回あたりや利用部門あたりの費用に分けると、改善ポイントを見つけやすくなります。
セキュリティと運用体制
顧客情報、購買履歴、位置情報、従業員情報などを扱う場合は、セキュリティ対策が欠かせません。
誰がどのデータにアクセスできるのかを明確にし、必要最小限の権限を付与することが基本です。
個人情報を分析に使う場合は、マスキング、匿名化、アクセスログの記録、保存期間の管理も検討する必要があります。
また、Sparkのジョブが失敗したときに誰が対応するのか、データ更新が遅れたときにどの部署へ連絡するのかも決めておきましょう。
技術者だけに運用知識が集中すると、担当者の不在時に対応が難しくなります。
手順書、監視画面、障害時の連絡先、復旧方法を整備し、データを使う部門と運用する部門が同じ状況を把握できる体制をつくることが重要です。
Sparkの意味と活用ポイントのまとめ
Sparkは、ITや開発の分野では主にApache Sparkを指し、大量データを複数のコンピューターで分散処理するための技術です。
SQLによる集計、ログのストリーミング処理、機械学習の前処理など、幅広いデータ活用を支えられます。
メモリを活用した高速処理や、多様なデータ形式に対応しやすい点は大きな魅力です。
一方で、データ偏り、リソース設定、クラウド利用料、セキュリティ、運用体制といった注意点もあります。
Sparkを導入する目的は、技術を使うこと自体ではなく、データから意思決定に役立つ情報を早く安全に得ることです。
まずは対象業務のデータ量、処理時間、更新頻度、利用者を整理し、必要な範囲から検証を始めるとよいでしょう。
Hadoop、データベース、データウェアハウス、BIツールとも役割を分けながら組み合わせることで、Sparkの強みをより生かせます。