テキストデータは、パソコンやスマートフォン、業務システムなど、身近な場所で幅広く使われているデータです。文字だけで構成されるように見えても、保存形式や文字コード、拡張子の選び方によって、読みやすさや他のシステムとの連携しやすさが変わります。
メール本文、議事録、顧客情報、プログラムのソースコード、Webページの文章なども、基本的にはテキストデータとして扱われます。画像や動画より容量を抑えやすく、検索や編集にも向くため、情報を蓄積して活用する場面で欠かせない存在です。
この記事では、テキストデータの意味、特徴、代表的な形式、拡張子の種類、実務での活用方法までをわかりやすく解説します。保存時に起こりやすい文字化けや、データを扱う際の注意点も確認していきましょう。
テキストデータの基本と活用価値
それではまずテキストデータの基本と活用価値について解説していきます。
文字情報として保存されるデータ
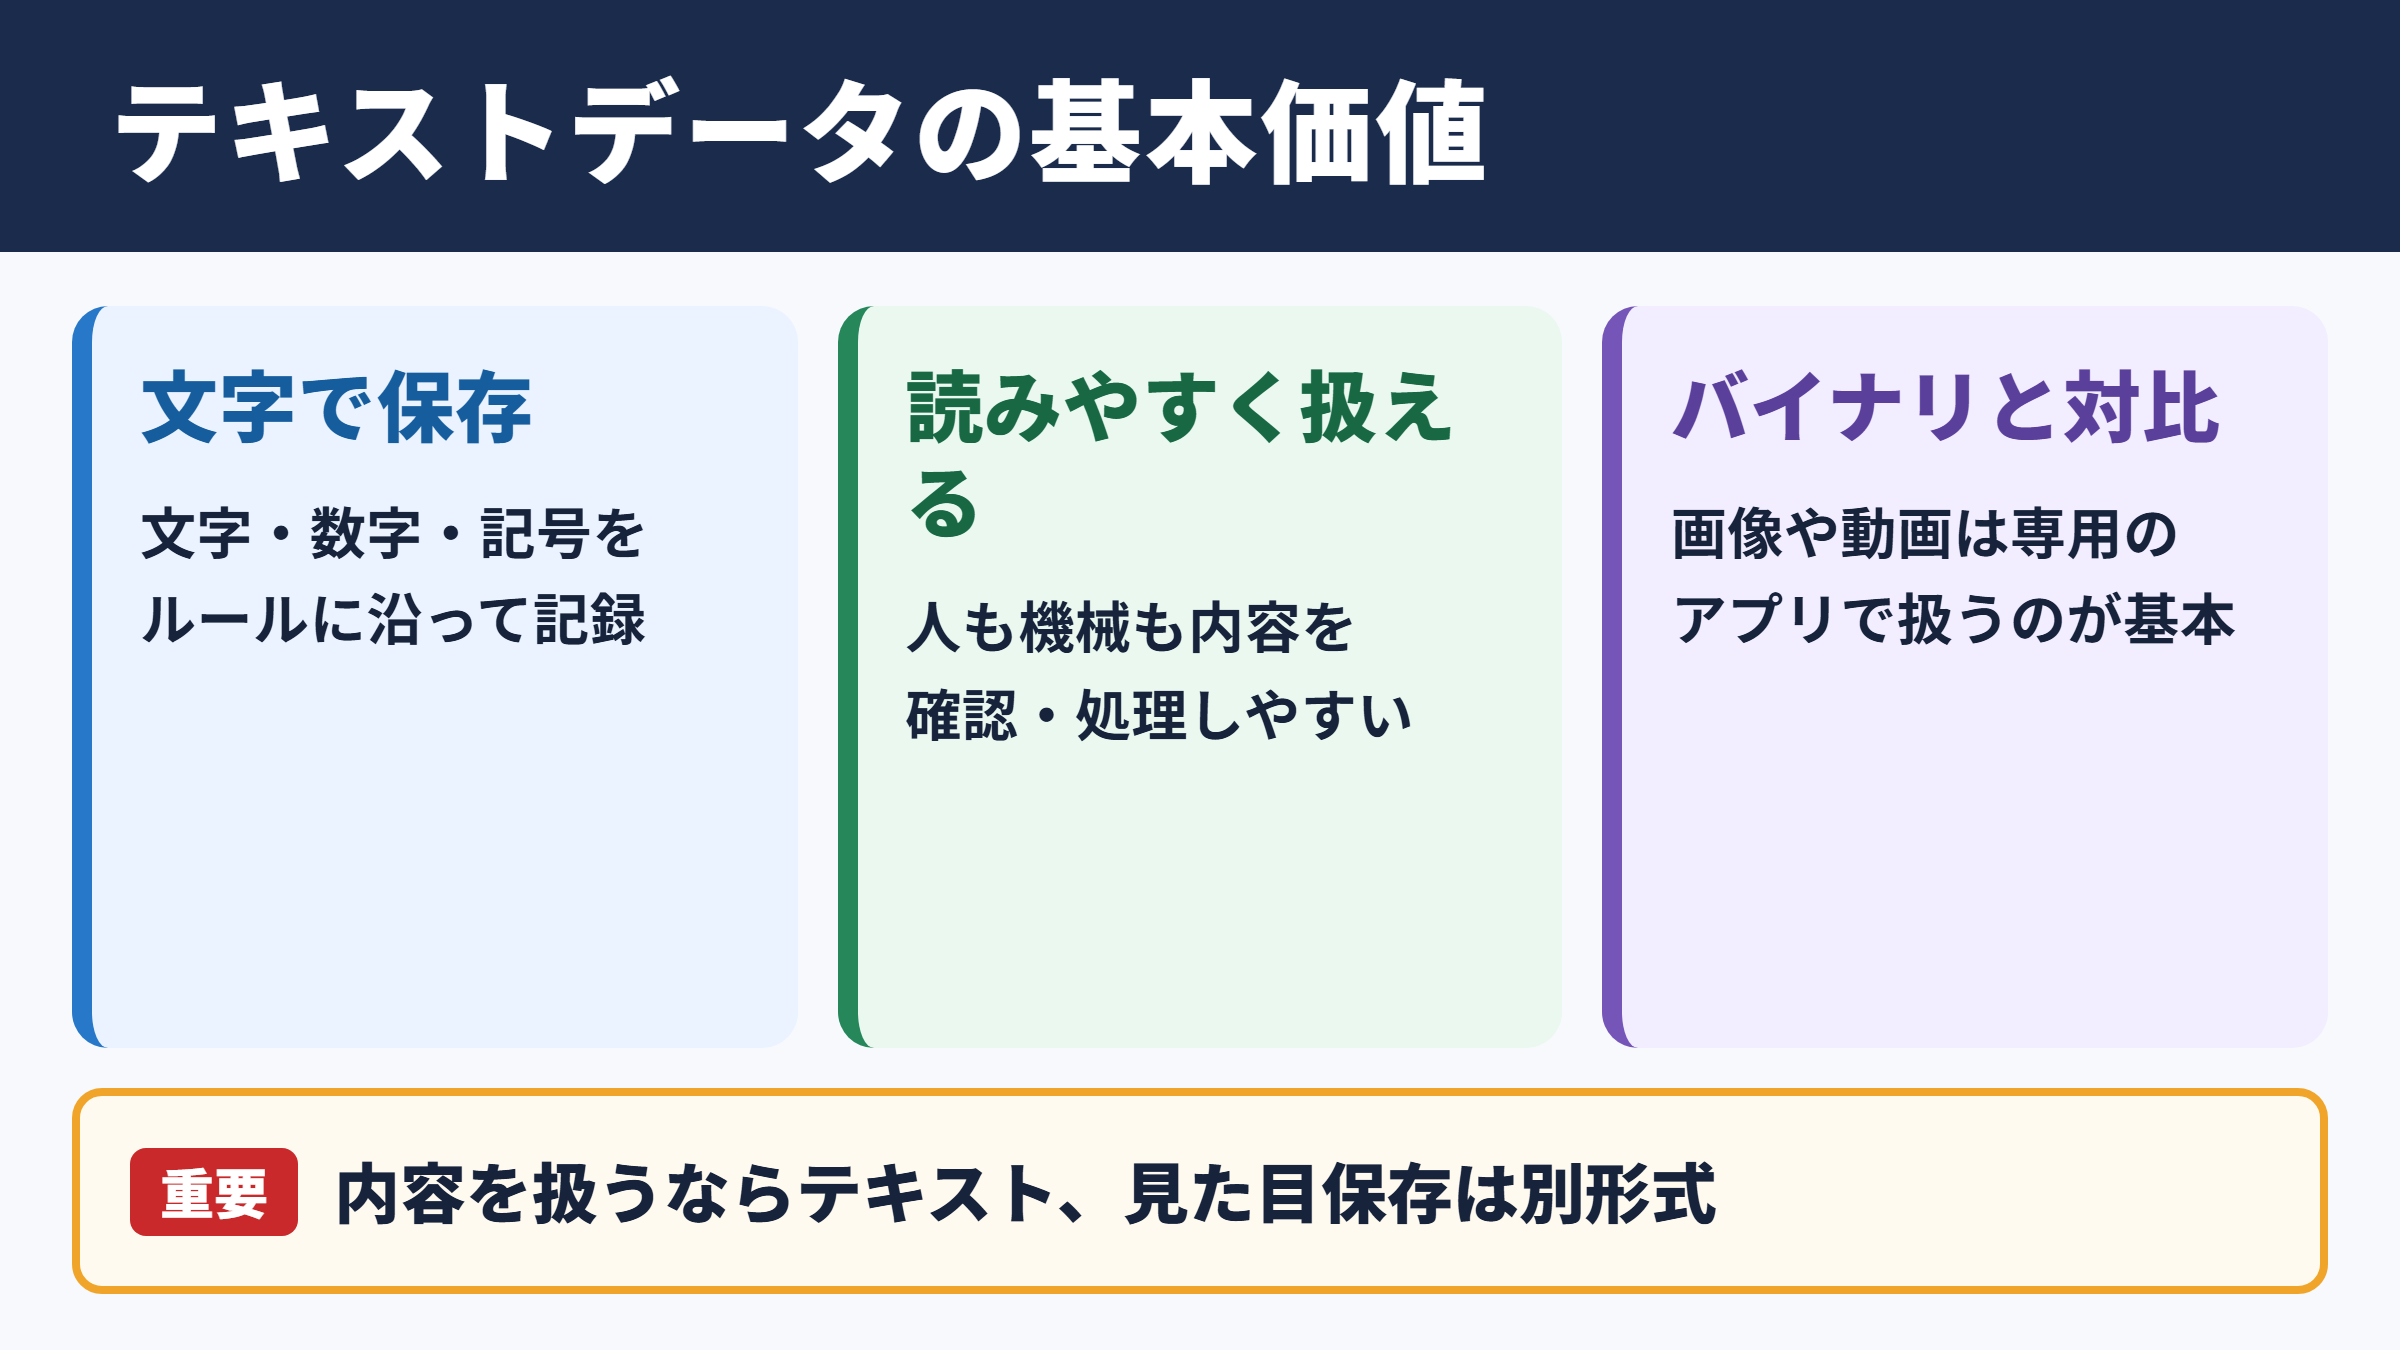
テキストデータとは、文字、数字、記号、改行などを一定のルールに従って保存したデータのことです。人が読む文章だけでなく、コンピューターが処理する命令文や設定情報も含まれます。
たとえば、メモ帳で作成した文章、問い合わせ内容の一覧、メールの本文、CSV形式で出力した売上データなどは代表例です。見た目は文字の並びでも、内部では文字コードという規則に基づいた数値として保存されています。
テキストデータは、人が読みやすいことと機械が処理しやすいことを両立しやすい点が大きな特徴です。特別なソフトがなくても開ける形式が多く、長期間の保管にも向いています。
一方で、文字の装飾、写真、図形、複雑なレイアウトをそのまま保持する用途には限界があります。そのため、文章の内容そのものを扱うのか、見た目まで保存したいのかを分けて考えることが重要でしょう。
バイナリデータとの違い
テキストデータと対比される言葉に、バイナリデータがあります。バイナリデータは、画像、音声、動画、PDF、実行ファイルなどのように、内容をそのまま文字として読むことが難しいデータです。
画像ファイルをメモ帳で開くと、意味を判断しにくい記号が並んで見えるでしょう。これは画像の色や配置、圧縮情報などが、文字を読むためではない形式で記録されているためです。
| 比較項目 | テキストデータ | バイナリデータ |
|---|---|---|
| 主な内容 | 文章、数値、設定、命令 | 画像、音声、動画、実行情報 |
| 閲覧方法 | テキストエディタで確認しやすい | 対応アプリケーションが必要になりやすい |
| 編集のしやすさ | 検索、置換、追記がしやすい | 専用ソフトでの編集が中心 |
| 容量の傾向 | 比較的小さい | 内容により大きくなりやすい |
| 活用例 | 議事録、ログ、CSV、HTML | 写真、動画、PDF、アプリ |
ただし、テキストデータとバイナリデータは、優劣で分けるものではありません。用途に合わせて適したデータ形式を選ぶことが、情報管理の基本になります。
業務や日常で広がる利用場面
テキストデータは、日常生活から企業活動まで多彩な場面で利用されています。検索エンジンがWebサイトの内容を理解する際にも、ページ内の文章や見出しといったテキスト情報が重要な手がかりになります。
業務では、顧客対応の履歴、アンケート回答、作業手順書、チャットの記録、アクセスログなどが蓄積されます。これらを整理すれば、問い合わせの傾向や顧客ニーズ、業務上の課題を把握しやすくなるでしょう。
テキストデータは単なる文章ではなく、検索、分類、集計、分析、共有へつなげられる情報資産です。内容を統一した形式で保存するほど、後から活用できる可能性が広がります。
近年は生成AIや自然言語処理の利用が広がり、文章データを要約したり、分類したり、質問への回答に利用したりする機会も増えました。活用の幅が広いからこそ、正確性や個人情報の取り扱いにも注意が必要です。
テキストデータの特徴とメリット
続いてはテキストデータの特徴とメリットを確認していきます。
軽量で保存しやすい性質
テキストデータの魅力は、比較的容量が小さいことです。一般的な文章であれば、多くの文書を保存してもディスク容量を圧迫しにくく、メール添付やクラウド共有にも適しています。
もちろん、非常に長いログや大量のデータを含むCSVファイルでは容量が大きくなります。それでも高画質な画像や動画に比べると、情報量に対して軽量に扱えるケースが多いでしょう。
容量を抑えながら内容を残せるため、履歴管理やバックアップの対象としても扱いやすい形式です。テキストで保管した記録は、将来別の環境へ移す際にも役立ちます。
ファイルサイズを意識する場合は、不要な空白、重複行、古いログの保存期間などを見直すことも有効です。圧縮形式と組み合わせれば、大量のテキストをさらに効率よく保管できます。
検索と編集に向く構造
テキストデータは、特定の単語や数字を素早く検索できる点でも優れています。紙の資料では探しにくい情報でも、検索機能を使えば必要な箇所へ短時間でたどり着けます。
編集も比較的簡単です。文字列の追加、削除、置換、並べ替えができるため、名称変更や表記ゆれの修正、データの整形といった作業を効率化できます。
たとえば、旧商品名を新商品名へ変更する場合、検索と置換を使えば多くの箇所をまとめて修正できます。ただし、固有名詞の一部まで置き換えてしまう可能性があるため、実行前のバックアップと実行後の確認が大切です。
検索しやすいデータにするには、見出しの表記、日付の形式、担当者名の書き方などをできるだけ統一します。自由に入力された文章でも、ルールを設けることで後工程の集計や分析がしやすくなります。
環境をまたいで共有しやすい利点
多くのテキスト形式は、特定のソフトに強く依存しにくいという利点があります。Windows、macOS、Linuxなどの異なるOSでも、適切な文字コードを選べば内容を共有しやすくなります。
特にUTF-8は、Webや多言語の文章で広く利用されている文字コードです。日本語、英語、中国語、記号などを一つのファイルで扱いやすく、国際的なシステム連携でも採用されることが多くあります。
共有のしやすさは、拡張子だけでなく文字コードの一致によって支えられています。同じTXTファイルでも保存設定が異なると、受け取った側で文字化けする場合があります。
社内外でファイルを受け渡す場合は、保存形式、文字コード、区切り文字、改行コードまで確認すると安心です。小さな設定差が、取り込みエラーや表示崩れにつながることがあります。
テキストデータの形式と拡張子
続いてはテキストデータの形式と拡張子について確認していきます。
TXT形式と基本的な使い方
TXTは、もっとも基本的なテキストファイルの拡張子です。文字情報を中心に保存する形式で、メモ、手順書の下書き、簡易的な記録、ログの確認などに使われます。
TXT形式には、太字、文字色、表組みといった見た目の情報を保持しないものが一般的です。その分だけ構造が単純であり、環境を選ばず開きやすいという強みがあります。
ただし、TXTという拡張子だけでは文字コードまでは判断できません。保存時にUTF-8、Shift_JIS、EUC-JPなどの設定が使われる場合があり、用途に合わない設定では日本語が正しく表示されないことがあります。
迷ったときは、相手側のシステム仕様を確認したうえでUTF-8を選ぶ方法が基本になります。ただし、古い業務システムではShift_JISを指定されることもあるため、一律に決めつけないことが大切です。
CSV形式と表形式データ
CSVは、カンマで項目を区切って表形式のデータを保存する形式です。拡張子はCSVであり、顧客リスト、商品一覧、受注履歴、アンケート結果などの入出力でよく使われます。
Excelなどの表計算ソフトで開けることから、表データそのものと考えられる場合もあります。しかしCSVは文字列を区切り文字で並べたテキストデータであり、セルの色や数式、グラフなどは通常保持されません。
| 項目 | CSV形式 | 表計算ソフトの独自形式 |
|---|---|---|
| 保存内容 | 行と列の値が中心 | 値、書式、数式、シートなど |
| 互換性 | 多くのシステムで利用しやすい | 対応ソフトに左右されやすい |
| 文字コード | 保存時に確認が必要 | ソフト側で管理されることが多い |
| 主な用途 | データ連携、取込、出力 | 集計、分析、資料作成 |
CSVの一例では、氏名、部署、メールアドレスのように項目を横へ並べます。値の中にカンマや改行を含める場合は、引用符で囲むなど、CSVのルールに従って出力する必要があります。
CSVを扱う際は、先頭のゼロが消える、日付が自動変換される、文字化けするなどの問題にも注意しましょう。開く前にコピーを保存し、取り込み件数や列の対応関係を確認する習慣が役立ちます。
HTMLやJSONなど構造を持つ形式
HTML、JSON、XML、Markdownなども、広い意味ではテキストデータに含まれます。これらは単なる文章ではなく、情報の構造や意味を記述できる形式です。
HTMLはWebページの見出し、段落、リンク、画像の位置づけなどを記述します。JSONは、項目名と値を組み合わせて表現するため、Webサービスやアプリケーション間でデータを受け渡すAPIによく利用されます。
構造化されたテキストデータは、情報の意味を保ちながら自動処理へつなげやすい点が特徴です。人の目で読める程度のわかりやすさと、プログラムで扱える規則性を両立できます。
一方で、記号の抜けや閉じ忘れがあると、正しく読み込めないことがあります。JSONなら引用符や括弧、HTMLならタグの対応関係を確認し、検証ツールを活用することが重要です。
文字コードと文字化けの基礎
続いては文字コードと文字化けの基礎を確認していきます。
文字コードの役割
文字コードとは、文字をコンピューター内部で数値として扱うためのルールです。人間には同じ「あ」という文字に見えても、保存するルールが異なれば、別の数値列として記録されます。
日本語環境では、UTF-8、Shift_JIS、EUC-JPなどが知られています。現在はUTF-8が幅広く採用されていますが、既存の業務ソフトや古いシステムとの連携では別の文字コードを求められることもあります。
文字コードは画面上では見えにくい設定ですが、データ連携の成否を左右する重要な要素です。保存する側と開く側の認識が一致していなければ、正しい文章は表示されません。
とくに複数の国や地域でデータを扱う場合は、特殊記号、旧字体、絵文字、機種依存文字の扱いも確認したいところです。相手先の入力条件を明確にしておくと、トラブルを減らせます。
文字化けが起こる主な原因
文字化けは、保存時の文字コードと、表示時に想定した文字コードが一致していない場合に起こりやすい現象です。日本語が意味のない記号や別の漢字に置き換わったように見えることがあります。
メール添付のCSV、Webサイトからダウンロードしたデータ、異なるOS間で移動したTXTファイルなどで発生しやすいでしょう。ファイル名は正常でも、中身だけが読めないというケースもあります。
文字化けが発生した場合は、すぐに手入力で修正する前に、元ファイルを別の文字コードで開き直してください。元の保存設定がわかれば、内容を復元できる可能性があります。
また、特殊な記号や丸数字、環境依存の絵文字が原因になる場合もあります。外部システムへ渡すデータでは、使用可能な文字種を事前に確認し、必要に応じて一般的な文字へ置き換えます。
保存と受け渡しでの確認事項
テキストデータを安全に受け渡すには、拡張子だけで判断しないことが大切です。保存形式、文字コード、区切り文字、改行コード、引用符の扱いなどを事前にそろえます。
CSVをインポートするシステムでは、カンマ区切り、タブ区切り、UTF-8、Shift_JISといった条件が指定されていることがあります。仕様書に従わない場合、列ずれや登録エラーにつながるため注意が必要です。
| 確認項目 | 確認する内容 | 見落とした場合の影響 |
|---|---|---|
| 拡張子 | TXT、CSV、JSONなどの指定 | ファイルを認識できない |
| 文字コード | UTF-8やShift_JISなど | 文字化けが起こる |
| 区切り文字 | カンマ、タブ、セミコロンなど | 列が正しく分かれない |
| 改行コード | OSやシステム側の条件 | 複数行の扱いが崩れる |
| 文字数制限 | 項目ごとの最大文字数 | 途中で切り捨てられる |
初めて連携する相手には、本番前に少量のテストデータを渡して確認する方法が有効です。実データを一度に送る前に、表示と取り込み結果を確かめられます。
テキストデータの活用方法と管理
続いてはテキストデータの活用方法と管理について確認していきます。
検索性を高める記録方法
テキストデータを後から活用するには、記録の仕方を整えることが欠かせません。必要な情報が文章の中にあっても、表現がばらばらでは検索や集計に時間がかかります。
たとえば問い合わせ履歴を残す場合、日付、担当者、顧客名、問い合わせ分類、対応状況といった項目を一定の書式で記録します。本文は自由記述にしつつ、検索に使う項目を分けておくと便利です。
記録の例として、日付、分類、担当、要点、対応結果を毎回同じ順序で入力します。このようなルールがあると、特定期間の問い合わせ件数や、よくある質問を抽出しやすくなります。
検索性を高めるコツは、自由な文章と定型項目を組み合わせることです。詳細な背景は文章で残し、分類や状態は決められた候補から選ぶと、情報の価値が高まります。
分析やAI活用への展開
蓄積したテキストデータは、単に保管するだけでなく、分析へ活用できます。アンケートの自由回答、レビュー、問い合わせ内容、営業日報などから、頻出する言葉や不満の傾向を把握できるでしょう。
生成AIやテキスト分析ツールを利用すれば、長文の要約、テーマごとの分類、感情傾向の把握、類似した問い合わせの整理などを効率化できる場合があります。ただし、出力内容をそのまま信頼せず、元データと照らし合わせる姿勢が必要です。
AI活用では、機密情報や個人情報を外部サービスへ入力してよいかを必ず確認してください。社内規程、契約条件、利用するサービスの設定に沿って、匿名化や権限管理を行うことが重要です。
分析結果を業務改善へつなげる際は、数字だけで結論を急がないことも大切です。頻出語の背景を実際の文章で読み取り、担当者の経験や顧客の状況と合わせて判断すると、より実用的な施策につながります。
バックアップと安全な保管
テキストデータは軽量で複製しやすい反面、誤って上書きしたり削除したりする可能性があります。重要な文書やログは、定期的にバックアップを取り、保存先を複数に分けると安心です。
ファイル名には、内容、対象期間、更新日、版数などをわかりやすく含めます。後から見たときに最新版がわからない状態を避けるため、命名ルールをチーム内で共有しておくとよいでしょう。
重要なテキストデータは、保存するだけでなく、誰が閲覧や編集できるかを管理する必要があります。アクセス権限を必要最小限にし、退職者や異動者の権限を定期的に見直します。
個人情報、契約情報、認証情報などを含むデータは、暗号化やパスワード保護も検討しましょう。ログへパスワードやトークンを出力しない運用も、情報漏えいを防ぐうえで重要です。
テキストデータの作成時に押さえる注意点
続いてはテキストデータの作成時に押さえる注意点を確認していきます。
表記ゆれと入力ルール
テキストデータでは、同じ意味の言葉が複数の表記で入力される表記ゆれが課題になります。たとえば、オンライン、オン ライン、Web、ウェブのような違いが混在すると、検索結果や集計結果が分散します。
人名、会社名、部署名、商品名、都道府県名などは、とくに表記ゆれが起こりやすい項目です。入力候補を用意したり、選択式の項目を取り入れたりすると、データの品質を保ちやすくなります。
データを活用する予定があるなら、作成段階で入力ルールを決めることが近道です。後から大量のデータを修正するよりも、最初にルールを共有するほうが負担を抑えられます。
ただし、すべてを細かく制限すると入力しにくくなる場合もあります。分析に必要な項目だけを統一し、背景や補足は自由記述で残すなど、現場で続けやすい設計を意識しましょう。
区切り文字と改行の扱い
CSVなどの区切り形式では、値の中にカンマ、引用符、改行が含まれる場合に注意が必要です。単純にカンマで分割すると、住所や説明文の途中で列がずれる可能性があります。
多くのCSV仕様では、カンマを含む値を引用符で囲み、値の中の引用符は一定のルールで表現します。利用するシステムごとに取り込み条件が異なる場合もあるため、仕様の確認が欠かせません。
文章内の改行も、システムによっては複数のレコードとして扱われることがあります。複数行の文章を保存できるか、改行を空白へ置き換える必要があるかを、事前にテストしておくと安心です。
データ連携では、見た目が正しいことより、受信側のルールどおりに解析できることが優先されます。人が読むための整形と、システムへ渡すための形式を分けて管理する場面もあります。
個人情報と機密情報の取り扱い
テキストデータには、氏名、住所、電話番号、メールアドレス、顧客とのやり取り、社内の検討内容などが含まれることがあります。文字だけのファイルだから安全と考えるのは危険です。
共有フォルダやクラウドストレージへ保存する場合は、アクセスできる人の範囲を確認します。不要になったデータをいつまでも保管しないこと、持ち出しのルールを決めることも重要でしょう。
個人情報を含むテキストデータは、目的に必要な範囲だけを保存し、利用目的を明確にします。外部へ共有する際は、氏名や連絡先を伏せる匿名化も検討してください。
誤送信や公開設定のミスを防ぐには、送信前の宛先確認、ファイル内容の確認、共有リンクの権限確認を習慣化します。小さな確認を重ねることが、情報事故の予防につながります。
テキストデータのまとめ
テキストデータとは、文字、数字、記号などを一定のルールで保存したデータです。TXT、CSV、HTML、JSONなどの形式があり、文章の記録からシステム連携、Web制作、データ分析まで幅広く使われています。
軽量で保存しやすく、検索、編集、共有に向くことが主な特徴です。一方で、文字コードや区切り文字の違いによる文字化け、列ずれ、取り込みエラーには注意が必要になります。
テキストデータを有効に活用するには、形式と拡張子を選ぶだけでなく、入力ルール、文字コード、保存先、権限管理まで整えることが大切です。データの作成時から使い道を意識すれば、後から探しやすく、分析しやすい情報資産へ育てられるでしょう。