テストデータは、システム開発や品質保証において、画面や機能が期待どおりに動くかを確認するために使うデータです。
会員情報、注文情報、商品情報、ログ、エラー情報などを用意し、実際の利用場面に近い条件で検証を進めます。
ただし、適当に値を入力すればよいわけではありません。
正常なケースだけでなく、入力漏れ、文字数超過、重複、権限不足、想定外の形式といった異常なケースも含めることで、品質の高いテストにつながります。
この記事では、テストデータの意味、サンプルデータやダミーデータとの違い、作り方、QAでの活用方法までをわかりやすく解説します。
テストデータの意味とシステム開発での役割

それではまずテストデータの意味と、開発現場で担う役割について解説していきます。
テストデータの基本的な定義
テストデータとは、ソフトウェア、Webサービス、業務システム、アプリケーションなどを検証するために準備する入力値や登録情報の総称です。
画面に入力する氏名やメールアドレスだけでなく、データベースに登録されたレコード、CSVファイル、APIのリクエスト内容、画像ファイルなども対象になります。
たとえばECサイトで購入処理をテストする場合は、顧客情報、在庫数、配送先、クーポン、決済情報といった複数のデータが必要です。
これらの組み合わせによって、注文が成立するか、在庫が正しく減るか、メールが送信されるかを確認します。
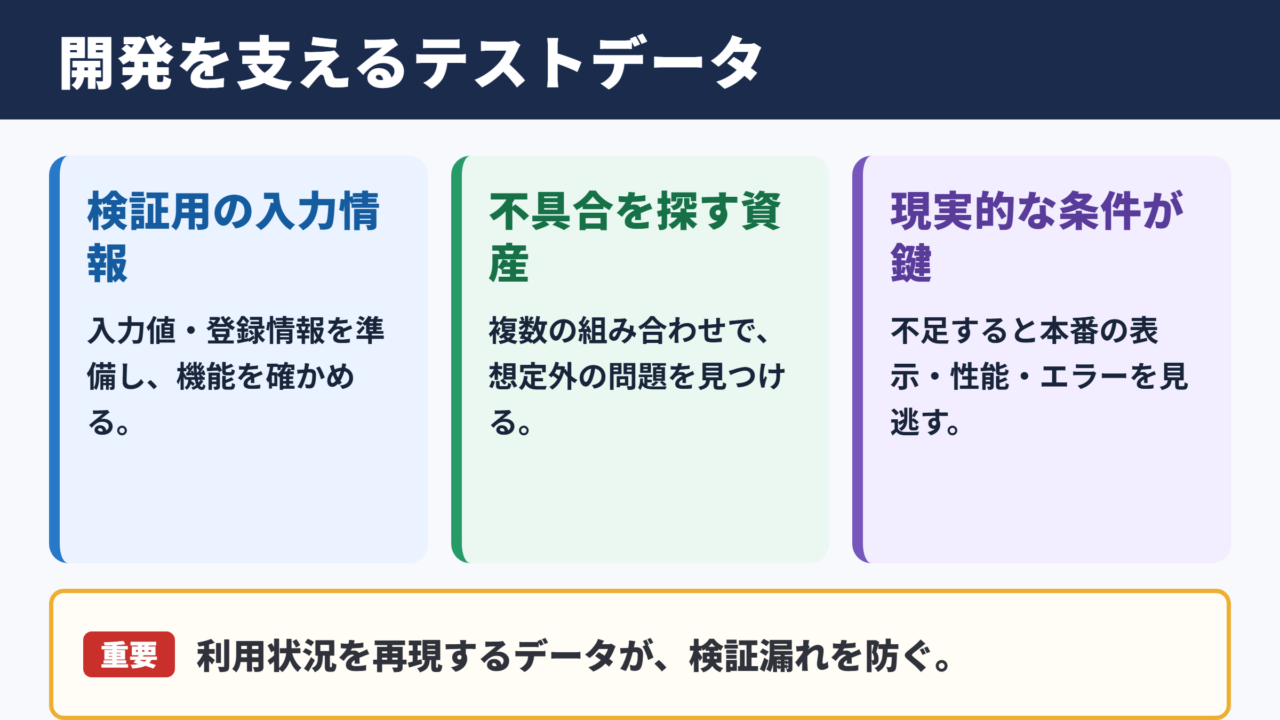
テストデータは、機能を動かすための材料であると同時に、不具合を見つけるための重要な検証資産です。
テストデータが不足した場合の影響
テストデータが少ないと、見た目には正常に動く機能でも、本番環境で問題が発生しやすくなります。
たとえば短い名前だけで確認していると、長い会社名や絵文字を含む氏名を登録した際の表示崩れに気づけません。
また、登録件数が少ない状態では検索機能が速くても、数万件のデータが存在する本番環境では処理が遅くなる場合があります。
正常系だけを用意したテストでは、入力エラー時のメッセージ、ロールバック、通知、権限制御などが十分に確認できません。
テストデータの品質が低いと、テストケースを多く実施していても検証漏れが残ります。
機能単位で必要な条件を整理し、現実的な利用状況を再現することが大切です。
開発工程ごとに異なる利用目的
テストデータは、要件定義から運用保守まで幅広い工程で利用されます。
単体テストでは、プログラムの条件分岐や計算結果を確かめるための小さなデータセットが中心です。
結合テストでは、複数の機能や外部システムをまたぐため、会員、商品、契約、請求など関連する情報をそろえる必要があります。
総合テストや受入テストでは、実際の業務フローに沿ったデータを準備し、利用者目線で動作を確認します。
本番に近い件数を扱う性能テストでは、データ量そのものが検証条件になります。
サンプルデータとダミーデータの違い
続いてはサンプルデータとダミーデータの違いを確認していきます。
サンプルデータの特徴
サンプルデータは、機能の使い方や出力イメージを示すために用意される例示用のデータです。
製品のデモ画面、操作マニュアル、研修環境、テンプレートなどで使われることが多いでしょう。
たとえば顧客管理システムでは、架空の会社名、担当者名、住所、商談履歴をあらかじめ登録しておくことで、利用開始直後から画面の構成を理解しやすくなります。
サンプルデータは必ずしも不具合の検出を目的とするものではなく、利用者に完成形を見せる役割も持ちます。
見本としてわかりやすいことが、サンプルデータに求められる大切な要素です。
ダミーデータの特徴
ダミーデータは、本物の個人情報や機密情報の代わりに使う仮のデータを指します。
氏名を山田太郎、電話番号を架空の番号、メールアドレスを検証用アドレスに置き換える方法が代表例です。
本番データをそのまま開発環境へ複製すると、情報漏えいや不要な閲覧のリスクが高まります。
そのため、実在しない人物や企業の情報を使い、テストに必要な形式や桁数だけを再現する運用が行われます。
ダミーデータは安全性を意識した言葉であり、サンプルデータは説明や例示を意識した言葉として使い分けると理解しやすくなります。
用語ごとの使い分け
開発現場では、テストデータ、サンプルデータ、ダミーデータ、マスタデータ、匿名加工データなど、似た言葉が混在します。
言葉の範囲をそろえておくと、開発者、QA担当者、顧客、運用担当者の認識違いを減らせます。
| 用語 | 主な目的 | 利用場面 |
|---|---|---|
| テストデータ | 機能や品質の検証 | 単体テスト、結合テスト、総合テスト |
| サンプルデータ | 操作例や完成形の提示 | デモ、マニュアル、研修 |
| ダミーデータ | 実データの代替と安全な検証 | 開発環境、検証環境 |
| マスタデータ | 業務で共通利用する基準情報 | 商品、部署、権限、税率 |
| 匿名化データ | 個人や企業を特定しにくくした実績データ | 分析、性能検証、検証用複製 |
用途と取り扱いルールを明確にしたうえで、必要なデータを選ぶことが重要です。
テストデータ設計の基本要素
続いてはテストデータを設計する際に確認したい基本要素を解説していきます。
正常系と異常系の条件
正常系とは、利用者が想定された手順で正しい値を入力した場合の動作です。
異常系とは、必須項目が未入力である場合、形式が不正な場合、権限がない場合など、エラー処理を確認する条件を指します。
たとえば生年月日の入力欄では、正しい日付だけでなく、未来の日付、存在しない日付、文字列、空欄、許容範囲外の年齢も試験対象になります。
メールアドレス入力の例では、正常値として user@example.com を用意します。
異常値として、アットマークがない文字列、空白を含む文字列、上限文字数を超える文字列などを準備します。
異常値を意図的に作ることで、入力チェックやエラーメッセージの品質を確認できます。
境界値と条件分岐
境界値とは、入力可能な範囲の端にある値です。
たとえば文字数が1文字から20文字まで許可されている場合は、1文字、20文字に加えて、0文字と21文字も検証対象にします。
境界付近ではプログラムの比較条件に不備が出やすいため、テストデータ設計では優先度が高い項目です。
入力上限が100件の場合は、99件、100件、101件のデータを作成します。
この3条件を比較すると、上限判定が正しいかを効率よく確認できます。
条件分岐が複数ある場合は、年齢、会員種別、契約状態、在庫状態などを組み合わせ、必要なパターンを整理します。
データの関連性と整合性
業務システムでは、一つのデータだけで完結しない場面が多くあります。
注文データには顧客データと商品データが必要であり、請求データには契約情報や税率情報が関係します。
親子関係や参照関係が壊れたデータを使うと、意図しないエラーが発生し、本来確認したい機能を検証できません。
一方で、参照先が存在しない状態をあえて作り、エラー処理を確認することもあります。
整合性を保つデータと、意図的に整合性を崩すデータを区別して管理する視点が必要です。
テストデータの作り方と準備手順
続いてはテストデータを効率よく作るための手順を確認していきます。
要件とテストケースから必要条件を抽出
最初に、仕様書、画面設計書、API仕様、業務フロー、テストケースを確認します。
入力項目ごとの型、桁数、必須条件、初期値、選択肢、権限、更新条件を洗い出すことが出発点です。
この段階で必要なデータ条件を表にしておくと、テストの途中で不足に気づきにくくなります。
| 確認項目 | 準備するデータ例 | 確認目的 |
|---|---|---|
| 必須入力 | 入力あり、入力なし | 必須チェック |
| 文字数 | 最小値、最大値、超過値 | 桁数制御 |
| 権限 | 管理者、一般利用者、未ログイン | アクセス制御 |
| 状態 | 有効、停止、解約、削除済み | 状態別処理 |
| 連携 | 正常応答、エラー応答、遅延応答 | 外部連携の動作 |
作成前に条件を一覧化することが、漏れの少ないテストデータ設計につながります。
手作業と自動生成の使い分け
少量のデータであれば、画面操作やCSV編集による手作業でも対応できます。
ただし、数千件以上のデータ、複雑な関連データ、繰り返し利用するテスト環境では、自動生成を検討したほうが効率的です。
プログラムやテストデータ生成ツールを使えば、ランダムな氏名、住所、日付、注文履歴などを一定のルールで作成できます。
再現性を持たせるためには、生成条件、使用したスクリプト、投入日時、データセット名を記録しておくとよいでしょう。
商品100件と顧客1,000件、注文10,000件が必要な性能テストでは、自動生成が向いています。
一方で、特定の不具合を再現する数件のデータは、内容を把握しやすい手作業で準備する方法が適しています。
データセットの命名と管理
テストデータは作成後の管理も重要です。
用途がわからないCSVファイルやSQLファイルが増えると、誤ったデータを投入したり、古い条件で検証したりする原因になります。
ファイル名や管理表には、対象機能、環境、作成日、バージョン、利用目的を含めると探しやすくなります。
たとえば会員登録の異常系データ、注文APIの負荷試験データ、月次請求の受入テスト用データのように、用途が伝わる名称が便利です。
テストデータを一度きりの作業成果物ではなく、再利用できる資産として扱うことが理想です。
QAにおけるテストデータ活用と注意点
続いてはQAでテストデータを活用する際の注意点を解説していきます。
QA担当者と開発者の認識合わせ
QA担当者は、テスト観点に合わせて必要なデータを考えます。
一方で開発者は、データベース構造、処理順序、内部的な制約を把握しています。
両者の情報が分かれていると、テストデータの準備に時間がかかったり、想定と異なる状態でテストを始めたりすることがあります。
対象画面だけでなく、前提となる登録状態、権限、連携先の応答、バッチ処理の実行有無まで共有すると、検証が進めやすくなります。
個人情報と機密情報の取り扱い
本番データには、氏名、住所、電話番号、メールアドレス、売上、契約内容などの重要情報が含まれる場合があります。
検証を急ぐあまり、本番データを無加工で開発環境へコピーすることは避ける必要があります。
必要に応じてマスキング、匿名化、置換、アクセス権限の制限を行い、持ち出しや閲覧の範囲を最小限にします。
実データを利用する必要がある場合は、利用目的、保管期間、閲覧者、削除手順を事前に定めます。
データ保護のルールは、品質保証と同じくらい重要な開発プロセスです。
安全なデータ運用ができて初めて、安心して本番に近い検証を行えます。
不具合再現データの保存
不具合が見つかったときは、その問題を再現したテストデータを記録しておくと役立ちます。
再現手順だけでなく、利用したアカウント、登録済みの関連データ、操作順、実行日時、環境情報を残すことで、修正後の確認がしやすくなります。
修正後に同じデータで再テストすれば、現象が解消したかだけでなく、周辺機能へ影響が出ていないかも確認できます。
不具合再現データを蓄積すると、回帰テストのデータセットとしても活用できるでしょう。
再現できるテストデータは、品質改善を継続するための頼れる記録になります。
テストデータ運用のまとめ
テストデータとは、システムやアプリケーションが仕様どおりに動くかを確認するための入力値、登録情報、ファイル、連携データなどの総称です。
サンプルデータは操作例や見本として、ダミーデータは実データの代替として使われることが多く、目的に応じた使い分けが求められます。
テストでは正常系だけでなく、異常系、境界値、権限差、データの状態、関連データの整合性まで考慮することが重要です。
また、個人情報や機密情報を適切に保護し、作成条件や用途を管理することで、安全で再現性の高い検証環境を整えられます。
良いテストデータは、不具合を見つけるだけではありません。
開発、QA、運用の関係者が同じ条件で確認し、品質を継続的に高めるための共通基盤になります。
テストケースとテストデータをセットで設計し、現実的な利用場面を意識した検証につなげていきましょう。