パターンマッチングとは、データの中からあらかじめ定めた条件や規則に合う部分を見つけ出す処理のことです。
検索機能、迷惑メール判定、画像認識、プログラムの分岐処理など、身近なシステムの多くに利用されています。
ただし、対象が文字列なのか画像なのか、完全一致を求めるのか似た特徴を探すのかによって、使うアルゴリズムや精度の考え方は変わります。
この記事では、パターンマッチングの意味、文字列照合の仕組み、正規表現との関係、代表的な具体例までを順に解説します。
パターンマッチングの意味と全体像
それではまずパターンマッチングの意味と全体像について解説していきます。
条件に合う情報を見つける処理
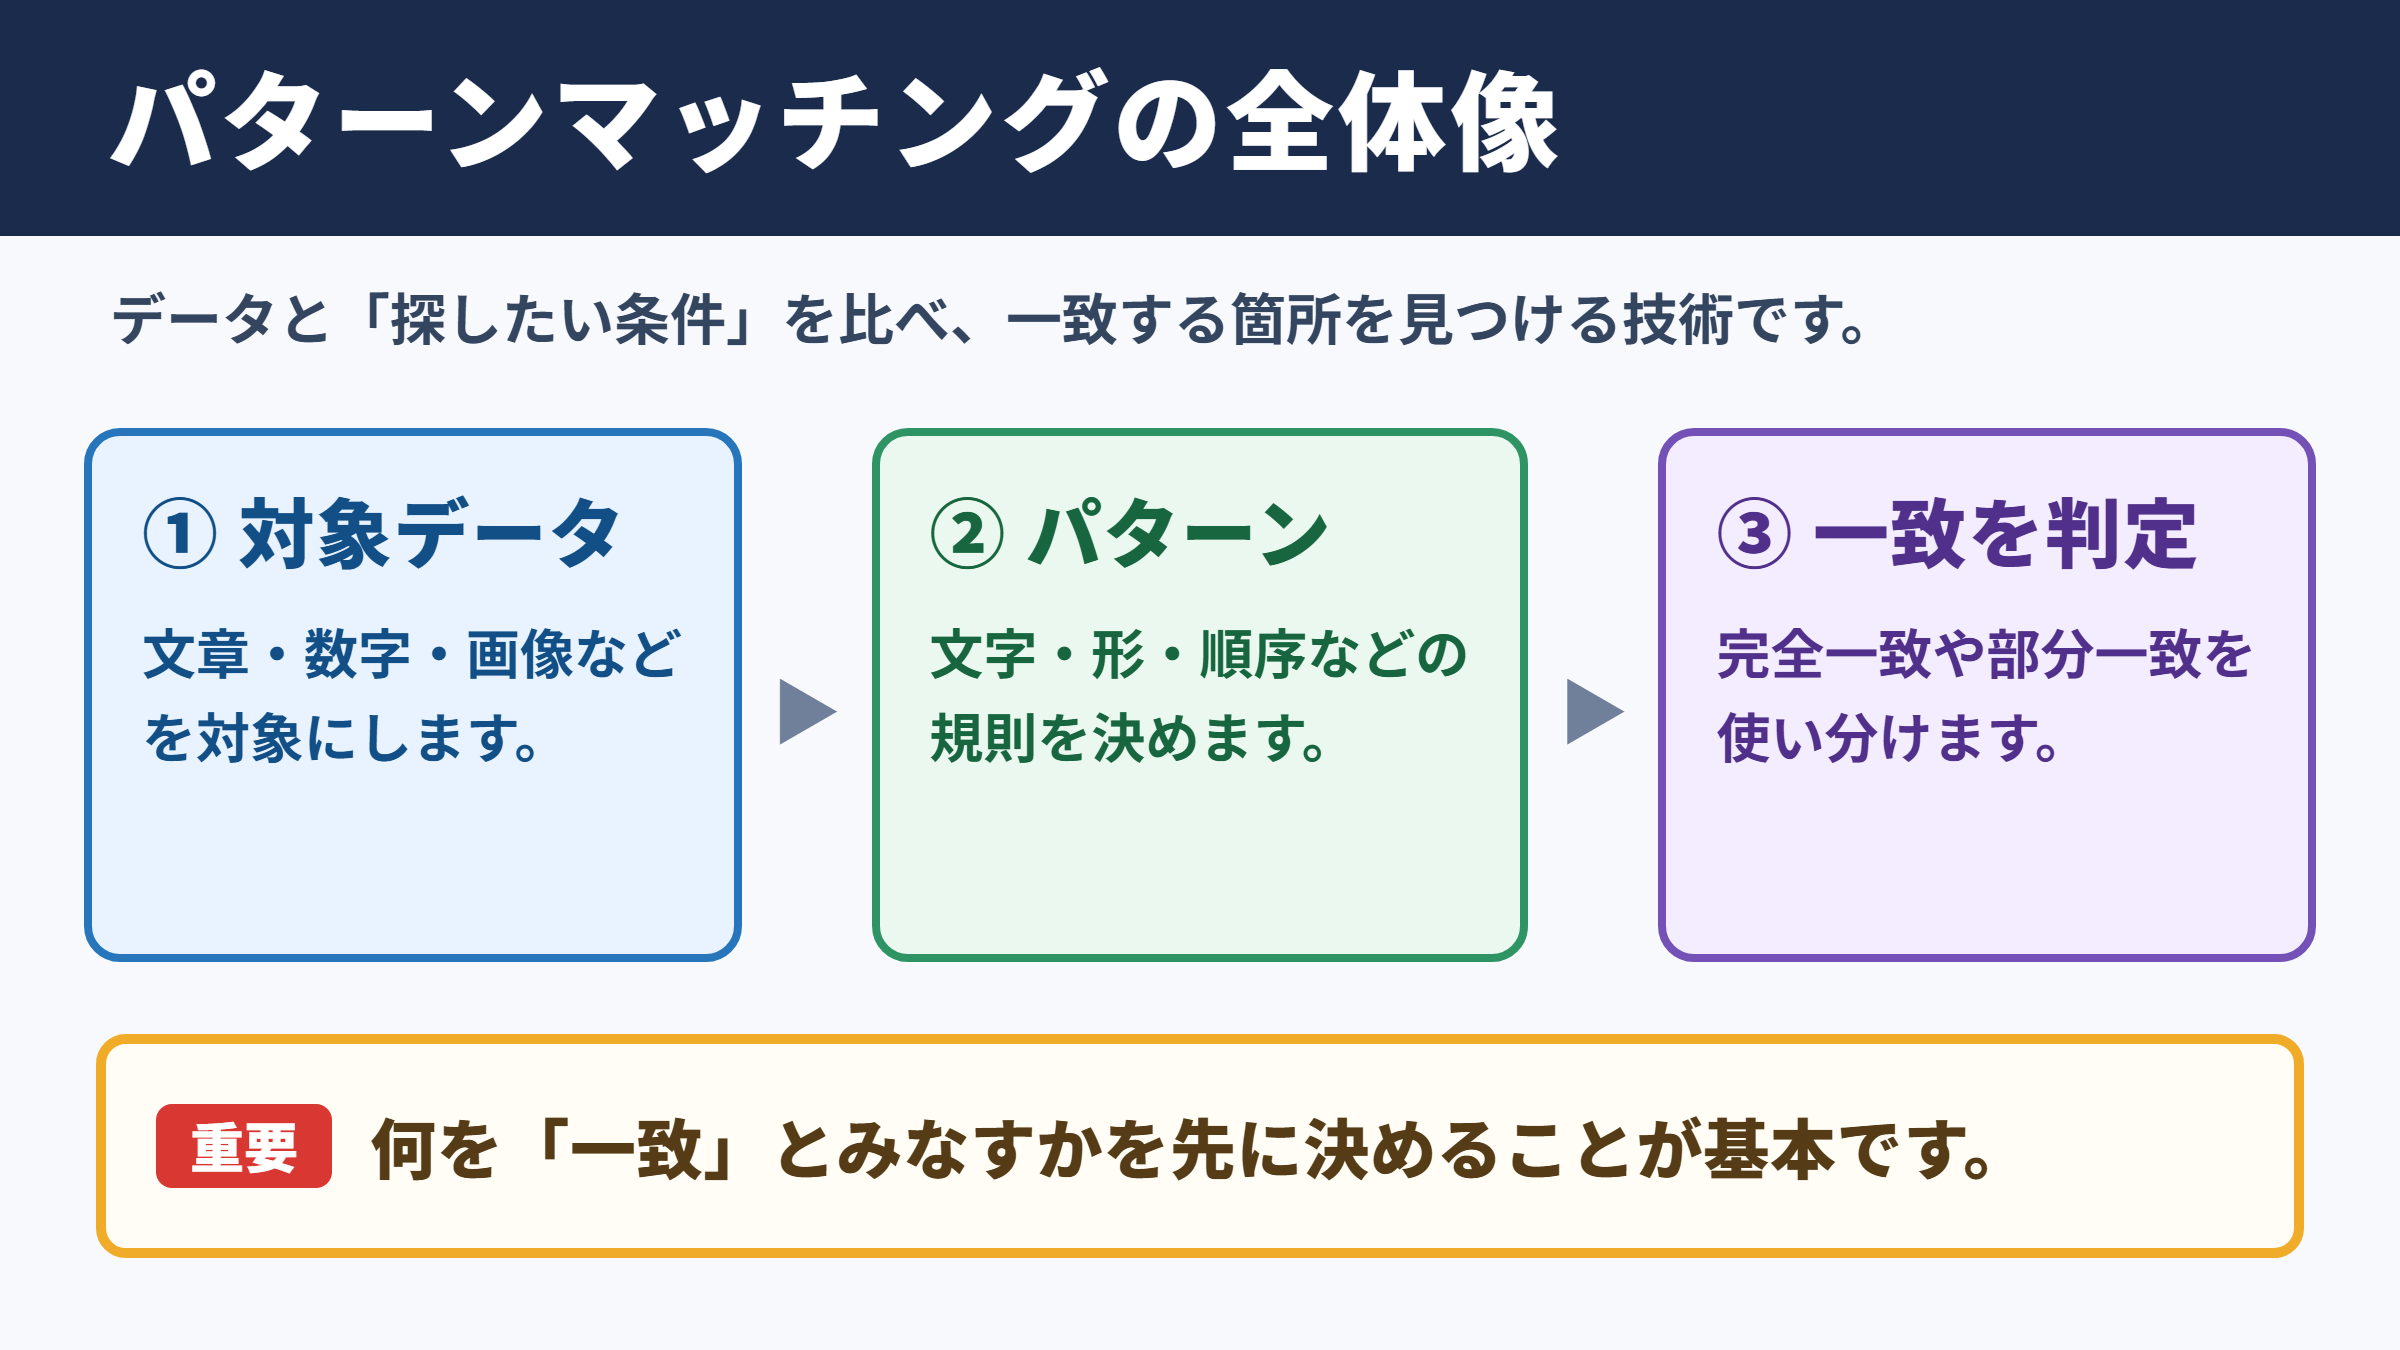
パターンマッチングは、対象となるデータと、探したい条件であるパターンを比較し、一致する箇所を検出する技術です。
たとえば文章の中から特定の単語を探す操作、会員番号が決められた形式か確認する操作、写真から顔らしい領域を見つける操作も、広い意味ではパターンマッチングに含まれます。
ここでいうパターンは、単なる文字の並びだけを指す言葉ではありません。
数字の桁数、記号の位置、音声の特徴、画像の輪郭、商品を購入した順序なども、比較のための規則として扱えます。
対象データの中から意味のある共通点や条件一致を探すことが、パターンマッチングの基本です。
パターンマッチングでは、何を一致とみなすかを先に決めることが重要です。
完全に同じ文字列を探す場合もあれば、多少の違いを許容して似た候補を探す場合もあります。
完全一致と部分一致の違い
完全一致は、検索対象とパターンが先頭から末尾まで同じ場合にだけ一致と判定する方法です。
会員登録時の招待コードや、固定のコマンドを判定する場面では、意図しない一致を避けるために完全一致が向いています。
一方の部分一致は、長い文章やデータの一部にパターンが含まれていれば一致とする考え方です。
サイト内検索で商品名の一部を入力したときに候補が表示される仕組みは、部分一致の分かりやすい例でしょう。
さらに前方一致、後方一致、あいまい一致などを使い分けると、検索結果の利便性と誤検出の少なさを調整できます。
| 一致方法 | 判定の考え方 | 活用例 |
|---|---|---|
| 完全一致 | 対象全体が同じ | 認証コードの照合 |
| 部分一致 | 対象の一部に含まれる | サイト内検索 |
| 前方一致 | 先頭部分が同じ | 入力補完 |
| 後方一致 | 末尾部分が同じ | 拡張子の判定 |
| あいまい一致 | 多少の差異を許容する | 誤字を含む検索 |
検索機能以外での活用範囲
パターンマッチングは検索エンジンだけに使われる技術ではありません。
製造現場では、カメラで撮影した部品画像と基準画像を比較し、傷、欠け、印字ずれなどを検査する画像処理に活用されます。
セキュリティ分野では、不正アクセスに見られる通信の特徴や、既知のマルウェアに似たデータを検出する目的で用いられます。
自然言語処理では、問い合わせ文に含まれる単語や文の構造を照合し、適切な回答候補や担当部署へ振り分ける役割を担います。
同じ技術名でも、扱うデータと一致条件によって実際の処理内容は大きく異なります。
文字列照合の基本構造
続いては文字列照合の基本構造を確認していきます。
文字の順序を比較する仕組み
文字列照合では、検索したい語句であるパターンと、調べる文章であるテキストを順番に比較します。
もっとも単純な方法では、テキストの先頭からパターンと一文字ずつ比べ、不一致になれば比較位置を一つ進めます。
たとえば「営業資料」という文章から「資料」を探す場合、「営」と「資」が異なるため位置を移し、「業」と「資」も異なるため再び移します。
その後、「資」と「資」、「料」と「料」が一致した時点で、パターンが見つかったと判断できます。
小さな文章では十分な方法でも、数百万件のデータや長いログを扱う場合には処理時間が課題になります。
テキストが「abcabcab」、探すパターンが「abc」の場合、先頭から比較すると一致位置は一文字目と四文字目です。
一致箇所を見つけた後も検索を続ければ、複数の候補を取得できます。
照合速度を左右する要素
照合の速度は、テキストの長さ、パターンの長さ、検索回数、利用するアルゴリズムによって変わります。
同じ語句を何度も検索する場合、毎回先頭から比較するだけでは無駄な計算が増えがちです。
そこで、すでに比較した文字の情報を活用し、次に確認する位置を大きく移動させる工夫が使われます。
代表的な手法には、KMP法、Boyer Moore法、Rabin Karp法などがあります。
これらは目的が同じでも、得意な文字列の種類や実装のしやすさ、メモリ使用量に違いがあります。
大量データの検索では、一致率だけでなく応答速度まで設計対象になります。
大文字小文字と表記ゆれの扱い
実務の文字列照合では、文字が同じに見えても内部的には異なる場合があります。
英字の大文字と小文字、全角と半角、ひらがなとカタカナ、旧字体と新字体などが代表例です。
利用者が入力する検索語では表記ゆれが起こりやすいため、比較前に文字を統一する正規化処理を行うことがあります。
たとえば英字を小文字へそろえ、不要な空白を削除してから照合すれば、「Pattern Matching」と「pattern matching」を近い条件で扱えます。
ただし正規化を広げすぎると、本来は区別すべき言葉まで同じものとして処理するおそれがあります。
業務用のデータでは、検索のしやすさと正確な識別のバランスを決めることが大切です。
代表的なアルゴリズムの種類
続いては代表的なアルゴリズムの種類を確認していきます。
単純探索の特徴
単純探索は、テキストの各位置からパターンを順に比較する基本的なアルゴリズムです。
考え方が直感的で、短い文字列の照合や学習用の実装では理解しやすい方法といえます。
一方で、長いテキスト内に似た文字が繰り返される場合、不一致になるたびに多くの文字を比較し直すことがあります。
データ量が少ない処理では、複雑な高速化よりも、単純で保守しやすい設計が適するケースもあります。
処理対象の規模を確認せずに高度なアルゴリズムを選ぶと、実装や検証の負担だけが増えることもあるでしょう。
KMP法による比較回数の削減
KMP法は、パターン内にある繰り返し構造を利用して、すでに比較した文字を無駄に確認し直さないようにする手法です。
途中で不一致が起きても、パターンの一部が一致していた情報を利用し、次に比較すべき位置を判断します。
たとえば同じ文字列の並びがパターン内で繰り返される場合、先頭へ完全に戻らずに照合を継続できます。
事前に対応表を作る必要はあるものの、最悪の場合でも比較回数を抑えやすい点が特徴です。
長い文章を安定して検索したい場面では、比較のやり直しを減らす発想が役立ちます。
パターンが「ABABC」の場合、「AB」が途中で繰り返されています。
KMP法では、この繰り返し情報をあらかじめ保持し、不一致後の比較位置を効率よく決めます。
ハッシュと飛ばし検索の活用
Rabin Karp法は、文字列を数値化したハッシュ値で比較する考え方を利用します。
パターンと同じ長さの文字列ごとにハッシュ値を確認し、値が一致した候補だけを詳しく照合するため、多数のパターンを探す処理に向く場合があります。
Boyer Moore法は、末尾側の文字から比較し、不一致の文字情報を使って比較位置を大きく移動できる点が特徴です。
実際の検索ライブラリでは、こうした考え方を組み合わせた最適化が行われることも少なくありません。
アルゴリズム名を暗記するより、どの情報を再利用して比較回数を減らしているかを理解すると、選定しやすくなります。
正規表現による条件指定
続いては正規表現による条件指定を確認していきます。
正規表現と文字列検索の関係
正規表現は、文字列の並び方を一定の記号ルールで表現する方法です。
固定の単語を探すだけでなく、数字が何桁続くか、特定の文字から始まるか、メールアドレスらしい形式かといった条件を指定できます。
たとえば郵便番号を確認したい場合、数字三桁、ハイフン、数字四桁という形式を一つのパターンとして定義できます。
検索、入力チェック、ログ解析、置換処理などで幅広く使われる理由は、条件を柔軟に記述できる点にあります。
正規表現は文字を探す道具であると同時に、入力形式を判定するルールでもあります。
| 表現例 | 意味 | 利用場面 |
|---|---|---|
| abc | abcという連続文字 | 固定語句の検索 |
| 数字の繰り返し | 連続する数値 | 番号の抽出 |
| 行頭の指定 | 先頭位置から判定 | 接頭語の確認 |
| 行末の指定 | 末尾位置で判定 | 拡張子の確認 |
| 選択条件 | 複数候補のいずれか | 表記ゆれへの対応 |
入力チェックでの具体例
フォームの入力チェックでは、メールアドレス、電話番号、パスワードなどが想定した形式に合うか確認する必要があります。
正規表現を使えば、文字数や使用可能な文字、記号の位置をまとめて判定できます。
ただし、形式が正しいことと、その情報が実際に有効であることは別の問題です。
メールアドレスらしい文字列を判定できても、その受信箱が存在するかまでは通常の正規表現だけでは確認できません。
入力チェックでは、画面上の分かりやすさ、エラー表示、サーバー側での再検証まで含めて考える必要があります。
電話番号の形式確認では、数字とハイフンの位置を条件にできます。
ただし国際番号、内線番号、ハイフンなしの入力を許可するかによって、必要なパターンは変わります。
複雑な正規表現の注意点
正規表現は便利ですが、条件を一つの式へ詰め込みすぎると、保守が難しくなります。
担当者が変わったときに意味を理解できない表現は、修正漏れや誤判定の原因になりやすいでしょう。
特に利用者が自由に入力できる長文に対して複雑な正規表現を実行すると、処理時間が大きく伸びる場合があります。
入力の長さに上限を設ける、単純な条件へ分割する、十分なテストを実施するといった対策が重要です。
正規表現は短く書くことより、意図が安全かつ明確に伝わることを優先します。
具体例から見る活用場面
続いては具体例から見る活用場面を確認していきます。
検索サービスでの商品候補表示
通販サイトで商品名の一部を入力すると、関連する候補が表示される機能があります。
このときは、登録商品名、カテゴリ、説明文、表記ゆれを考慮したパターンマッチングが使われます。
「ワイヤレスイヤホン」と入力した利用者が「ワイヤレス イヤホン」や略称でも商品へたどり着けるようにするには、空白や表記の違いを吸収する処理が必要です。
検索結果を増やしすぎると関係の薄い商品まで出るため、単純な一致だけでなく、語句の重要度や在庫状況を組み合わせることもあります。
利用者が探しているものを少ない入力で見つけられるかどうかは、照合条件の設計に左右されます。
画像認識での特徴量比較
画像のパターンマッチングでは、画素の色だけでなく、輪郭、形状、明るさ、特徴点などを比較します。
工場の外観検査では、良品の基準画像と撮影画像を照合し、位置ずれや異物の有無を判定する方法が使われます。
しかし撮影角度、照明、部品の回転が変わると、同じ製品でも見え方が異なります。
そのため実用的な画像認識では、位置合わせ、明るさ補正、回転への対応、しきい値の調整が欠かせません。
画像の一致判定では、完全に同じ見た目よりも、業務上必要な特徴が一致するかを見極めます。
画像照合の精度を高めるには、基準画像を増やすだけでは不十分です。
撮影環境、対象物のばらつき、不良品として検出したい条件を整理してから判定基準を設計します。
プログラミングにおける分岐処理
プログラミングでは、入力値の形や種類に応じて処理を分けるためにパターンマッチングが使われます。
たとえば注文状態が発送前、発送済み、キャンセル済みのどれかによって、表示する案内や実行する処理を変える場面があります。
文字列の比較だけでなく、データの構造や値の組み合わせに応じて分岐できる言語もあります。
条件分岐を整理すると、複数の入力ケースを読みやすく管理しやすくなります。
一方で条件が重複すると、どの処理が優先されるか分かりにくくなるため、テストケースを用意することが重要です。
精度向上と導入時の注意点
続いては精度向上と導入時の注意点を確認していきます。
一致条件の明確化
パターンマッチングを導入する際は、まず何を見つけたいのかを具体化します。
問い合わせを分類したいのか、不良品を検出したいのか、入力ミスを防ぎたいのかによって、求められる一致条件は異なります。
誤検出を減らすことを優先しすぎると、本来見つけるべき対象を取りこぼす可能性があります。
反対に、候補を広く拾いすぎると、確認作業や不要な通知が増えるでしょう。
正解率だけではなく、見逃しと誤検出のどちらをどこまで許容するかを関係者で共有することが大切です。
テストデータによる検証
照合処理は、正常なデータだけで確認しても十分とはいえません。
誤字、空白の有無、記号の違い、極端に長い入力、想定外の文字コードなどを含めて検証する必要があります。
画像であれば、照明の変化、影、回転、背景の違いを含むサンプルを用意します。
実際の利用環境に近いデータで評価しなければ、開発時には高精度でも運用開始後に誤判定が増えることがあります。
検出結果を記録し、問題の傾向を確認しながら条件を調整する流れが有効です。
性能と保守性の両立
高速なアルゴリズムを採用しても、処理全体が速くなるとは限りません。
データベースからの取得、ネットワーク通信、画像の前処理などが時間を使っている場合、照合部分だけを改善しても効果は限定的です。
運用後に条件を変更する可能性があるなら、ルールの記述場所や変更手順も整えておく必要があります。
難解な正規表現や複雑な判定ロジックには、意図を説明するコメントやテストを残しておくと安心です。
使いやすさ、処理時間、精度、保守のしやすさをまとめて評価することが、長く使える仕組みにつながります。
パターンマッチングの品質は、アルゴリズムだけでは決まりません。
対象データの整備、判定条件の見直し、継続的な検証を組み合わせることで、実務に合った精度へ近づけられます。
パターンマッチングのまとめ
パターンマッチングとは、文字列、画像、音声、データ構造などから、指定した条件に合う情報を探し出す技術です。
文字列照合では完全一致や部分一致を使い分け、データ量が多い場合はKMP法やBoyer Moore法などのアルゴリズムで比較回数を減らします。
正規表現を利用すれば、固定の語句だけでなく、入力形式や表記ルールまで柔軟に判定できます。
検索機能、画像検査、セキュリティ対策、プログラムの分岐処理など、活用範囲は幅広いものです。
重要なのは、何を一致とみなすのかを明確にし、実際のデータで精度と速度を検証することです。
目的に合ったパターンとアルゴリズムを選び、表記ゆれや例外ケースにも配慮すれば、利用者にとって便利で信頼できる仕組みを作りやすくなるでしょう。