openid-clientとは?特徴や役割をわかりやすく解説!(Node.jsライブラリ:OpenID Connect:認証フロー:概要など)
openid-clientは、Node.jsをはじめとするJavaScript実行環境で、OpenID Connectによるログイン機能を実装する際に役立つライブラリです。
GoogleやMicrosoft、Auth0、Keycloakなどの認証基盤と連携し、IDトークンの検証や認可コードの交換といった処理を、安全性に配慮しながら組み立てられます。
認証処理は画面上ではシンプルに見えても、裏側にはリダイレクト、署名検証、トークン管理、状態値の照合など、多数の要素があります。
本記事ではopenid-clientの役割、OpenID Connectの基本、Node.jsでの認証フロー、導入時の注意点までを順に解説します。
openid-clientの概要と役割
それではまずopenid-clientの概要と役割について解説していきます。
OpenID Connectクライアント機能
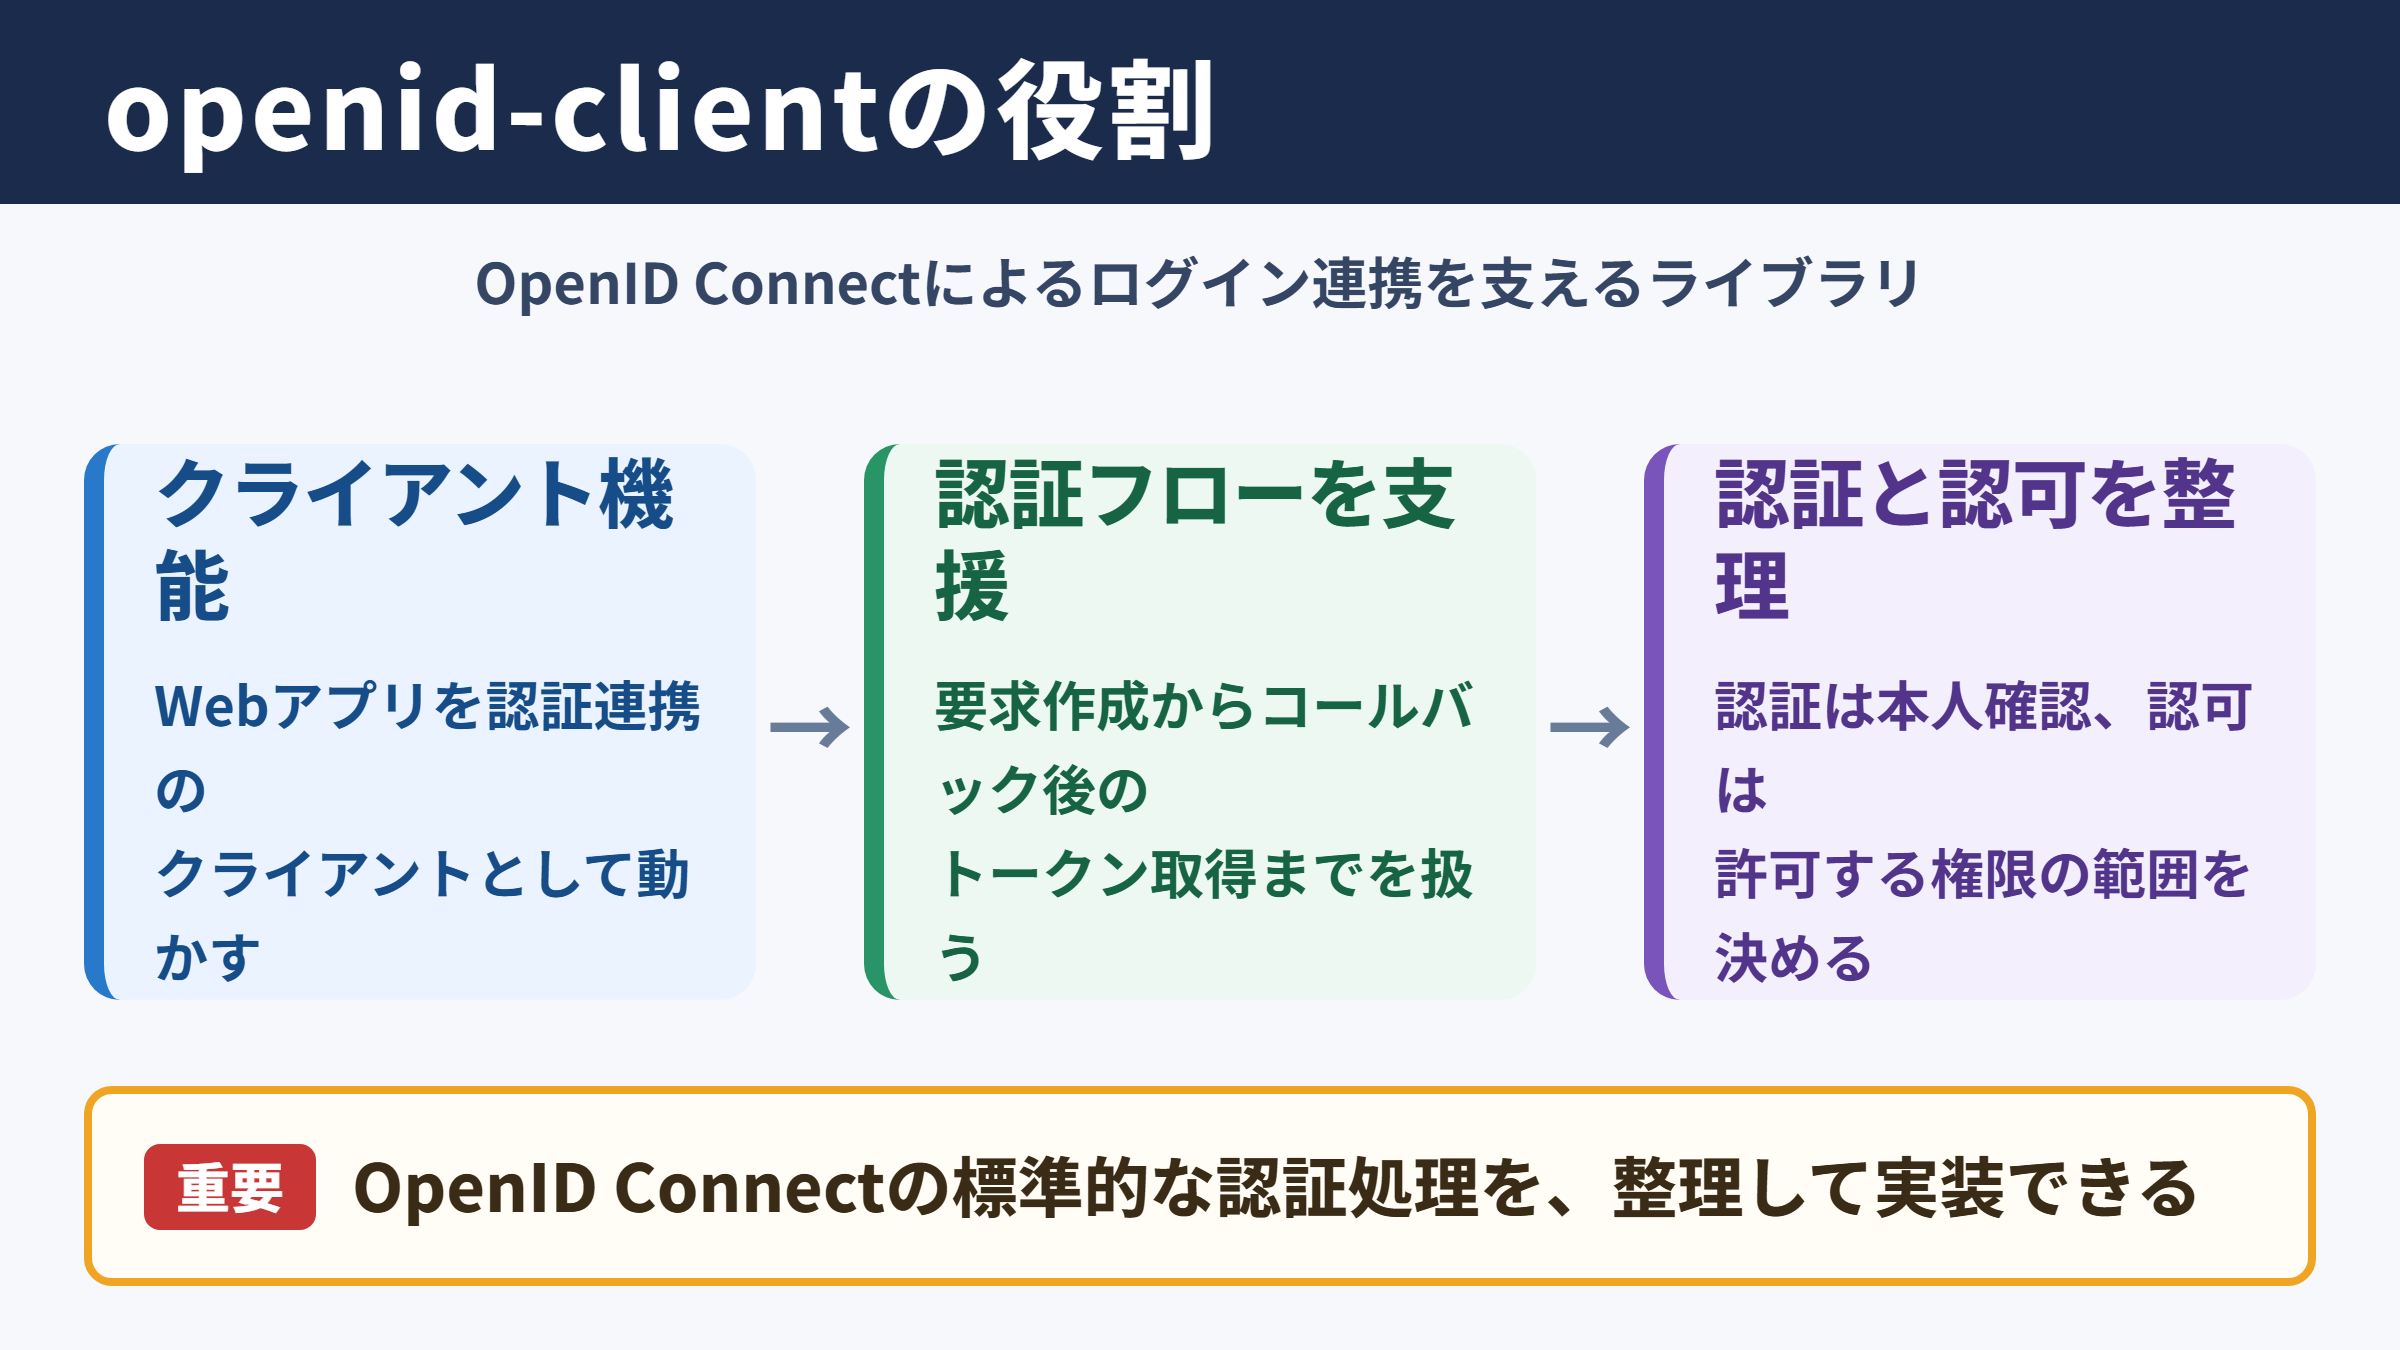
openid-clientは、アプリケーション側をOpenID Connectのクライアントとして動作させるためのライブラリです。
利用者の本人確認を自前で実装するのではなく、認証を担当するプロバイダーへ処理を委ね、アプリケーションは認証結果を受け取る構成を作れます。
ここでいうクライアントは、ブラウザそのものではなく、認証サービスと連携するWebアプリケーションやバックエンドを指します。
openid-clientの中心的な役割は、OpenID Connectの仕様に沿って認証要求とトークン検証を扱いやすくすることです。
認証サーバーのエンドポイント情報を取得し、認可リクエストを作成し、コールバック後にトークンを受け取るまでの流れを支援します。
仕様書を直接読みながらHTTPリクエストをすべて組み立てる方法もありますが、細かな見落としが起きやすくなります。
ライブラリを使うことで、標準的な認証フローに必要な部品を整理しやすくなるでしょう。
認証と認可の違い
openid-clientを理解するうえでは、認証と認可を区別することが重要です。
認証は、アクセスしている人が誰であるかを確認する処理です。
一方の認可は、その人やアプリケーションにどの範囲の操作を許可するかを決める処理になります。
| 用語 | 確認する内容 | 代表的な成果物 |
|---|---|---|
| 認証 | 利用者本人であるか | IDトークン |
| 認可 | 許可された権限の範囲 | アクセストークン |
| 識別子 | 利用者を一意に示す情報 | subクレーム |
| セッション | ログイン状態を維持する情報 | Cookieやサーバー側保存情報 |
OpenID ConnectはOAuth 2.0を基盤に、利用者の識別情報を扱う仕組みを加えた規格です。
そのため、ログイン機能ではIDトークンを使い、外部APIの利用権限ではアクセストークンを使うという整理がよく行われます。
IDトークンとアクセストークンは用途が異なるため、同じものとして扱わないことが大切です。
Node.jsアプリケーションでの利用場面
Node.jsでは、ExpressやFastify、Next.jsなどを使ったWebアプリケーションにopenid-clientを組み込むケースが代表的です。
ログイン画面の代わりに外部の認証サービスへ移動し、認証後にアプリケーションへ戻す仕組みを実装できます。
社内システムでシングルサインオンを導入したい場面、会員サイトで外部IDログインを提供したい場面、管理画面へのアクセスを統一したい場面にも向いています。
認証機能を独自開発すると、パスワードの保管やリセット、二要素認証、アカウントロックなどの運用負担が増えます。
信頼できるIDプロバイダーと連携すれば、こうした領域の一部を認証基盤へ任せられます。
openid-clientはログイン画面を自動で完成させる製品ではありません。
認証プロバイダーとの通信、トークン取得、検証のためのライブラリであり、アプリケーション側ではセッション設計や権限制御も必要です。
OpenID ConnectとOAuthの仕組み
続いてはOpenID ConnectとOAuthの仕組みを確認していきます。
認証プロバイダーとの連携構造
OpenID Connectでは、利用者、アプリケーション、認証プロバイダーの三者が関わります。
利用者はログインを開始し、アプリケーションは認証プロバイダーへ認証を依頼します。
認証プロバイダーはログイン状況や本人確認の結果を確認し、問題がなければアプリケーションへ認可コードを返します。
アプリケーションはそのコードを使ってトークンを取得し、利用者のログイン状態を作成します。
パスワードをアプリケーションが直接受け取らない構成にできる点は、外部認証を採用する大きな利点です。
ただし、認証プロバイダーへ移動するURLや戻り先URLを正しく制御しなければ、セキュリティ上の問題につながります。
ディスカバリー情報の取得
OpenID Connect対応の認証プロバイダーは、ディスカバリー情報を公開していることがあります。
これは認可エンドポイント、トークンエンドポイント、鍵情報の取得先、対応するスコープなどをまとめた設定情報です。
openid-clientでは、この情報を参照して認証サーバーとの通信設定を組み立てられます。
環境ごとにURLを手入力するよりも、公開設定を利用するほうが設定漏れを減らしやすいでしょう。
ただし、社内向け認証基盤や特殊な構成では、ディスカバリー情報のURL、発行者情報、証明書設定を個別に確認する必要があります。
代表的なディスカバリーURLの形は、認証基盤のURLの末尾にwell-knownの設定パスを付けたものです。
実際のURLはプロバイダーごとに異なるため、公式ドキュメントに記載された発行者URLを基準に確認します。
スコープとクレームの関係
スコープは、アプリケーションが認証プロバイダーへ要求する情報や権限の範囲です。
OpenID Connectではopenidスコープが基本となり、profile、email、addressなどを追加すると、取得できる利用者情報が増える場合があります。
クレームは、IDトークンやUserInfoレスポンスに含まれる利用者情報の項目です。
たとえばsubは利用者を識別する値、emailはメールアドレス、nameは表示名として扱われることがあります。
必要以上のスコープを要求せず、目的に必要な情報だけを受け取る設計が望まれます。
メールアドレスをユーザーIDの代わりに固定的に保存すると、変更や未検証の状態に対応しにくくなります。
内部の利用者識別子には、通常はプロバイダーが発行する安定したsubject識別子を利用する考え方が安全です。
認可コードフローの流れ
続いては認可コードフローの流れを確認していきます。
ログイン開始から認可リクエスト
認可コードフローは、Webアプリケーションで広く使われる認証フローです。
まず利用者がログインボタンを押すと、アプリケーションは認証プロバイダーへ移動するための認可URLを作成します。
URLにはクライアントID、リダイレクトURI、要求するスコープ、レスポンスタイプなどが含まれます。
さらにstateやnonce、PKCE関連の値を生成し、後続処理で照合できるように保存します。
認可リクエストには、クライアントID、リダイレクトURI、scope、state、nonce、code_challengeなどが含まれます。
これらの値は単なる付加情報ではなく、要求の対応付けやトークンの不正利用防止に関わる重要な項目です。
openid-clientを用いると、ライブラリが求める形式に沿ってこれらの値を生成、利用しやすくなります。
ただし、生成した値をどこに保存し、いつ破棄するかはアプリケーションの責任範囲です。
コールバックとトークン交換
認証プロバイダーでログインが完了すると、利用者のブラウザは事前に登録したリダイレクトURIへ戻ります。
このとき、URLには短時間だけ使える認可コードが含まれます。
アプリケーションは認可コードを受け取り、トークンエンドポイントへ送信してIDトークンやアクセストークンを取得します。
コード交換ではクライアント認証やPKCE検証が関わるため、認証サーバーの設定とライブラリ側の設定を一致させる必要があります。
認可コードはブラウザ経由で渡されても、トークンそのものをURLに載せにくい設計が認可コードフローの特徴です。
認可コードを受け取っただけでログイン完了と判断せず、必ずトークン交換と検証を行います。
stateとnonceとPKCEの役割
stateは、ログイン開始時の要求とコールバックを結び付けるためのランダム値です。
コールバック時に保存済みのstateと一致するかを確認することで、意図しない認証応答を受け入れるリスクを抑えます。
nonceは、主にIDトークンとの対応付けに使われる値で、トークンの再利用対策に役立ちます。
PKCEは、認可コードを横取りされても第三者がトークン交換しにくくする仕組みです。
| 項目 | 主な目的 | 確認するタイミング |
|---|---|---|
| state | リクエストの対応付けとCSRF対策 | コールバック受信時 |
| nonce | IDトークンの再利用対策 | IDトークン検証時 |
| code verifier | PKCEによるコード横取り対策 | トークン交換時 |
| redirect URI | 認証結果の送信先制御 | 認可要求と交換処理 |
state、nonce、PKCEの検証を省略すると、認証フローの安全性が大きく下がります。
値は予測されにくいものを使い、セッションなど利用者ごとに分離された場所で一時保管することが重要です。
openid-clientの導入と実装設計
続いてはopenid-clientの導入と実装設計を確認していきます。
クライアント登録と環境変数
openid-clientを利用する前に、認証プロバイダー側でアプリケーションをクライアントとして登録します。
登録時にはクライアントID、クライアントシークレット、許可するリダイレクトURI、ログアウト後の遷移先などを設定するのが一般的です。
クライアントシークレットは認証情報の一種なので、ソースコードへ直接書き込むべきではありません。
開発環境、検証環境、本番環境で値を分け、環境変数や安全なシークレット管理サービスで扱います。
リダイレクトURIは完全一致で判定されることが多く、末尾のスラッシュやプロトコルの違いにも注意が必要です。
本番環境ではHTTPSを前提にし、ローカル開発用のURLを誤って許可し続けないよう管理します。
セッションと利用者情報の保存
トークン取得後は、アプリケーション独自のログイン状態をどう維持するかを設計します。
よくある方法は、サーバー側にセッション情報を保存し、ブラウザにはセッションIDだけをCookieとして持たせる構成です。
この場合、アクセストークンやリフレッシュトークンをブラウザへ直接露出させずに済みます。
利用者テーブルには、発行者情報とsubject識別子の組み合わせを保存する方法がよく採用されます。
複数の認証プロバイダーを扱う場合でも、同じsubという文字列だけでは重複の可能性があります。
ログイン済みかどうかの判定と、外部APIを呼ぶためのアクセストークン管理は別の設計課題です。
ログインセッションに必要な情報を最小限に絞り、トークンは暗号化やアクセス制御を考慮して保存します。
エラー処理とログ設計
認証処理では、利用者がログインを中断した場合、許可を拒否した場合、コールバックの値が不正な場合などを想定します。
エラー画面で認証サーバーから返された詳細をそのまま表示すると、内部情報を見せてしまうおそれがあります。
利用者には分かりやすい案内を表示し、詳細はサーバーログに記録する方法が適しています。
ログには発生時刻、要求ID、エラー種別、認証プロバイダー名などを残すと、障害調査が進めやすくなります。
一方で、IDトークン、アクセストークン、クライアントシークレット、Cookieの内容をログ出力してはいけません。
認証情報そのものをログに残さないことは、実装後の運用でも守るべき基本事項です。
トークン検証とセキュリティ対策
続いてはトークン検証とセキュリティ対策を確認していきます。
IDトークンの検証項目
IDトークンは一般にJWT形式で発行され、ヘッダー、ペイロード、署名から構成されます。
見た目だけで内容を読める場合があっても、デコードできたことは正当性を確認できたことにはなりません。
署名、発行者、対象者、有効期限、nonceなどを確認し、信頼できる認証プロバイダーが発行したトークンかを判断します。
| 検証対象 | 確認する理由 | 不備がある場合の対応 |
|---|---|---|
| 署名 | 改ざんされたトークンを防ぐため | 認証を中止する |
| iss | 想定した発行者か確認するため | 発行者設定を見直す |
| aud | 自アプリケーション向けか確認するため | クライアントIDを確認する |
| exp | 期限切れを防ぐため | 再認証や更新を促す |
| nonce | 要求との対応を確かめるため | セッションを破棄する |
JWTを単に分解してpayloadを読むだけでは、認証済みの利用者として扱えません。
openid-clientの検証機能を活用しつつ、アプリケーションの想定する発行者とクライアント情報を明確に設定します。
アクセストークンとリフレッシュトークン
アクセストークンは、認可されたAPIへアクセスするために使われます。
IDトークンをAPI認可の目的で流用するのではなく、対象APIが求める形式のアクセストークンを使用することが基本です。
リフレッシュトークンは、短命なアクセストークンを更新するために利用されることがあります。
便利な一方で、漏えい時の影響が長く続く可能性があるため、保管方法と失効方法を慎重に設計する必要があります。
アクセストークンの有効期限が短く、リフレッシュトークンの有効期限が長い構成では、後者の保護が特に重要になります。
更新処理に失敗した場合は、無限に再試行するのではなく、再ログインへ誘導する条件を決めておくと安全です。
Cookieとリダイレクトの防御
セッションCookieには、Secure、HttpOnly、SameSiteなどの属性を適切に設定します。
SecureはHTTPS通信でのみCookieを送る設定であり、HttpOnlyはJavaScriptからの読み取りを制限する設定です。
SameSiteはクロスサイト送信を制御するために役立ちますが、外部認証から戻るリダイレクトとの相性を確認する必要があります。
認証フローが成立することだけを確認して設定を緩めると、別の攻撃経路を作ることになりかねません。
許可するリダイレクト先を固定し、任意のURLへ遷移できる実装を避けることも重要です。
認証後の遷移先をURLパラメーターで受け取る場合は、アプリケーション内の許可済みパスだけを選べるようにします。
外部サイトのURLをそのまま受け入れると、フィッシングにつながるオープンリダイレクトが発生するおそれがあります。
openid-client導入時の確認事項
続いてはopenid-client導入時の確認事項を確認していきます。
ライブラリのバージョンと実行環境
openid-clientはバージョンによってAPIの設計や対応するJavaScript実行環境が変わることがあります。
古いサンプルコードをそのまま採用すると、現在のパッケージ構成やモジュール方式と合わない場合があります。
導入前には、利用するバージョンの公式ドキュメント、Node.jsの対応バージョン、ESMとCommonJSの扱いを確認します。
フレームワーク側のルーティング方式やサーバーレス環境の制約も、コールバック処理に影響します。
特に複数インスタンスで動く環境では、stateやPKCEの一時情報をどこに保存するかが課題になります。
メモリだけに保存すると、別のインスタンスへコールバックが届いた際に照合できないことがあるためです。
認証基盤ごとの設定差
OpenID Connectは標準規格ですが、管理画面の項目名、許可設定、追加クレーム、ログアウト機能などは認証基盤ごとに異なります。
Googleログイン、Microsoft Entra ID、Auth0、Keycloak、企業独自のIDプロバイダーでは、設定画面や必要な権限付与の手順に違いがあります。
まずは認証基盤が提供するディスカバリー情報とクライアント登録の内容を確認し、最小構成でログインできる状態を作るとよいでしょう。
その後にメールアドレス取得、グループ連携、外部API連携などの要件を追加すると、問題の切り分けがしやすくなります。
ライブラリの問題に見えても、認証プロバイダーのリダイレクトURI設定や同意設定が原因であることは少なくありません。
テストと運用監視
認証機能のテストでは、正常なログインだけでなく、拒否、期限切れ、不正なstate、失効済みトークンなども確認対象に含めます。
本番用の認証設定を開発中に直接変更すると利用者へ影響するため、可能であれば検証用テナントや検証用クライアントを用意します。
監視ではログイン成功率、コールバックエラー数、トークン交換失敗数、認証プロバイダーへの通信時間などを観察します。
急に失敗率が上がった場合は、証明書や鍵情報の更新、認証基盤の設定変更、アプリケーションのデプロイを確認する流れが有効です。
障害時にログイン処理を無効化するのか、既存セッションだけを維持するのかも、事前に運用方針として決めておくと安心です。
まとめ
openid-clientは、Node.jsアプリケーションをOpenID Connectのクライアントとして実装するためのライブラリです。
認可コードフロー、ディスカバリー情報、トークン交換、IDトークン検証などを扱いやすくし、外部認証基盤との連携を支えます。
導入時には、クライアント登録、リダイレクトURI、state、nonce、PKCE、セッション保存、トークン管理を一つの流れとして設計することが重要です。
認証が成功することと、安全な認証実装であることは別の課題と考え、署名検証やCookie設定、ログの取り扱いまで確認しましょう。
openid-clientとOpenID Connectの役割を正しく理解すれば、ログイン機能をより保守しやすく、安全性にも配慮した形で構築しやすくなります。