検索エンジン、迷惑メールフィルタ、医療診断、画像認識などでは、対象を正しく見つける性能を評価する必要があります。
そのときに重要となる指標が、適合率と再現率です。
どちらも正解率に近い言葉に見えますが、注目している範囲が異なります。
適合率は選んだものがどれだけ正しいかを示し、再現率は本来選ぶべきものをどれだけ取りこぼさずに選べたかを表します。
本記事では、混同行列との関係、具体例、トレードオフ、目的別の使い分けまで順番に整理します。
適合率と再現率の基本概念
それではまず適合率と再現率について解説していきます。
適合率が示す予測結果の正しさ
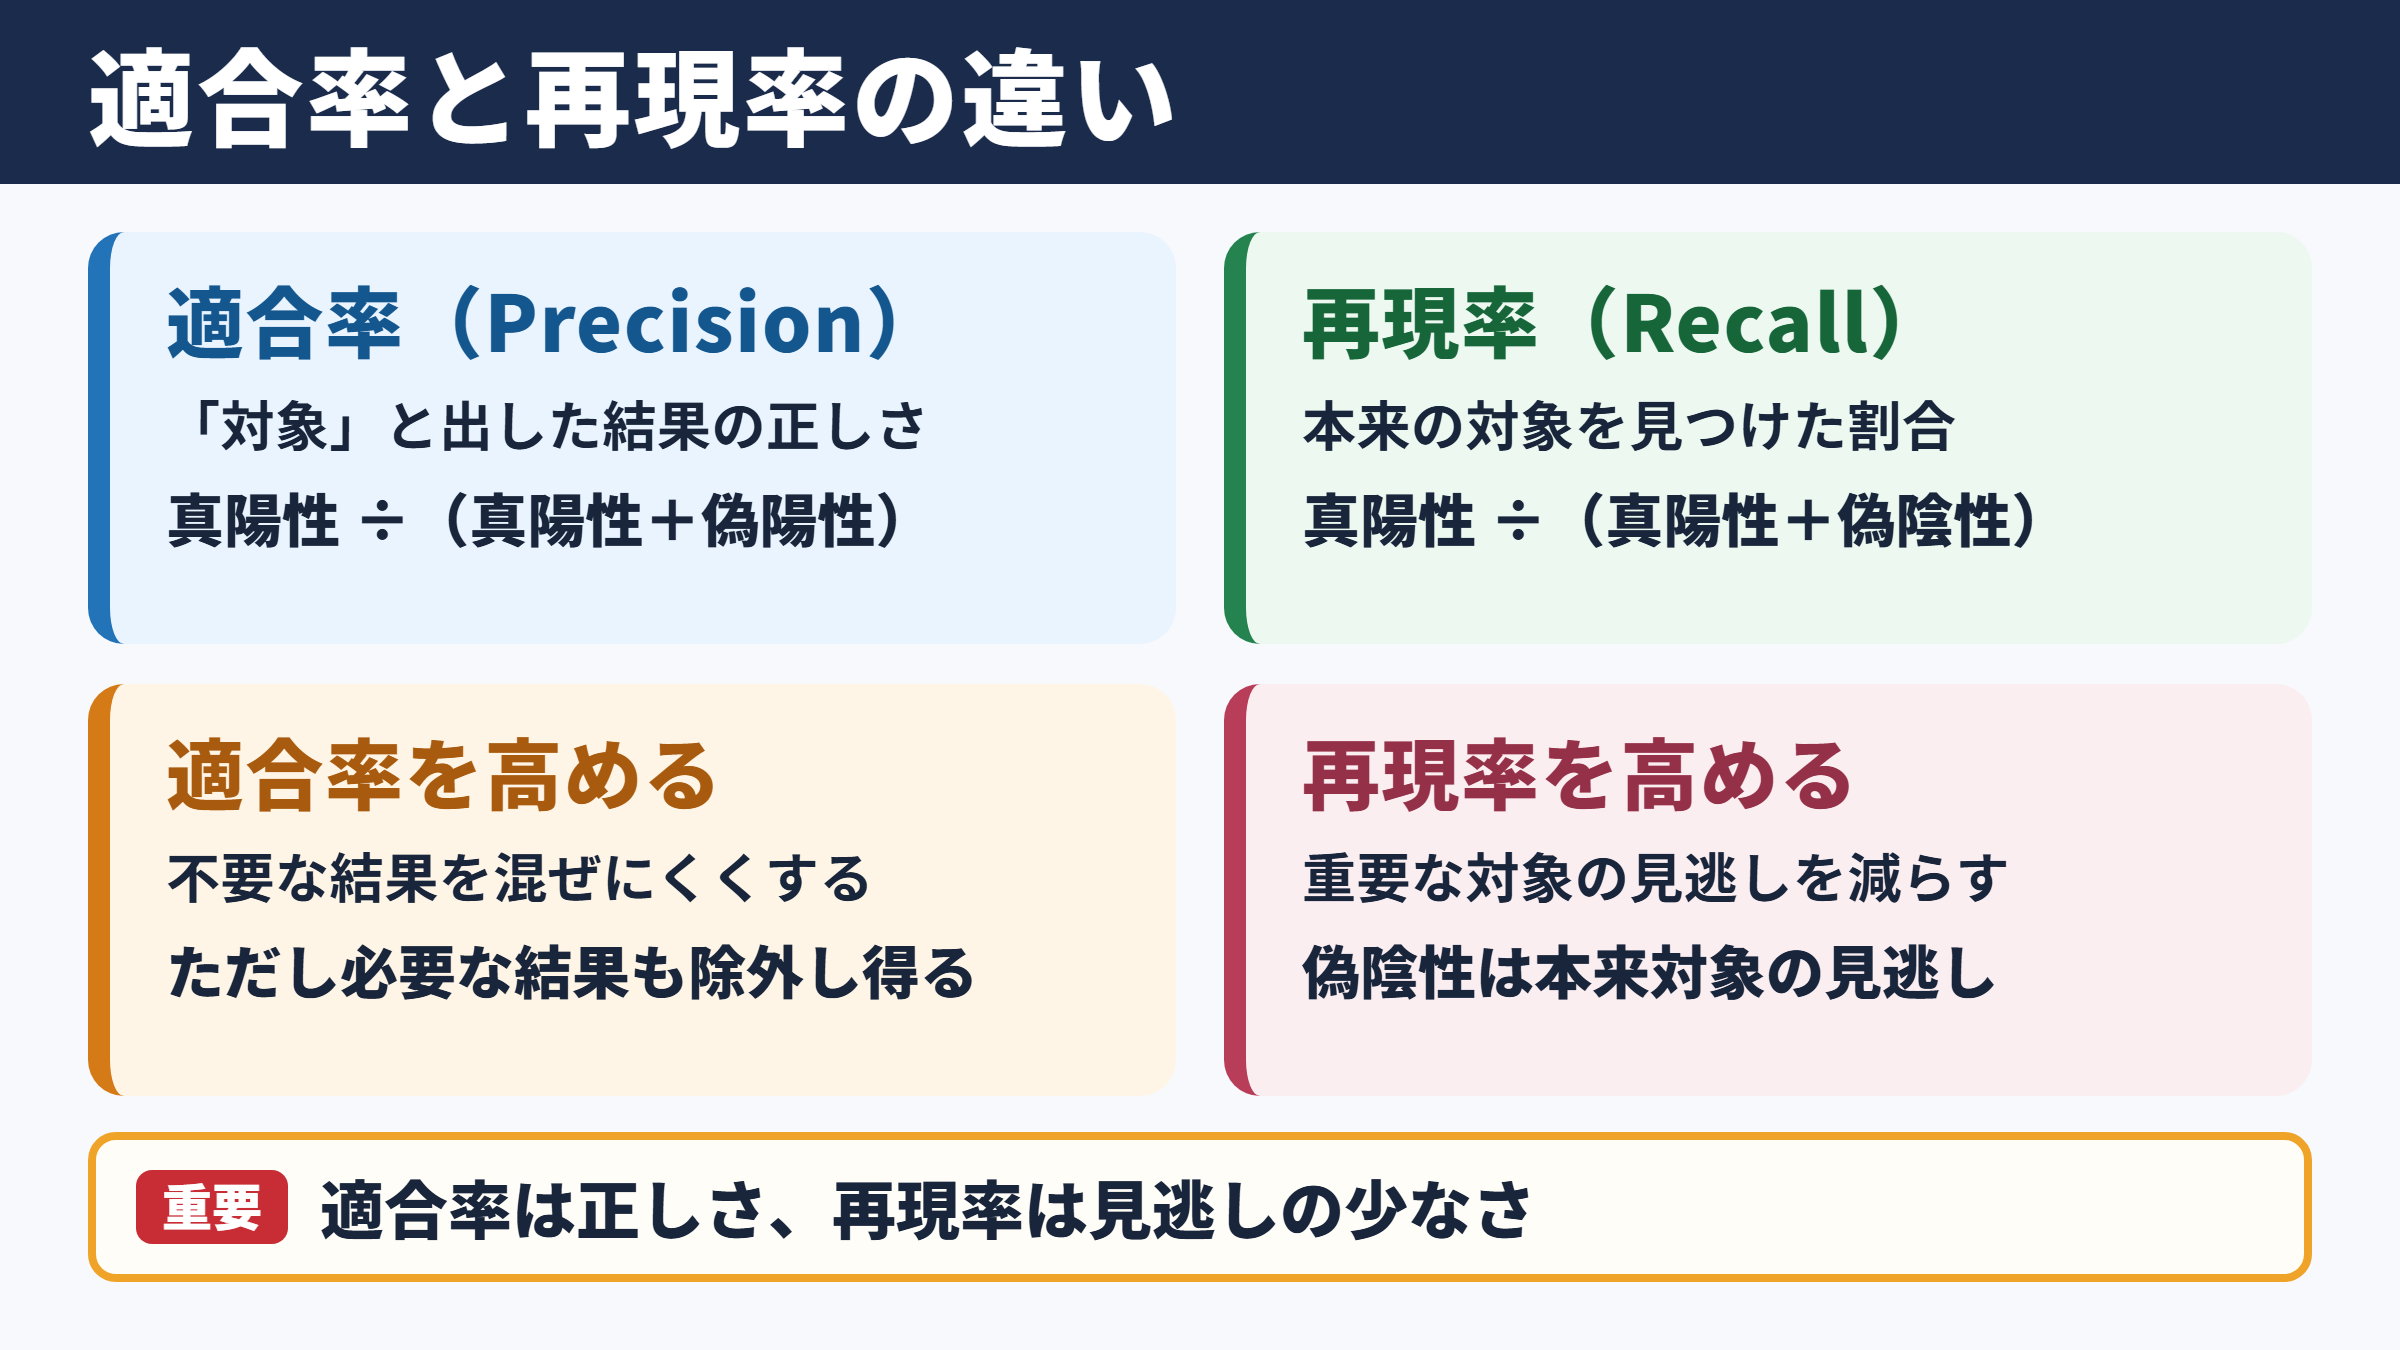
適合率は、システムが「対象である」と判定したもののうち、実際に対象だった割合です。
英語ではPrecisionと呼ばれ、検索、分類、検出などの精度を確認するために使われます。
たとえば、あるメールフィルタが迷惑メールだと判定した100通のうち、90通が本当に迷惑メールだった場合、適合率は90パーセントです。
この数値が高いほど、判定結果に余計な対象が混ざりにくい状態といえるでしょう。
適合率の式は、正しく対象と判定した数を、対象と判定した総数で割る考え方です。
適合率 = 真陽性 ÷ 真陽性と偽陽性の合計
真陽性は、本当に対象であり、システムも対象と判定した件数です。
一方の偽陽性は、本来は対象ではないのに、誤って対象だと判定した件数を意味します。
適合率を高めるほど、不要な結果を利用者へ見せにくくなります。
ただし、厳しく絞り込みすぎると、必要な結果まで除外してしまう可能性があります。
再現率が示す見逃しの少なさ
再現率は、本来対象であるもののうち、システムが実際に対象として見つけられた割合です。
英語ではRecallと呼ばれ、漏れなく候補を集めたい場面で特に重視されます。
たとえば、データの中に迷惑メールが120通あり、そのうち90通を迷惑メールとして検出できた場合、再現率は75パーセントです。
残る30通は見逃しであり、利用者の受信トレイへ届く可能性があります。
再現率の式は、正しく対象と判定した数を、本来対象である総数で割る考え方です。
再現率 = 真陽性 ÷ 真陽性と偽陰性の合計
偽陰性は、本来は対象であるにもかかわらず、対象ではないと判定された件数です。
再現率を高める目的は、重要な対象の取りこぼしを減らすことにあります。
見逃しが深刻な損失につながる業務では、再現率の低さを見過ごせません。
正解率だけでは判断できない理由
分類モデルを評価するとき、正解率だけで十分だと考えられることがあります。
しかし、対象となるデータが極端に少ない場合、正解率は実態より良く見えることがあります。
たとえば、1万件の取引のうち不正取引が100件だけだとします。
すべてを正常と判定しても、正解率は99パーセントになります。
それでも不正取引を1件も検出できていなければ、監視システムとしての価値は低いでしょう。
対象データが少ない不均衡データでは、正解率だけで性能を判断しないことが大切です。
適合率と再現率を並べて確認すると、誤検知と見逃しの両方を具体的に評価できます。
特に機械学習、異常検知、医療検査、採用候補の抽出では、指標の選び方が運用結果を左右します。
混同行列による判定結果の整理
続いては判定結果を整理する混同行列を確認していきます。
真陽性と偽陽性の意味
混同行列は、実際の状態と予測結果を組み合わせて分類する表です。
まず真陽性は、対象であるものを正しく対象として判定した結果を指します。
たとえば病気のある人を陽性と判定できた場合や、不正取引を不正として検知できた場合が該当します。
偽陽性は、対象ではないものを対象だと誤判定した結果です。
迷惑メールではないメールを迷惑メールフォルダへ入れる事例が、わかりやすい例でしょう。
| 実際の状態 | 予測が対象 | 予測が対象外 |
|---|---|---|
| 実際に対象 | 真陽性 | 偽陰性 |
| 実際に対象外 | 偽陽性 | 真陰性 |
適合率は、表の中で予測が対象となった列に注目する指標です。
この列に偽陽性が多いほど、適合率は下がります。
偽陰性と真陰性の意味
偽陰性は、実際には対象であるものを対象外と見なした結果です。
がん検診で病気がある人を陰性と判定することや、危険な投稿を見逃すことが例に挙げられます。
真陰性は、実際に対象外であるものを正しく対象外と判定した結果です。
正常な取引を正常と認識できた場合は、真陰性に分類されます。
再現率は、本来対象である行のうち、真陽性がどれほど占めるかを見る数値です。
そのため偽陰性を減らすほど、再現率は高くなります。
一方で、対象を広く拾おうとすると、偽陽性が増えやすい点には注意が必要です。
具体的な数値による計算例
1000件のメールから、実際には100件の迷惑メールが見つかったとします。
フィルタは120件を迷惑メールと判定し、そのうち80件は正しく迷惑メールでした。
このとき真陽性は80件、偽陽性は40件、偽陰性は20件です。
適合率は80 ÷ 120で、およそ66.7パーセントです。
再現率は80 ÷ 100で、80パーセントです。
| 項目 | 件数 | 評価上の意味 |
|---|---|---|
| 真陽性 | 80件 | 正しく迷惑メールを検出 |
| 偽陽性 | 40件 | 通常メールを誤って除外 |
| 偽陰性 | 20件 | 迷惑メールを見逃し |
| 適合率 | 66.7パーセント | 検出結果の信頼性 |
| 再現率 | 80パーセント | 迷惑メールの捕捉率 |
この例では再現率が比較的高く、迷惑メールの見逃しは抑えられています。
ただし、120件のうち40件が通常メールであるため、適合率には改善の余地があります。
トレードオフの関係
続いては適合率と再現率に生じるトレードオフを確認していきます。
判定しきい値が与える影響
多くの機械学習モデルは、対象である確率やスコアを出力します。
そのスコアが一定の基準を超えたものを対象と判定する仕組みが、しきい値です。
しきい値を高くすると、確信度の高いものだけが選ばれます。
その結果、偽陽性は減りやすく、適合率は上がりやすくなります。
しかし、対象であってもスコアが基準に届かないものが増えるため、再現率は下がりやすくなります。
反対に、しきい値を低くすれば候補を広く拾えるため、再現率は上がりやすい傾向です。
しきい値の調整は、適合率と再現率の優先順位を運用方針へ反映する作業です。
検索結果におけるバランス
Web検索を考えると、適合率と再現率の違いを理解しやすくなります。
特定の技術用語を検索した利用者は、関連性の高いページを上位に見たいはずです。
関連の薄いページが大量に表示されれば、適合率が低い検索結果といえます。
一方で、非常に有益なページが検索結果に出てこなければ、再現率が低い状態です。
検索エンジンでは、すべてのページを表示するのではなく、順位付けも含めて満足度を最適化します。
そのため単純な件数だけではなく、上位表示された結果の質も大切になります。
検索では、最初の数件に不要な結果を混ぜない適合率と、必要な情報源を漏らさない再現率の両方が重要です。
利用者の検索意図、検索語の曖昧さ、表示件数に合わせて評価基準を考える必要があります。
業務コストから考える優先順位
どちらを優先するかは、誤検知と見逃しによるコストを比べて決めます。
たとえば、危険物の検査で見逃しが事故につながる場合は、再現率を優先する判断が自然です。
多少の誤検知があっても、人による再確認を挟めばリスクを抑えられるでしょう。
反対に、高額な人手調査が必要な不正検知では、誤検知が多すぎると業務が止まります。
その場合は、適合率を高めて調査対象を絞る意義が大きくなります。
正しい指標は一つではなく、誤判定の後に何が起きるかで変わります。
数値の改善だけを目的にせず、利用者、担当者、事業への影響まで見通すことが欠かせません。
具体例による使い分け
続いては実務での具体例を通じて使い分けを確認していきます。
医療診断とスクリーニング
病気の可能性がある人を早期に見つけるスクリーニング検査では、再現率が重要になりやすい場面です。
本当に病気がある人を陰性と判定してしまう偽陰性は、治療の遅れにつながるおそれがあります。
そこで初期検査では広く候補を拾い、陽性者に精密検査を行う設計が採用されることがあります。
精密検査では、必要のない治療や不安を減らすために、適合率も重視されます。
このように検査の段階を分けると、再現率と適合率を別々の目的で活用できます。
一次判定では見逃しを抑え、二次判定では誤検知を減らす考え方が代表例です。
迷惑メールと不正利用検知
迷惑メールフィルタでは、迷惑メールを見逃すと利用者の負担が増えます。
しかし通常メールを迷惑メール扱いにすると、大切な連絡を見落とす危険があります。
特に請求書、認証コード、取引先からの連絡を誤って隔離した場合、影響は小さくありません。
そのため、迷惑メール判定では高い適合率が求められるケースも多くあります。
一方で、カードの不正利用検知では、少し疑わしい取引も候補として通知し、本人確認で絞り込む運用が考えられます。
この場合は再現率を高める価値が大きく、後段の確認手順で適合率の弱点を補います。
| 利用場面 | 優先しやすい指標 | 主な理由 |
|---|---|---|
| 一次医療検査 | 再現率 | 病気の見逃しを減らすため |
| 精密診断 | 適合率 | 不要な処置を減らすため |
| 迷惑メール判定 | 適合率 | 重要メールの誤隔離を防ぐため |
| 不正利用の一次検知 | 再現率 | 不正取引を広く確認するため |
| 求人候補の推薦 | 両方 | 候補の質と候補漏れを両立するため |
画像認識と品質検査
工場の外観検査では、傷や欠けなどの不良品を検出する画像認識が使われます。
不良品を良品として出荷することは避けたいため、再現率を重視する必要があります。
ただし再現率だけを追求すると、良品まで不良品として弾く件数が増えるかもしれません。
廃棄や再検査に大きな費用がかかる場合は、適合率も無視できません。
実務では、AIが不良候補を抽出し、判定が難しいものだけを担当者が確認する仕組みが有効です。
自動判定だけで完結させず、人による確認工程を組み合わせると、適合率と再現率のトレードオフを緩和できます。
許容できる誤検知数と見逃し数を事前に決め、現場データで継続的に検証することが重要です。
評価指標と改善方法
続いては適合率と再現率を評価し改善する方法を確認していきます。
F値による総合評価
適合率と再現率のどちらか一方だけでは、モデルの特徴を十分に比較できないことがあります。
そこで利用される代表的な総合指標がF値です。
F値は、適合率と再現率の調和平均として計算されます。
F値は、2 × 適合率 × 再現率 ÷ 適合率と再現率の合計で求められます。
両方の値が高いとF値も高くなり、どちらか一方が低いと大きく下がる仕組みです。
たとえば適合率が95パーセントでも、再現率が20パーセントなら、全体のバランスが良いとはいえません。
F値は、適合率と再現率を同時に改善したいときの比較材料になります。
ただし、見逃しと誤検知の重みが大きく異なる業務では、F値だけに頼らない判断が必要です。
目的別に重みを変える考え方
再現率をより重視したい場合には、F値の考え方を拡張したFベータ値を利用できます。
ベータを大きくすると再現率に重みを置き、ベータを小さくすると適合率を重視する評価になります。
たとえば安全確認や疾病の早期発見では、再現率を優先した指標が役立つでしょう。
一方で、広告配信や高コストの営業リストでは、適合率を重視する評価が適しています。
評価指標はモデルの優劣を決めるためだけではなく、運用上の優先順位を共有するための言葉でもあります。
数式の選択は、現場で許容できない失敗を明確にする作業と考えると理解しやすくなります。
データと運用を見直す改善策
適合率と再現率を改善するには、まず誤判定の内容を確認します。
偽陽性が多いなら、対象外の特徴を学習データへ十分に含めることが有効です。
偽陰性が多いなら、見逃されやすい対象の事例を集め、ラベルの正確さも点検します。
しきい値の変更だけでなく、入力データの品質、特徴量、教師データの偏り、判定ルールを見直す視点が求められます。
また、導入後にデータの傾向が変わることもあります。
定期的に適合率と再現率を測定し、業務の変化に合わせて基準を更新する運用が重要です。
評価は導入前の一度きりではなく、継続的な改善サイクルとして扱うことが大切です。
まとめ
適合率は、対象と判定した結果のうち、どれだけ正しかったかを示す指標です。
再現率は、本来対象であるものをどれだけ取りこぼさずに見つけられたかを示します。
適合率を優先すると誤検知を減らしやすく、再現率を優先すると見逃しを減らしやすくなります。
両者にはトレードオフがあるため、どちらが高いかだけで評価を終えるべきではありません。
誤検知と見逃しのどちらが大きな損失になるかを整理し、業務目的に合うしきい値と評価指標を選ぶことが重要です。
混同行列、F値、実際の運用コストを合わせて確認すれば、検索、機械学習、医療、品質検査などで適切な判断につなげられるでしょう。